
SAP Modelagem HANA: Visões, Tabelas e Modelos de Dados
 Equipe editorial
⚡ Resumo Inteligente
SAP A modelagem do HANA cria visualizações de informações que remodelam tabelas de banco de dados brutas em modelos prontos para uso comercial. Visualizações de atributos, analíticas e de cálculo, estrutura de pacotes, privilégios necessários e regras de desempenho são abordados com padrões de nomenclatura práticos.
O que é a SAP Modelagem HANA?
SAP A modelagem HANA é uma atividade que permite criar uma visão de informações. Uma visão de informações é semelhante a uma dimensão, um cubo ou um InfoProvider no BW. Essa visão de informações é usada para criar o modelo de dados multidimensional.
As mesas físicas dentro SAP HANA As tabelas armazenam os dados no formato em que foram fornecidos pelo sistema de origem. A modelagem adiciona uma camada acima dessas tabelas que renomeia colunas, une registros relacionados, aplica filtros e define cálculos. As ferramentas de geração de relatórios leem essa camada em vez das tabelas, de modo que os usuários de negócios nunca precisam conhecer a estrutura subjacente das tabelas.
SAP Visão geral da modelagem HANA
A modelagem é uma atividade na qual o usuário refina ou segmenta os dados em uma tabela de banco de dados, criando uma visão das informações com base no cenário de negócios. Essas visões de informações podem ser usadas para fins de geração de relatórios e tomada de decisões.
Uma visão da informação é criada a partir de várias combinações de dados de conteúdo para gerar um modelo para um cenário de negócios.
Os dados de conteúdo em uma visualização de informações são de dois tipos:
- Atributo: DescriptDados variáveis e não mensuráveis. Por exemplo, ID do fornecedor, nome do fornecedor, cidade, etc.
- A medida: Dados que podem ser quantificados e calculados. Por exemplo, RevUnidade, Quantidade Vendida e Contadores. Uma medida é derivada de uma visão analítica e de uma visão de cálculo. Uma medida não pode ser criada em uma visão de atributo.
Ambos os blocos de construção são definidos uma única vez dentro da visualização e reutilizados por todos os relatórios que a utilizam. As seções abaixo listam as variantes exatas. SAP O HANA oferece suporte para cada um deles.
Tipos de Atributo
SAP O HANA suporta três tipos de atributos:
| Tipos de atributos | Atividades |
|---|---|
| Atributo Simples | É derivado da base de dados. |
| Atributo Calculado | É derivado de um ou mais atributos e constantes existentes. Por exemplo, um cálculo aritmético ou a derivação do nome completo a partir do primeiro e último nome. |
| Atributo Local | É utilizado dentro das vistas de modelagem (vista analítica ou vista de cálculo) para personalizar o comportamento de um atributo, sendo, portanto, local ao modelo. modelagem vista e não pode ser acessada de fora dessa vista. |
Tipos de Medida
SAP O HANA suporta quatro tipos de medidas:
| Tipos de Medidas | Atividades |
|---|---|
| Medida Simples | É derivado da base de dados. |
| Medida Calculada | É derivado de uma ou mais medidas, constantes e funções existentes. Por exemplo, um cálculo aritmético. |
| Medida Restrita | É utilizado para filtrar valores com base em regras definidas pelo usuário para valores de atributos. |
| Contador | É um tipo especial de coluna que exibe um número único para colunas de atributos (visão analítica ou visão de cálculo). Ela é usada para contar uma ou mais colunas de atributos. |
Uma vez definidos os atributos e as métricas, eles são reunidos em uma das três visões de informação:
- Visualização de atributos – Isso é usado para contexto de dados mestre.
- Visão analítica – Isso é usado para criar tabelas de fatos e é semelhante a um Cubo no BW.
- Visualização de cálculo – Isso é usado para criar uma visualização complexa e é semelhante a um MultiProvider no BW.
Antes que qualquer uma dessas visualizações possa ser criada, a conta do modelador precisa de um conjunto específico de autorizações.
Privilégios necessários para modelagem
Os privilégios proporcionam segurança ao SAP Banco de dados HANA, por meio do qual um usuário autorizado pode acessar apenas conteúdo autorizado.
Privilégios de objeto
Os privilégios de objeto são SQL Privilégios usados para fornecer acesso de leitura/gravação a objetos do banco de dados. Os privilégios de objeto abaixo são necessários para a modelagem.
- Privilégio SELECT no esquema _SYS_BI.
- Privilégio SELECT no esquema _SYS_BIC.
- Privilégio EXECUTE em REPOSITORY_REST (SYS).
- Privilégio SELECT no esquema da tabela.
Privilégios do pacote
São necessárias permissões de pacote para autorizar ações em pacotes individuais. As permissões de pacote abaixo são necessárias para a modelagem de dados.
- Privilégio REPO.MAINTAIN_NATIVE_PACKAGES no pacote raiz.
- REPO.READ, REPO.EDIT_NATIVE_OBJECTS e REPO.ACTIVATE_NATIVE_OBJECTS no pacote usado para objetos de conteúdo.
Privilégios analíticos
Para acessar um SAP Visualização de informações do HANA, privilégios analíticos é requerido.
- Para ter acesso completo a todos os dados e visualizar todas as informações em um SAP No sistema HANA, é necessário o privilégio analítico “_SYS_BI_CP_ALL”. Para acesso restrito aos dados, é preciso criar e atribuir privilégios analíticos ao usuário.
Outros Privilégios
- Conceda acesso ao seu próprio esquema ao usuário _SYS_REPO como 'GRANT SELECT ON SCHEMA “Nome do esquema” TO _SYS_REPO WITH GRANT OPTION';
- REPO.MAINTAIN_DELIVERY_UNITS para criar unidades de entrega.
- REPO.IMPORT e REPO.EXPORT para importação e exportação de unidades de entrega.
- REPO.WORK_IN_FOREIGN_WORKSPACES para trabalhar em espaços de trabalho externos.
Diferença entre a Visão de Atributos, a Visão Analítica e a Visão de Cálculo
As três visões de informação não são intercambiáveis. Cada uma responde a uma pergunta diferente, e escolher a errada é o erro mais comum que os iniciantes em modelagem cometem.
| Critérios | Visualização de atributos | Visão analítica | Visualização de cálculo |
|---|---|---|---|
| Propósito | Dados mestres e contexto descritivo | Esquema em estrela em uma única tabela de fatos | Lógica complexa em múltiplas fontes |
| Medidas permitidas | Não | Sim | Sim |
| Número de tabelas de fatos | Não aplicável | completa | Muitos |
| Apoio sindical | Não | Não | Sim |
| Pode consumir outras visualizações | Não | Somente visualizações de atributos | Todos os três tipos |
| Equivalente de peso corporal | Característica/dimensão | InfoCube | Multiprovedor |
Uma regra prática funciona bem: construa um visualização de atributos quando a saída é uma lista descritiva, um visão analítica quando uma tabela de fatos é comparada com essas descrições, e uma vista de cálculo Quando a resposta exige uma união, uma segunda tabela de fatos ou uma lógica que um esquema em estrela não consegue expressar.
SAP HANA Melhor Práticas para Criação de Modelos de Informação
An SAP As melhores práticas do HANA são um padrão seguido ao criar um objeto no SAP Banco de dados HANA. As melhores práticas abaixo se aplicam a cada tipo de objeto.
PACOTE:
- Crie um pacote de nível superior, como "Desenvolvimento", para o trabalho de desenvolvimento.
- Crie um subpacote dentro do pacote de nível superior para cada desenvolvedor.
- Se necessário, também é possível criar mais subpacotes.
CRONOGRAMA:
- Elabore o layout do seu esquema antes do início do projeto. Por exemplo, DS_SCHEMA, SLT_SCHEMA, FI_SCHEMA, SD_SCHEMA, etc.
- As tabelas personalizadas devem estar em um esquema separado.
TABELAS:
- Uma tabela que será usada em relatórios ou OLAP deve ser do tipo de armazenamento em coluna.
- Uma tabela que será usada em transações ou OLTP deve ser do tipo de armazenamento em linha.
- Para maior clareza, forneça um comentário ou descrição adequada para a tabela e os nomes das colunas.
CONVENÇÃO DE NOMES:
| OBJETOS | Formato | Descrição |
|---|---|---|
| VISUALIZAÇÕES DE ATRIBUTOS | AT_PRODUTOS | AT_ significa visualização de atributos |
| VISÕES ANALÍTICAS | AN_VENDAS | AN_ significa visão analítica |
| VISUALIZAÇÕES DE CÁLCULO | CA_VENDAS | CA_ significa visualização de cálculo |
| PRIVILÉGIOS ANALÍTICOS | AP_REST_AT (Visão de Atributo) AP_REST_AN (Visão Analítica) AP_REST_CA (Visão de Cálculo) |
AP_ significa privilégios analíticos |
| HIERARQUIA | HI_BNAME_PC (Pai Filho) HI_BNAME_LV (Nível) |
HI_ significa hierarquia |
| PROCEDIMENTO | SP_PROCEDURENAME | SP_ significa procedimento armazenado |
| PARÂMETROS DE ENTRADA | IP_PARA_NAME | IP_ significa parâmetro |
| VARIÁVEIS | VA_VNAME | VA_ significa nome da variável |
A convenção de nomenclatura só compensa se cada modelo estiver dentro de uma estrutura de pacotes planejada, que é criada conforme mostrado a seguir.
Criando um pacote em SAP Estúdio HANA
Pacote: É um contêiner que armazena todas as informações sobre o modelo (visão de atributos, visão analítica, visão de cálculo, etc.) em um grupo.
Tipos de pacote: Existem dois tipos de embalagens, conforme descrito abaixo.
| Formato | Descrição | ícone |
|---|---|---|
| Estrutural | Em um pacote estrutural, somente um subpacote pode ser criado. Nenhuma visualização de informações (visualização de atributos, visualização analítica, etc.) pode ser criada em um pacote estrutural. Exemplos de um pacote estrutural são SAP, system-local, system-local.generated e system-local.private. |
|
| Não estrutural | Um pacote não estrutural pode conter objetos de informação e subpacotes. Este é o pacote padrão. |
|


Usos de uma embalagem: Um pacote agrupa todos os modelos de informação e facilita o transporte dos modelos. Ambos os tipos de pacote podem ser usados no transporte.
Etapas para criar um pacote estrutural em SAP Estúdio HANA:
Passo 1) Nesta etapa,
- Selecione o sistema HANA, neste caso é o HDB.
- Acesse a pasta Conteúdo.

Passo 2) Nesta etapa,
- Selecione Novo.
- Selecione a opção Pacote.

Passo 3) Nesta etapa,
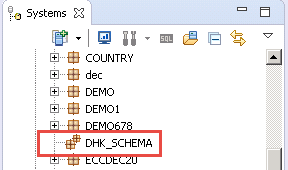
- Digite o nome do pacote. Por exemplo, “DHK_SCHEMA”.
- Insira uma descrição para o pacote.
- O idioma original e a pessoa responsável são selecionados por padrão.

Um pacote não estrutural com o nome “DHK_SCHEMA” será criado no nó de Conteúdo, conforme abaixo.

Passo 4) Agora, converta o pacote não estrutural em um pacote estrutural.
- Selecione o pacote “DHK_SCHEMA” e clique com o botão direito do mouse sobre ele.
- Acesse a opção Editar do pacote.

Passo 5) Nesta etapa,
- Selecione “Sim” no campo Opções Estruturais.
- Clique no botão OK.

Quando “DHK_SCHEMA” é alterado de um pacote não estrutural para um pacote estrutural, o estilo do ícone muda de  para
 Isso indica que o pacote não estrutural foi convertido em um pacote estrutural.
Passos para criar um pacote não estrutural como subpacote de um pacote estrutural:
Por padrão, um pacote é criado como não estrutural. Em um pacote não estrutural, outros pacotes e objetos de informação podem ser criados. É recomendável criar primeiro um pacote estrutural e, em seguida, criar um subpacote dentro dele.
Passo 1) Nesta etapa,
- Selecione o pacote estrutural “DHK_SCHEMA” e clique com o botão direito do mouse sobre ele.
- Selecione Novo -> Pacote.

Passo 2) Nesta etapa,
- Insira o nome do subpacote no campo Nome.
- Insira uma descrição para isso.
- Clique no botão “OK”.

Um novo pacote não estrutural será criado como um subpacote dentro do pacote DHK_SCHEMA.

Como ativar e validar uma visualização de informações
Salvar uma visualização apenas a armazena no repositório de tempo de design. Até que seja ativada, nenhum objeto de tempo de execução existe e nenhum relatório pode lê-la. A ativação gera uma visualização de coluna no esquema _SYS_BIC, e esse objeto gerado é o que as ferramentas de SQL e de geração de relatórios realmente consultam.
Passo 1) Salve a visualização. Pressione Ctrl+S em SAP HANA Studio. A visualização agora existe como um objeto inativo em tempo de design, marcado com uma sobreposição de losango no nó Conteúdo.
Passo 2) Ative a visualização. Clique com o botão direito do mouse na visualização e selecione Ativar ou pressione Ctrl+F3. Escolha “Ativar” para implantar somente esta visualização ou “Reimplantar” para recriar o objeto de tempo de execução quando a definição de tempo de design não tiver sido alterada, mas o objeto gerado estiver ausente.
Passo 3) Leia o registro de tarefas. A visualização do Log de Tarefas registra o sucesso ou a falha de cada objeto no lote de ativação. Uma entrada de falha nomeia o objeto e o motivo, portanto, sempre expanda a entrada em vez de confiar na linha de resumo.
Passo 4) Visualize os dados. Clique com o botão direito do mouse na visualização ativada e selecione Visualização de Dados. A guia Análise permite arrastar atributos para o eixo de rótulos e medidas para o eixo de valores, o que confirma que as junções retornam o número esperado de linhas.
Etapa 5) Resolva erros comuns de ativação. Na maioria dos casos, são causadas três falhas:
- Privilégios insuficientes no esquema: O repositório _SYS_REPO não possui a permissão SELECT WITH GRANT OPTION no esquema que contém as tabelas base. Conceda a permissão e ative-o novamente.
- Nome de coluna inválido: Uma coluna da tabela base foi renomeada ou removida após a modelagem da visualização. Atualize a base de dados e remapeie o campo.
- Dependência cíclica: Duas visualizações fazem referência uma à outra. Quebre o loop apontando uma delas para a tabela subjacente.
Após uma ativação bem-sucedida, a visualização pode ser consultada diretamente com SELECT * FROM “_SYS_BIC”.package/VIEW_NAME”, que é a maneira mais rápida de confirmar se o objeto existe antes que uma ferramenta de relatório seja conectada a ele.
SAP Técnica de otimização de desempenho HANA
Uma visualização ativada que retorna resultados corretos ainda pode ser lenta. As regras abaixo definem como o mecanismo de cálculo executa o modelo.
- Todas as visualizações de informações e visualizações de tabela devem ser usadas com um nó de projeção. Um nó de projeção melhora o desempenho ao restringir o conjunto de colunas.
- Aplicar filtros nos nós de projeção.
- Evite nós de junção em uma visualização de cálculo e use uma união sempre que possível.
- Utilize parâmetros ou variáveis de entrada para restringir o conjunto de dados dentro de uma visualização analítica ou de cálculo.
- Os cálculos devem ser feitos antes da agregação.
- As hierarquias precisam ser redefinidas em uma visualização de cálculo, porque as hierarquias de uma visualização de atributos não são visíveis em uma visualização de cálculo.
- As hierarquias de uma visão de atributos são visíveis em uma visão analítica.
- Os rótulos dos atributos e as descrições das medidas definidas em uma visualização de atributos, visualização analítica ou visualização de cálculo não serão exibidos em uma visualização de cálculo que os utilize. Eles precisam ser remapeados.
- Não misture funções CE e SQLScript no mesmo modelo de informação.
O design da junção também afeta o custo de tempo de execução. Uma junção referencial pode ser completamente eliminada quando nenhum campo da tabela correta é solicitado, e é por isso que... seleção do tipo de junção Merece tanta atenção quanto o posicionamento dos nós.
Por que as visualizações de cálculo substituíram as visualizações de atributos e analíticas?
SAP visualizações de atributos e visualizações analíticas obsoletas, juntamente com o modelo XS Classic e o SAP Repositório HANA. A descontinuação foi anunciada para SAP HANA 1.0 SPS 12 e reformulado para SAP HANA 2.0 SPS 02. Obsoleto significa ainda suportado em SAP HANA 2.0, mas não foi implementado em SAP HANA Cloud.
A razão é a consolidação, e não a substituição de funções. Pacotes de suporte sucessivos expandiram as visões de cálculo até absorverem as capacidades dos outros dois tipos:
- Uma visão de cálculo da categoria de dados Dimensão, com um nó de projeção na camada semântica, realiza o trabalho de uma visão de atributo.
- Uma visão de cálculo da categoria de dados Cubo Com uma junção em estrela, com um nó de agregação na camada semântica, realiza-se o trabalho de uma visão analítica.
Um tipo de visualização também significa um caminho de otimização, um conjunto de padrões de modelagem a serem aprendidos e um destino de migração. SAP O sistema fornece uma ferramenta de migração que converte visualizações de atributos, visualizações analíticas e visualizações de cálculo baseadas em script existentes em visualizações de cálculo gráficas e funções de tabela. As visualizações existentes continuam a funcionar, permitindo que a migração seja agendada em vez de apressada, mas o novo desenvolvimento deve começar com visualizações de cálculo.
