
SAP HANA ArchiVisão geral do banco de dados
 Pedreiro Garcia
⚡ Resumo Inteligente
SAP HANA ArchiA arquitetura, o ambiente e o dimensionamento formam a base de uma plataforma de dados em memória construída sobre o SUSE Linux e C++Este artigo explica o servidor de índice, os mecanismos de armazenamento, os armazenamentos em linhas e colunas, a mesclagem delta e os métodos de dimensionamento de hardware.
O que é a SAP Banco de dados HANA?
SAP O HANA é uma plataforma de gerenciamento de dados centrada na memória principal. O banco de dados é executado no SUSE Linux Enterprise Server (SLES) e Red Hat Enterprise Linux (RHEL) e está escrito em C++Ele pode ser dimensionado horizontalmente em várias máquinas para cargas de trabalho muito grandes.
Principais vantagens de SAP HANA:
- Desempenho de consulta extremamente rápido porque todos os dados são carregados na memória, eliminando a E/S lenta do disco do caminho crítico.
- Processamento combinado de OLAP (Processamento Analítico Online) e OLTP (Processamento de Transações Online) no mesmo banco de dados, simplificando o panorama de dados.
SAP O banco de dados HANA é construído a partir de um conjunto de mecanismos de processamento em memória. O mecanismo de cálculo é o principal e interage com outros mecanismos, como o mecanismo relacional (armazenamento de linhas e colunas), o mecanismo OLAP, o mecanismo de texto e o mecanismo de grafos. Uma tabela relacional reside no armazenamento de linhas ou no armazenamento de colunas, e mecanismos adicionais processam dados de texto e grafos enquanto houver memória disponível.
SAP HANA Archiarquitetura
Os dados no armazenamento em colunas são compactados usando técnicas como codificação de dicionário, codificação por comprimento de execução, codificação esparsa, codificação de cluster e codificação indireta. Quando o limite da memória principal é atingido, os objetos do banco de dados que não estão em uso (tabelas, visualizações, etc.) são descarregados automaticamente para o disco e recarregados quando solicitados novamente.
Os administradores também podem carregar ou descarregar uma tabela individualmente, clicando com o botão direito do mouse na tabela. SAP HANA Studio e escolhendo descarregar or Ver.
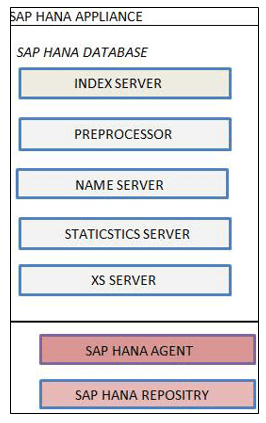
SAP O servidor HANA consiste em:
- Servidor de indexação
- Servidor pré-processador
- Name Server
- Servidor de Estatísticas
- Motor XS
1. SAP Servidor de índice HANA
O servidor de índice é o principal SAP Componente de banco de dados HANA:
- É o coração do SAP Mecanismo de banco de dados HANA.
- Contém os repositórios de dados reais e os mecanismos que processam os dados.
- Ele executa instruções SQL e MDX recebidas.
A arquitetura do servidor de índice é mostrada abaixo.

SAP Visão geral do servidor de índice HANA
- Gerenciador de sessões e transações: O componente Sessão gerencia as conexões e sessões do banco de dados. O Gerenciador de Transações coordena e controla todas as transações.
- Processador SQL e MDX: O processador SQL envia consultas para o mecanismo apropriado (SQL / SQL Script / R / mecanismo de cálculo). O processador MDX lida com consultas multidimensionais (por exemplo, em uma visão analítica).
- SQL / SQL Script / R / Mecanismo Calc: Executa SQL, SQL Script, R e modelos de cálculo com base nos dados.
- Repositório: Mantém o controle de versões para SAP Objetos de metadados do HANA, como visualizações de atributos, visualizações analíticas e procedimentos armazenados.
- Camada de persistência: Oferece capacidade integrada de recuperação de desastres, gravando pontos de salvamento e registros no volume de dados em disco.
2. Servidor de pré-processamento
O servidor de pré-processamento é usado pela análise de texto. Ele extracO sistema prepara os dados a partir do conteúdo textual quando a função de busca é invocada.
3. Servidor de nomes
O servidor de nomes armazena informações sobre toda a arquitetura do sistema. Em uma implantação distribuída, ele tracO sistema armazena todos os componentes em execução e a localização dos dados entre os nós, para que as consultas possam ser encaminhadas para o servidor correto.
4. Servidor de Estatísticas
O Servidor de Estatísticas coleta dados de status, alocação de recursos, consumo e desempenho para o SAP Sistema HANA. Observação: no HANA SPS 7 e versões posteriores, o serviço de estatísticas integrado é executado dentro do servidor de índice, em vez de como um processo independente.
5. Servidor XS
O servidor XS hospeda o mecanismo XS, que permite que aplicativos e desenvolvedores externos consumam o conteúdo. SAP Banco de dados HANA via HTTP. O próprio XS Engine atua como um servidor HTTP leve, permitindo que clientes baseados em navegador e REST se comuniquem diretamente com o HANA.
SAP Paisagem HANA
“HANA” significa Aparelho analítico de alto desempenho e é fornecida como uma plataforma combinada de hardware e software.
- O hardware moderno oferece muito mais núcleos de CPU, RAM e largura de banda de armazenamento do que os servidores de banco de dados legados foram projetados para usar.
- SAP O HANA explora isso por meio do keeping Todos os dados de trabalho ficam armazenados na memória principal, eliminando o gargalo de E/S de disco que limita os bancos de dados tradicionais.
O diagrama abaixo resume o SAP Inovações de hardware e software do HANA.

SAP O HANA suporta dois armazenamentos de dados relacionais: Loja de linha e Armazenamento de colunas.
Loja de linha
Row Store se comporta como um banco de dados tradicional (Oracle, SQL Server). A principal diferença é que todas as linhas residem na memória principal em SAP O HANA, enquanto um banco de dados tradicional os mantém principalmente em disco.
Armazenamento de colunas
O Column Store mantém os dados em formato de colunas na memória. As tabelas de colunas são armazenadas aqui e o mecanismo equilibra um bom desempenho de gravação com um desempenho de leitura otimizado. O diagrama abaixo mostra as duas estruturas que alcançam esse equilíbrio.

Armazenamento principal
O armazenamento principal contém a maior parte dos dados. Métodos de compressão como codificação de dicionário, codificação de cluster, codificação esparsa e codificação de comprimento de execução são aplicados para economizar memória e acelerar as buscas.
- Modificar dados compactados diretamente no armazenamento principal é dispendioso, portanto, as gravações não têm como alvo o armazenamento principal.
- Em vez disso, cada alteração é escrita em uma área separada chamada Delta ArmazenamentoAs leituras podem acessar o armazenamento principal ou o armazenamento delta.
Os dados podem ser carregados ou descarregados manualmente usando o Carregar na memória e Descarregar da memória Opções mostradas abaixo.

Delta Armazenamento
Delta O armazenamento é otimizado para gravações e utiliza uma compressão mais leve. Todas as alterações não confirmadas em uma tabela de colunas são mantidas aqui. Quando as alterações precisam ser mescladas de volta ao armazenamento principal, execute o seguinte comando: Delta ir operação de SAP Estúdio Hana.

- A mesclagem delta move as alterações coletadas no armazenamento delta para o armazenamento principal.
- Após a fusão, o novo conteúdo do armazenamento principal é persistido no disco e a compressão é recalculada.
Como os dados se movem de Delta para o armazenamento principal

Um buffer organizado em linhas chamado L1-Delta Fica na frente de cada tabela de colunas, razão pela qual uma tabela de colunas pode absorver gravações de alto volume.
- O usuário executa um comando UPDATE ou INSERT na tabela.
- Os dados chegam primeiro à camada 1-Delta (dados não confirmados).
- Uma vez confirmados, os dados são movidos para a camada 2 orientada a colunas.Delta tampão.
- Quando L2-Delta Quando a memória estiver cheia ou a mesclagem for executada, os dados serão gravados no armazenamento principal.
O armazenamento em colunas é, portanto, otimizado tanto para escrita (através das camadas L1 e L2 delta) quanto para leitura (através do armazenamento principal). Após o processamento, os dados são persistidos em disco pela Camada de Persistência.
Exemplo de uma tabela baseada em linhas:

A mesma tabela lógica é armazenada em disco de forma diferente dependendo do tipo de armazenamento. No Row Store, as linhas são gravadas de forma contígua:

No Column Store, os valores da mesma coluna são armazenados juntos:

Como os valores das colunas compartilham o mesmo tipo de dados e frequentemente se repetem, o layout das colunas se compacta extremamente bem — o que é a principal vantagem de memória do armazenamento em colunas.

SAP Dimensionamento HANA
Dimensionamento é o processo de determinar os recursos de hardware — RAM, disco e CPU — necessários para um sistema. SAP Sistema HANA. A memória é o fator mais importante, a CPU vem em segundo lugar e o disco deriva dos dois primeiros.
Em um artigo do SAP Na implementação do HANA, selecionar o tamanho de servidor adequado à carga de trabalho da empresa é uma das tarefas mais críticas. Comparado a um SGBD tradicional, o dimensionamento do HANA difere em três áreas:
- Memória principal: Impulsionado por metadados, além do volume de dados transacionais e analíticos armazenados na memória.
- CPU: Estimado em vez de medido, com base em previsões de consultas e padrões de carga.
- Disco: Dimensionado para persistência de dados e volumes de logs, não para dados de consultas online.
O uso de CPU e memória pelo servidor de aplicativos permanece inalterado em comparação com o banco de dados anterior, pois o HANA substitui apenas a camada de banco de dados.
SAP Oferece diversos métodos para calcular o tamanho correto:
- Dimensionamento usando um relatório ABAP (código de transação) ST03 dados e relatório /SDF/HDB_SIZEING).
- Dimensionamento usando um script de banco de dados para sistemas não-ABAP.
- Dimensionamento usando o SAP Medidor rápido ferramenta no SAP Mercado de serviços.
Ao utilizar a ferramenta Quick Sizer, a necessidade é exibida no formato abaixo.

