
Modelo de dados relacional em SGBD: Concepts & Exemplo
 Equipe editorial
⚡ Resumo Inteligente
O modelo relacional representa um banco de dados como uma coleção de relações, onde cada relação é uma tabela de linhas e colunas. Ele define conceitos fundamentais, restrições de integridade e operações de atualização que mantêm os dados relacionais consistentes e fáceis de consultar.
O que é o modelo relacional?
Modelo Relacional (RM) representa o banco de dados como uma coleção de relações. Uma relação nada mais é do que uma tabela de valores. Cada linha da tabela representa uma coleção de valores de dados relacionados. Essas linhas da tabela denotam uma entidade ou relacionamento do mundo real.
O nome da tabela e os nomes das colunas ajudam a interpretar o significado dos valores em cada linha. Os dados são representados como um conjunto de relações. No modelo relacional, os dados são armazenados como tabelas. No entanto, o armazenamento físico dos dados é independente da forma como os dados estão organizados logicamente.
O modelo foi proposto por E.F. Codd em 1970 e continua sendo a base de quase todos os bancos de dados convencionais em uso atualmente. Alguns sistemas populares de gerenciamento de bancos de dados relacionais são:
- Servidor Dinâmico DB2 e Informix – IBM
- Oracle e RDB – Oracle
- SQL Server e Acesso – Microsoft
Modelo Relacional Concepts em SGBD
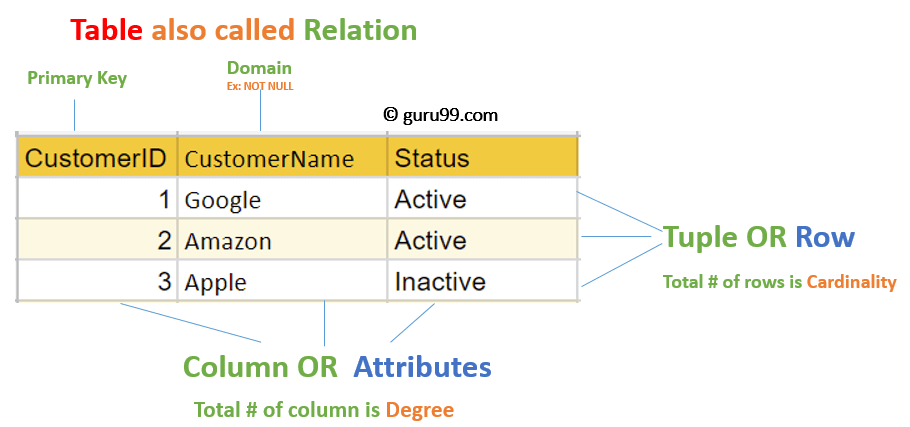
- Atributo: Cada coluna em uma tabela. Os atributos são as propriedades que definem uma relação, por exemplo, Número_de_Matrícula_do_Aluno, NOME, etc.
- Tabelas: No modelo relacional, as relações são armazenadas em formato de tabela. Elas são armazenadas juntamente com suas entidades. Uma tabela possui duas propriedades: linhas e colunas. As linhas representam registros e as colunas representam atributos.
- Tupla: Não é nada mais do que uma única linha de uma tabela, que contém um único registro.
- Esquema de relação: Um esquema de relação representa o nome da relação com seus atributos.
- Grau: O número total de atributos na relação é chamado de grau da relação.
- Cardinalidade: O número total de linhas presentes na tabela.
- Coluna: A coluna representa o conjunto de valores para um atributo específico.
- Instância de relação: Uma instância de relação é um conjunto finito de tuplas em um sistema de gerenciamento de banco de dados relacional (SGBDR). Instâncias de relação nunca possuem tuplas duplicadas.
- Chave de relação: Cada linha possui um, dois ou mais atributos, que são chamados de chave de relacionamento.
- Domínio do atributo: Cada atributo possui um valor e um escopo predefinidos, conhecidos como domínio do atributo.
Com o vocabulário definido, a próxima preocupação é manter...ping Os dados nessas relações são válidos, o que é função das restrições de integridade.
Relacional Integrity restrições
As restrições de integridade relacional em SGBDs referem-se às condições que devem estar presentes para que uma relação seja válida. Essas restrições relacionais são derivadas das regras do micromundo que o banco de dados representa.
Existem muitos tipos de restrições de integridade. As restrições em um sistema de gerenciamento de banco de dados relacional são geralmente divididas em três categorias principais:
- Restrições de domínio
- Restrições principais
- referencial Integrity restrições
Restrições de domínio
As restrições de domínio podem ser violadas se o valor de um atributo não estiver presente no domínio correspondente ou se não for do tipo de dados apropriado.
As restrições de domínio especificam que, dentro de cada tupla, o valor de cada atributo deve ser atômico e proveniente do domínio correto. Os domínios são especificados como tipos de dados, que incluem tipos padrão como inteiros, números reais, caracteres, booleanos e strings de comprimento variável.
Exemplo:
CREATE DOMAIN CustomerName
CHECK (value NOT NULL)
O exemplo apresentado demonstra a criação de uma restrição de domínio de forma que CustomerName não seja NULL.
Restrições principais
Um atributo que pode identificar exclusivamente uma tupla em uma relação é chamado de chave da tabela. O valor do atributo para diferentes tuplas na relação deve ser único.
Exemplo:
Na tabela fornecida, CustomerID é um atributo chave da tabela Customer. É muito provável que haja uma única chave para cada cliente; CustomerID = 1 corresponde apenas ao CustomerName.GoogleUma análise completa dos diferentes tipos de chaves é abordada no guia. Chaves do SGBD.
| Identificação do Cliente | Nome do cliente | Status |
|---|---|---|
| 1 | Ativo | |
| 2 | Amazon | Ativo |
| 3 | Apple | Inativo |
referencial Integrity restrições
As restrições de integridade referencial em SGBDs baseiam-se no conceito de chaves estrangeiras. Uma chave estrangeira é um atributo importante de uma relação que deve ser referenciado em outras relações. Uma restrição de integridade referencial ocorre quando uma relação se refere a um atributo chave de uma relação diferente ou da mesma relação. Esse elemento chave deve existir na tabela referenciada.
Exemplo:

No exemplo acima, temos duas relações: Cliente e Billing.
A tupla para CustomerID = 1 é referenciada duas vezes na relação. Billing. Então sabemos CustomerName “Google"tem um valor de faturamento de $300."
Operações no Modelo Relacional
Quatro operações básicas de atualização são realizadas no modelo de banco de dados relacional: inserir, atualizar, excluir e selecionar.
- O comando Insert é usado para inserir dados na relação.
- Delete é usado para excluir tuplas da tabela.
- Modificar permite alterar os valores de alguns atributos em tuplas existentes.
- Selecionar permite que você escolha um intervalo específico de dados.
Sempre que uma dessas operações for aplicada, as restrições de integridade especificadas no esquema do banco de dados relacional nunca devem ser violadas.
inserção Operação
A operação de inserção fornece os valores dos atributos para uma nova tupla que deve ser inserida em uma relação.

Atualizar Operação
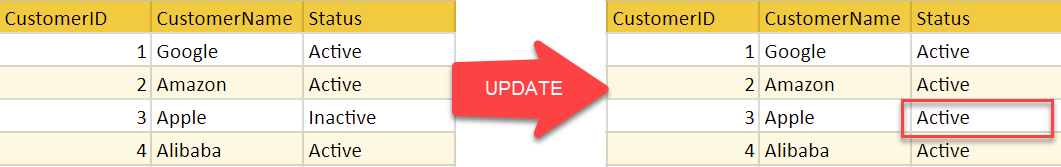
Você pode ver na tabela de relacionamento abaixo que o CustomerName 'Apple' foi atualizado de Inativo para Ativo.
Apagar Operação
Para especificar a exclusão, uma condição nos atributos da relação seleciona a tupla a ser excluída.

No exemplo acima, o nome do cliente “Apple” foi excluído da tabela.
A operação de exclusão pode violar a integridade referencial se a tupla excluída for referenciada por chaves estrangeiras de outras tuplas no mesmo conjunto de chaves. banco de dados.
Selecionar Operação

No exemplo acima, CustomerName “Amazon" é selecionado.
Modelo Relacional versus Modelos Hierárquicos e de Rede
O modelo relacional substituiu duas abordagens anteriores, e o contraste explica por que ele se tornou dominante. A tabela abaixo compara os três modelos lado a lado.
| Aspecto | Modelo Relacional | Modelo Hierárquico | Modelo de rede |
|---|---|---|---|
| Estrutura | Tabelas (relações) | Árvore, de pai para filho | Gráfico, muitos para muitos |
| Acesso de dados | Declarativo, por valor | Navegação, por caminho | Navegação por ponteiro |
| Relacionamentos | Chaves estrangeiras | Ligações pai-filho | Conjuntos e ponteiros |
| Linguagem de consulta | SQL | Código de procedimento | Código de procedimento |
| Flexibilidade | Alto | Baixo | Suporte: |
Como o modelo relacional aborda os dados por valor, em vez de navegar por vínculos físicos, uma linguagem de alto nível como SQL É possível expressar uma consulta sem saber como os dados estão armazenados.
Melhores práticas para criar um modelo relacional
- Os dados precisam ser representados como uma coleção de relações.
- Cada relação deve ser claramente representada na tabela.
- As linhas devem conter dados sobre instâncias de uma entidade.
- As colunas devem conter dados sobre os atributos da entidade.
- As células da tabela devem conter um único valor.
- Cada coluna deve receber um nome único.
- Não existem duas linhas idênticas.
- Os valores de um atributo devem ser do mesmo domínio.
Vantagens do Modelo de Banco de Dados Relacional
- Simplicidade: Um modelo de dados relacional em um SGBD é mais simples do que os modelos hierárquico e de rede.
- Independência estrutural: O banco de dados relacional preocupa-se apenas com os dados e não com a estrutura, o que pode melhorar o desempenho do modelo.
- Fácil de usar: O modelo relacional é fácil de usar, pois as tabelas compostas por linhas e colunas são naturais e simples de entender.
- Capacidade de consulta: Isso possibilita que uma linguagem de consulta de alto nível como o SQL evite a navegação complexa no banco de dados.
- Independência de dados: A estrutura de um banco de dados relacional pode ser alterada sem que seja necessário modificar nenhum aplicativo.
- Escalável: Com relação ao número de registros ou linhas e ao número de campos, um banco de dados pode ser ampliado para melhorar sua usabilidade.
Desvantagens do Modelo Relacional
- Poucos bancos de dados relacionais têm limites no comprimento dos campos, que não podem ser ultrapassados.
- Bancos de dados relacionais podem, por vezes, tornar-se complexos à medida que a quantidade de dados aumenta e as relações entre os dados se tornam mais complicadas.
- Sistemas complexos de bancos de dados relacionais podem levar a bancos de dados isolados, onde as informações não podem ser compartilhadas de um sistema para outro.
