
O que é Aprendizagem por Reforço? Tipos, Algorithms & Exemplo
 Evelyn Clarke
⚡ Resumo Inteligente
O aprendizado por reforço é um método de aprendizado de máquina no qual um agente de software aprende agindo dentro de um ambiente, coletando recompensas ou penalidades e ajustando seu comportamento para maximizar a recompensa cumulativa ao longo de várias etapas.
O que é Aprendizado por Reforço?
Aprendizagem por Reforço é um Machine Learning Método que trata de como agentes de software devem agir em um ambiente. O agente não recebe as respostas corretas; ele aprende com a recompensa que recebe e ajusta seu comportamento para maximizar a recompensa acumulada.
O aprendizado por reforço é um ramo do aprendizado de máquina por si só, ao lado de supervisionou e não supervisionado aprendizado. Quando a política ou função de valor do agente é representada por uma rede neural, a combinação é chamada de aprendizagem por reforço profundo — esse emparelhamento é o que permite a um agente atingir um objetivo complexo ou maximizar uma dimensão específica ao longo de várias etapas.
Componentes importantes do método de aprendizagem por reforço
Antes que os algoritmos façam sentido, é útil nomear as partes. O diagrama abaixo mostra como o agente, o ambiente, a ação e o sinal de recompensa se encaixam em um ciclo.
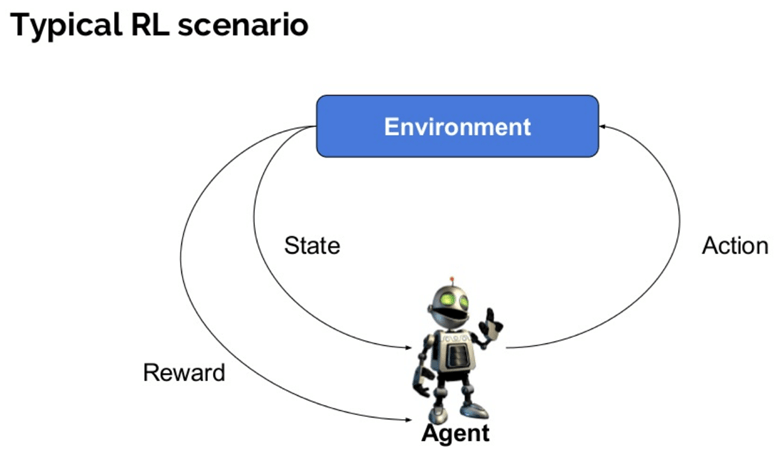
Aqui estão alguns termos importantes usados em Aprendizagem por Reforço:
- Agente: A entidade que realiza ações em um ambiente para obter alguma recompensa.
- Meio Ambiente (e): Um cenário que um agente deve enfrentar.
- Recompensa (R): Uma recompensa imediata dada a um agente quando este executa uma ação ou tarefa específica.
- Estado(s): Estado refere-se à situação atual devolvida pelo meio ambiente.
- Política (π): A estratégia aplicada pelo agente para decidir a próxima ação com base no estado atual.
- Valor (V): O retorno esperado a longo prazo com desconto, em comparação com a recompensa a curto prazo.
- Função de valor: Especifica o valor de um estado, ou seja, a quantidade total de recompensa que um agente pode esperar acumular a partir desse estado.
- Modelo do ambiente: Isso simula o comportamento do ambiente. Permite fazer inferências e também determinar como o ambiente se comportará.
- Métodos baseados em modelos: Métodos que resolvem problemas de aprendizado por reforço, primeiro aprendendo ou usando um modelo do ambiente e, em seguida, planejando com base nesse modelo.
- Valor Q ou valor de ação (Q): O valor Q é bastante semelhante ao valor. A única diferença entre os dois é que ele recebe um parâmetro adicional, a ação atual.
Como funciona o aprendizado por reforço?
Uma analogia do dia a dia torna o mecanismo claro antes mesmo de qualquer notação aparecer.
Imagine a situação em que você precisa ensinar novos truques ao seu gato.
- Como a gata não entende inglês nem qualquer outro idioma humano, não podemos dizer-lhe diretamente o que fazer. Em vez disso, seguimos uma estratégia diferente.
- Simulamos uma situação e o gato tenta reagir de várias maneiras diferentes. Se a reação do gato for a desejada, damos-lhe peixe.
- Agora, sempre que a gata se depara com a mesma situação, ela repete a mesma ação com ainda mais entusiasmo, na expectativa de receber mais recompensa (comida).
- Esse é o aprendizado que o gato adquire sobre "o que fazer" a partir de experiências positivas.
- Ao mesmo tempo, o gato também aprende o que não fazer quando confrontado com experiências negativas.
Exemplo de aprendizagem por reforço
A figura abaixo representa essa história do gato no ciclo formal, com a casa como ambiente e o peixe como recompensa.
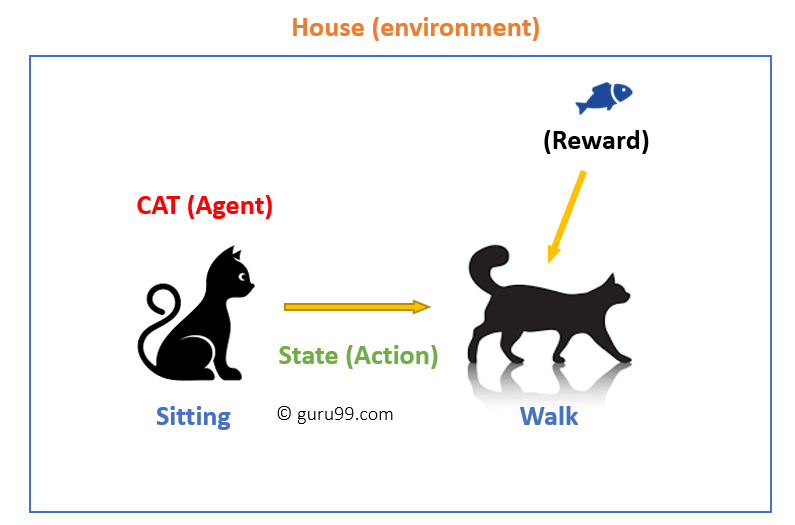
Neste caso,
- Seu gato é um agente que interage com o ambiente. Nesse caso, é a sua casa. Um exemplo de estado seria o seu gato sentado, e você usando uma palavra específica para fazê-lo andar.
- Nosso agente reage realizando uma transição de ação de um “estado” para outro “estado”.
- Por exemplo, seu gato passa de sentado a andando.
- A reação de um agente é uma ação, e a política é um método de selecionar uma ação dado um estado na expectativa de melhores resultados.
- Após a transição, o agente pode receber uma recompensa ou uma penalidade em troca.
Aprendizagem por Reforço Algorithms
Existem três abordagens para implementar um algoritmo de Aprendizagem por Reforço, e elas diferem principalmente no que o agente armazena e aprende.
Baseado em valor
Em um método de Aprendizado por Reforço baseado em valor, busca-se maximizar uma função de valor V(s). Nesse método, o agente espera um retorno a longo prazo dos estados atuais sob a política π.
Baseado em políticas
Em um método de aprendizado por reforço baseado em políticas, você tenta criar uma política de forma que a ação realizada em cada estado ajude a obter a recompensa máxima no futuro.
Dois tipos de métodos baseados em políticas são:
- Determinístico: Para qualquer estado, a mesma ação é produzida pela política π.
- Estocástico: Toda ação possui uma certa probabilidade, dada pela seguinte equação.
Política estocástica:
π(a|s) = P[At = a | St = s]
Baseado em modelo
Nesse método de Aprendizado por Reforço, você cria um modelo virtual para cada ambiente. O agente aprende a se comportar nesse ambiente específico.
Características da aprendizagem por reforço
Aqui estão algumas características importantes do aprendizado por reforço:
- Não há supervisor, apenas um número real ou sinal de recompensa
- Tomada de decisão sequencial
- O tempo desempenha um papel crucial nos problemas de reforço
- O feedback costuma ser atrasado em vez de instantâneo.
- As ações do agente determinam os dados subsequentes que ele recebe
Tipos de Aprendizagem por Reforço
A palavra “reforço” foi emprestada da psicologia comportamental e apresenta-se de duas formas:
Positiva:
É definido como um evento que ocorre devido a um comportamento específico. Ele aumenta a intensidade e a frequência do comportamento e impacta positivamente a ação tomada pelo agente.
Esse tipo de reforço ajuda a maximizar o desempenho e a sustentar a mudança por um período mais longo. No entanto, reforço em excesso pode levar à otimização excessiva do estado, o que pode afetar os resultados.
Negativo:
O reforço negativo é definido como o fortalecimento de um comportamento que ocorre devido a uma condição negativa que deveria ter sido interrompida ou evitada. Ele ajuda a definir o padrão mínimo de desempenho. No entanto, a desvantagem desse método é que ele fornece apenas o suficiente para atingir o comportamento mínimo desejado.
Modelos de Aprendizagem de Reforço
Existem dois modelos de aprendizagem importantes na aprendizagem por reforço:
- Processo de decisão de Markov
- Aprendizagem Q
Processo de decisão de Markov
Os seguintes parâmetros são usados para obter uma solução:
- Conjunto de ações – A
- Conjunto de estados – S
- Recompensa – R
- Política – π
- Valor – V
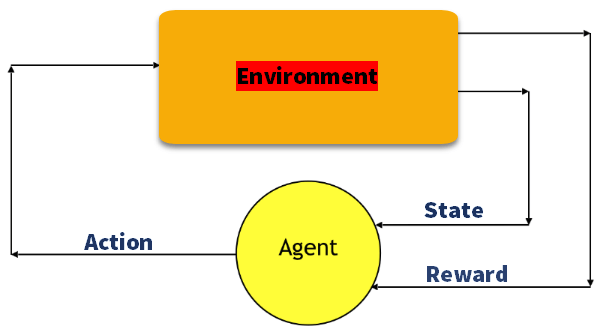
A abordagem matemática para mapasping Em Aprendizado por Reforço, uma solução é formalizada como um Processo de Decisão de Markov, ou MDP. O esquema abaixo mostra esses cinco parâmetros interligados no mesmo ciclo agente-ambiente.
Q-Aprendizagem
O aprendizado por reforço Q é um método baseado em valores para fornecer informações que indicam a um agente qual ação tomar.
Vamos entender esse método com o seguinte exemplo:
- Existem cinco salas em um edifício que são conectadas por portas.
- Cada quarto é numerado de 0 a 4.
- O exterior do edifício pode ser tratado como uma grande área externa (5)
- As portas número 1 e 4 levam para o prédio a partir da sala 5
A planta baixa abaixo numera esses cômodos e mostra quais portas os conectam.
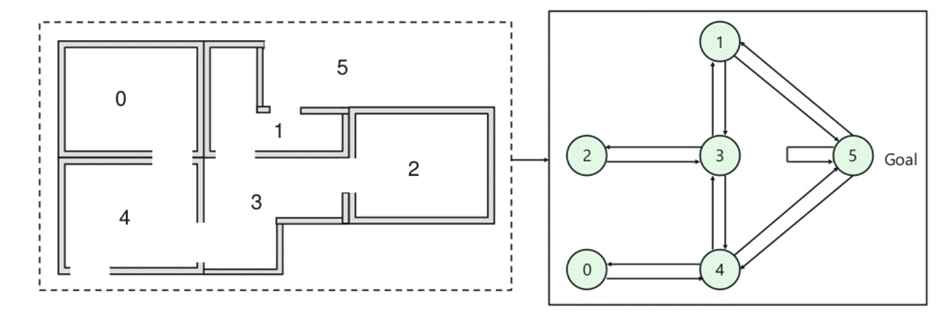
Em seguida, você precisa associar um valor de recompensa a cada porta:
- As portas que levam diretamente ao objetivo têm uma recompensa de 100
- Portas que não estão diretamente conectadas à sala alvo não concedem recompensa alguma.
- Como as portas têm duas vias, duas setas são atribuídas a cada cômodo.
- Cada seta na imagem acima possui um valor de recompensa instantâneo.
Explicação: Nessa imagem, cada sala representa um estado, e o movimento do agente de uma sala para outra representa uma ação.
No gráfico abaixo, um estado é representado como um nó, enquanto as setas mostram as ações disponíveis e a recompensa associada a cada uma delas.

Por exemplo, um agente se desloca da sala número 2 para a sala 5:
- Estado inicial = estado 2
- Estado 2-> estado 3
- Estado 3 -> estado (2,1,4)
- Estado 4-> estado (0,5,3)
- Estado 1-> estado (5,3)
- Estado 0-> estado 4
Aprendizagem por Reforço vs. Aprendizagem Supervisionada
A maneira mais clara de apresentar o Aprendizado por Reforço é colocá-lo ao lado do paradigma que a maioria dos leitores já conhece.
| Parâmetros Técnicos | Aprendizagem por Reforço | Aprendizagem Supervisionada |
|---|---|---|
| Estilo de decisão | O aprendizado por reforço ajuda você a tomar decisões sequencialmente. | Neste método, uma decisão é tomada com base na entrada fornecida no início. |
| Funciona em | Funciona interagindo com o ambiente. | Funciona com exemplos ou dados de amostra fornecidos. |
| Dependência de decisão | No método de aprendizado por reforço (RL), cada decisão de aprendizado depende das anteriores, portanto, toda a sequência de decisões é o que é avaliado. | In aprendizagem supervisionada As decisões são independentes entre si, portanto, é atribuído um rótulo a cada decisão. |
| Mais adequado | Funciona melhor e oferece melhor suporte em IA, onde a interação humana é predominante. | É operado principalmente com um sistema de software ou aplicativos interativos. |
| Exemplo | Jogo de xadrez | Reconhecimento de objeto |
Aplicações do Aprendizado por Reforço
Aqui estão as aplicações do Aprendizado por Reforço:
- Robótica para automação industrial.
- Planejamento estratégico de negócios
- Aprendizado de máquina e processamento de dados
- Isso ajuda você a criar sistemas de treinamento que fornecem instruções e materiais personalizados de acordo com as necessidades dos alunos.
- Controle de aeronaves e controle de movimento do robô
Por que usar o Aprendizado por Reforço?
Aqui estão os principais motivos para usar o Aprendizado por Reforço:
- Isso ajuda você a identificar qual situação exige uma ação.
- Ajuda você a descobrir qual ação gera a maior recompensa a longo prazo.
- O aprendizado por reforço também fornece ao agente de aprendizado uma função de recompensa.
- Isso também permite que o agente descubra o melhor método para obter grandes recompensas.
Quando não usar o aprendizado por reforço?
Não é possível aplicar um modelo de aprendizado por reforço em todas as situações. Aqui estão algumas condições em que você não deve usá-lo.
- Quando você tiver dados rotulados suficientes para resolver o problema com um método de aprendizado supervisionado.
- O aprendizado por reforço exige muito poder computacional e consome muito tempo, principalmente quando o espaço de ações é grande.
Desafios da aprendizagem por reforço
Aqui estão os principais desafios que você enfrentará ao trabalhar com Aprendizado por Reforço:
- Design de funcionalidades e recompensas, que pode ser bastante complexo.
- Os parâmetros podem afetar a velocidade de aprendizagem.
- Ambientes realistas podem ter observabilidade parcial.
- Reforço excessivo pode levar a uma sobrecarga de estados, o que pode diminuir os resultados.
- Ambientes realistas podem ser não estacionários.
