
MongoDB Expressão regular ($regex) com exemplos
 Equipe editorial
⚡ Resumo Inteligente
MongoDB As expressões regulares realizam a correspondência de padrões para encontrar strings dentro de documentos, usando o operador $regex, o sinalizador $options para ignorar maiúsculas e minúsculas, âncoras para correspondências exatas e delimitadores de barra quando o valor exato do campo é desconhecido.
Expressões regulares são usadas para correspondência de padrões, que basicamente serve para encontrar sequências de caracteres em documentos.
Às vezes, ao recuperar documentos em uma coleção, você pode não saber exatamente qual é o valor exato do campo a ser pesquisado. Conseqüentemente, pode-se usar expressões regulares para auxiliar na recuperação de dados com base em valores de pesquisa de correspondência de padrões.
Usando o operador $regex para correspondência de padrões
O operador $regex em MongoDB é usado para procurar strings específicas na coleção. O exemplo a seguir mostra como isso pode ser feito.
Vamos supor que temos nossa mesma coleção de Funcionários com os campos "Employeeid" e "EmployeeName". Vamos supor também que temos os seguintes documentos em nossa coleção.
| ID do Empregado | nome do empregado |
|---|---|
| 22 | NovoMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
No código abaixo, utilizamos o operador $regex para especificar os critérios de pesquisa.

db.Employee.find({EmployeeName : {$regex: "Gu" }}).forEach(printjson)
Code Explicação:
- Aqui, queremos encontrar todos os nomes de funcionários que contenham os caracteres 'Gu'. Portanto, especificamos o operador $regex para definir o critério de pesquisa 'Gu'.
- O printjson está sendo usado para imprimir melhor cada documento que é retornado pela consulta.
Se o comando for executado com sucesso, a seguinte saída será mostrada:
Saída:

A saída mostra claramente que os documentos em que o Nome do Funcionário contém os caracteres 'Gu' são retornados.
Suponha que sua coleção contenha os seguintes documentos, além de um documento adicional que inclua o nome do funcionário como “Guru999”. Se você inseriu os critérios de pesquisa como “Guru99”, também retornaria o documento que continha “Guru999”. Mas suponha que não quiséssemos isso e desejássemos apenas devolver o documento com “Guru99”. Então podemos fazer isso com correspondência exata de padrões. Para fazer uma correspondência exata de padrões, usaremos os caracteres ^ e $. Adicionaremos o caractere ^ no início da string e o $ no final da string.
| ID do Empregado | nome do empregado |
|---|---|
| 22 | NovoMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 8 | Guru999 |
O exemplo a seguir mostra como isso pode ser feito.
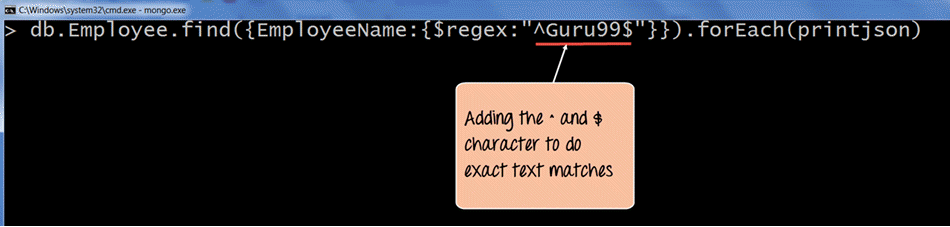
db.Employee.find({EmployeeName : {$regex: "^Guru99$"}}).forEach(printjson)
Code Explicação:
- Aqui, nos critérios de pesquisa, estamos usando os caracteres ^ e $. O ^ é usado para garantir que a string comece com um determinado caractere, e o $ é usado para garantir que a string termine com um determinado caractere. Portanto, quando o código for executado, ele buscará apenas a string com o nome “Guru99".
- O printjson está sendo usado para imprimir melhor cada documento que é retornado pela consulta.
Se o comando for executado com sucesso, a seguinte saída será mostrada:
Saída:
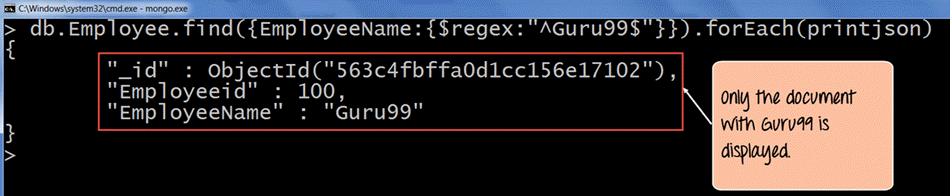
Na saída, é claramente visível que a string “Guru99” é buscado.
Correspondência de padrões com $options
Ao usar o operador $regex, também é possível fornecer opções adicionais usando o $ opções palavra-chave. Por exemplo, suponha que você queira encontrar todos os documentos que tinham 'Gu' no nome do funcionário, independentemente de diferenciar maiúsculas de minúsculas ou não. Se tal resultado for desejado, então precisaremos usar o $ opções com o parâmetro de insensibilidade a maiúsculas e minúsculas.
O exemplo a seguir mostra como isso pode ser feito.
Vamos supor que temos nossa mesma coleção de Funcionários, que possui os nomes de campo “Employeeid” e “EmployeeName”.
Vamos supor também que temos os seguintes documentos em nossa coleção.
| ID do Empregado | nome do empregado |
|---|---|
| 22 | NovoMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 7 | GURU 99 |
Agora, se executarmos a mesma consulta do tópico anterior, nunca veremos o documento com “GURU99” no resultado. Para garantir que ele apareça no conjunto de resultados, precisamos adicionar o parâmetro “i” da opção $options.
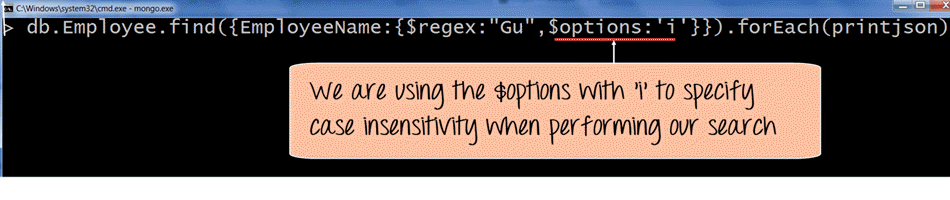
db.Employee.find({EmployeeName:{$regex: "Gu",$options:'i'}}).forEach(printjson)
Code Explicação:
- A opção `$options` com o parâmetro 'i' (que significa insensibilidade a maiúsculas e minúsculas) especifica que queremos realizar a busca independentemente de encontrarmos as letras 'Gu' em maiúsculas ou minúsculas.
Se o comando for executado com sucesso, a seguinte saída será mostrada:
Saída:
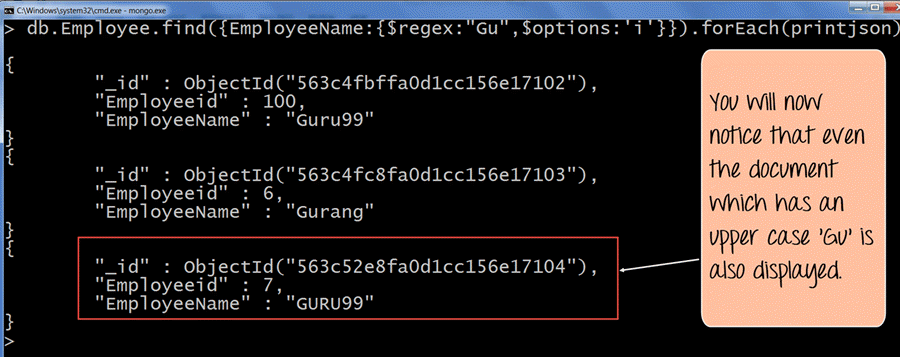
- O resultado mostra claramente que, mesmo que um documento contenha a letra maiúscula 'Gu', ele ainda é exibido no conjunto de resultados.
Correspondência de padrões sem o operador regex
Também é possível realizar a correspondência de padrões sem o operador $regex. O exemplo a seguir mostra como isso pode ser feito.
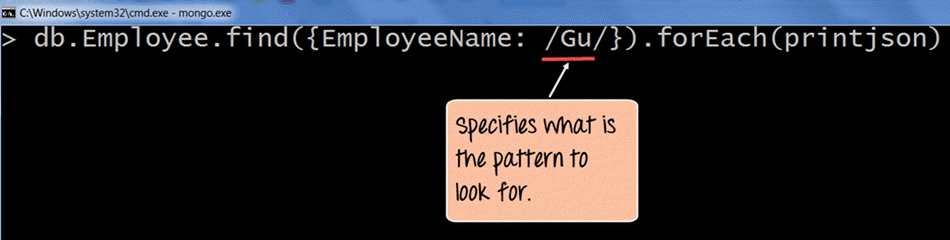
db.Employee.find({EmployeeName: /Gu/}).forEach(printjson)
Code Explicação:
- Os delimitadores “//” servem basicamente para especificar os critérios de pesquisa dentro desses delimitadores. Portanto, estamos especificando /Gu/ para encontrar novamente os documentos que contêm 'Gu' em seu EmployeeName.
Se o comando for executado com sucesso, a seguinte saída será mostrada:
Saída:
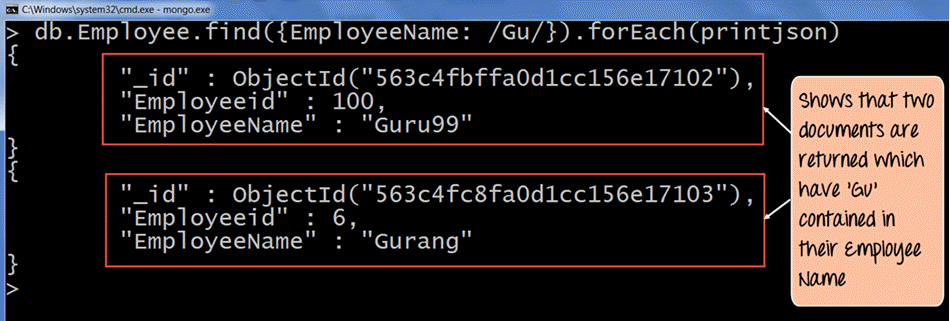
A saída mostra claramente que os documentos em que o Nome do Funcionário contém os caracteres 'Gu' são retornados.
Buscando os últimos 'n' documentos de uma coleção
Existem várias maneiras de obter os últimos n documentos de uma coleção.
Vejamos uma das maneiras através dos seguintes passos.
O exemplo a seguir mostra como isso pode ser feito.
Vamos supor que temos nossa mesma coleção de Funcionários, que possui os nomes de campo “Employeeid” e “EmployeeName”.
Vamos supor também que temos os seguintes documentos em nossa coleção:
| ID do Empregado | nome do empregado |
|---|---|
| 22 | NovoMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 7 | GURU 99 |
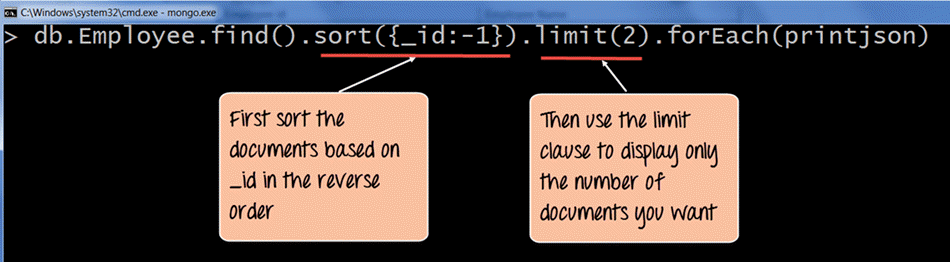
db.Employee.find().sort({_id:-1}).limit(2).forEach(printjson)
Code Explicação:
- Ao consultar os documentos, utilize a função de classificação para ordenar os registros em ordem inversa com base no valor do campo _id na coleção. O valor -1 indica que os documentos devem ser classificados em ordem inversa ou decrescente, de modo que o último documento seja o primeiro a ser exibido.
- Em seguida, use a cláusula LIMIT para exibir apenas o número de registros desejado. Aqui, definimos a cláusula LIMIT (2), para que sejam retornados os dois últimos documentos.
Se o comando for executado com sucesso, a seguinte saída será mostrada:
Saída:
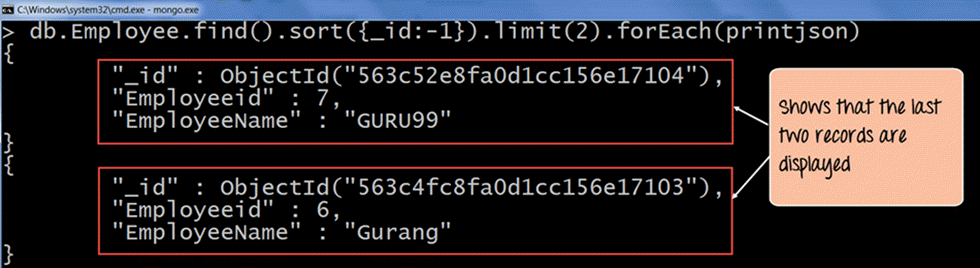
A saída mostra claramente que os dois últimos documentos da coleção são exibidos. Portanto, mostramos claramente que para buscar os últimos 'n' documentos da coleção, podemos primeiro classificar os documentos em ordem decrescente e depois usar a cláusula limit para retornar o número 'n' de documentos necessários.
Observação: se a pesquisa for realizada em uma string com mais de 38,000 caracteres, ela não exibirá os resultados corretos.
