
Teste t em R: exemplos de uma amostra e pareados
 Equipe editorial
⚡ Resumo Inteligente
O teste t em R compara médias usando a função t.test(), abrangendo uma amostra contra um alvo fixo, dois grupos independentes e medidas repetidas pareadas. Este passo a passo executa cada variante, lê o valor p corretamente e verifica as premissas subjacentes.
O que é inferência estatística?
A inferência estatística é a arte de gerar conclusões sobre a distribuição dos dados. Um cientista de dados frequentemente se depara com questões que só podem ser respondidas cientificamente. Portanto, a inferência estatística é uma estratégia para testar se uma hipótese é verdadeira, ou seja, se é validada pelos dados.
Uma estratégia comum para avaliar uma hipótese é o teste t, que indica se duas médias são iguais. Também é conhecido como teste de hipótese. Teste do alunoUm teste t pode ser calculado para:
- Um único vetor em relação a um valor fixo (teste t de uma amostra)
- Dois vetores de dois grupos separados (teste t de duas amostras independentes)
- Dois vetores medidos nos mesmos indivíduos (teste t pareado)
Todo teste t pressupõe que os dados sejam amostrados aleatoriamente e que os valores (ou, no caso de um teste pareado, as diferenças) provenham de uma população com distribuição aproximadamente normal. A versão para duas amostras independentes pressupõe adicionalmente que os dois grupos sejam independentes entre si, e a forma clássica pressupõe que suas variâncias sejam iguais.
O que é teste T na programação R?
A ideia básica por trás de um Teste T é usar estatísticas para avaliar duas hipóteses contrárias:
- H0A hipótese nula, de que a média populacional é igual ao valor que está sendo testado.
- H1A hipótese alternativa é que a média populacional difere desse valor.
O teste t foi desenvolvido para amostras pequenas, onde a aproximação normal não é confiável. Ele exige que os dados tenham uma distribuição aproximadamente normal.
Sintaxe do teste T em R
A sintaxe básica para t.test() em R é:
t.test(x, y = NULL,
       mu = 0, var.equal = FALSE)
arguments:
- x : A vector to compute the one-sample t-test
- y: A second vector to compute the two sample t-test
- mu: Mean of the population under the null hypothesis
- var.equal: Specify whether the variances of the two vectors are equal. By default, set to `FALSE`
- paired: Set to `TRUE` when the two vectors are repeated measures on the same subjects
Antes de executar qualquer procedimento, certifique-se de que o formato dos seus dados corresponda à variante correta do teste.
Tipos de teste t em R
Escolher a variante errada é o erro mais comum em testes t, portanto, comece combinando o formato dos seus dados com a variante correta.
| Formato | Use-o quando | Chamada R |
|---|---|---|
| Uma amostra | Um grupo comparado com um valor alvo conhecido. | t.test(x, mu = valor) |
| Amostras independentes de dois grupos (Welch) | Dois grupos distintos, com variâncias possivelmente desiguais. | teste.t(x, y) |
| Amostras independentes de dois grupos (agrupadas) | Dois grupos separados com variância igual | t.test(x, y, var.equal = TRUE) |
| Emparelhado | Os mesmos indivíduos foram medidos duas vezes. | t.test(x, y, paired = TRUE) |
| Unilateral | Você só se importa com a diferença em uma direção. | t.test(x, mu = valor, alternativa = “maior”) |
Além de três grupos, o teste t deixa de ser apropriado. Mude para o Teste ANOVA, o que mantém a taxa de erro geral em 5%, em vez de aumentá-la em comparações repetidas aos pares.
Teste T de uma amostra em R
O teste t de uma amostra, ou teste de Student, compara a média de um vetor com uma média teórica,  . A fórmula usada para calcular o teste t é:

Aqui,
 refere-se à média
 para a média teórica
- s é o desvio padrão
- n o número de observações.
 refere-se à média
Para avaliar a significância estatística do teste t, você precisa calcular o valor-p. O valor-p varia de 0 a 1 e é interpretado da seguinte forma:
- Um valor p inferior a 0.05 significa que você pode rejeitar a hipótese nula. Observe que rejeitar H0 não é o mesmo que provar que H1 é verdadeira; significa apenas que os dados são improváveis sob a hipótese nula de H0.
- Um valor p superior a 0.05 indica que você não tem evidências suficientes para rejeitar a hipótese nula.
Você pode construir o valor p observando o valor absoluto correspondente do teste t na distribuição de Student com graus de liberdade iguais a 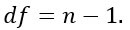
Por exemplo, com 5 observações, você compara seu valor t com a distribuição t de Student com 4 graus de liberdade e um nível de confiança de 95%. Para rejeitar a hipótese nula em um teste bicaudal, o valor t absoluto deve ser superior a 2.776.
Cf tabela abaixo:

Um exemplo de teste T em R
Suponha que você seja uma empresa que produz biscoitos. Cada biscoito deve conter 10 gramas de açúcar. Os biscoitos são produzidos por uma máquina que coloca o açúcar em uma tigela antes de misturar tudo. Você acredita que a máquina não adiciona 10 gramas de açúcar para cada biscoito. Se sua suposição for verdadeira, a máquina precisa ser consertada. Você armazenou o nível de açúcar de trinta biscoitos.
Observação: Você pode criar um vetor aleatório com a função rnorm(). Esta função gera valores normalmente distribuídos. A sintaxe básica é:
rnorm(n, mean, sd)
arguments
- n: Number of observations to generate
- mean: The mean of the distribution. Optional
- sd: The standard deviation of the distribution. Optional
Você pode criar uma distribuição com 30 observações com média de 9.99 e desvio padrão de 0.04.
set.seed(123)
sugar_cookie <- rnorm(30, mean = 9.99, sd = 0.04)
head(sugar_cookie)
Saída:
## [1] 9.967581 9.980793 10.052348 9.992820 9.995172 10.058603
Você pode usar um teste t de uma amostra para verificar se o nível de açúcar é diferente do da receita. Você pode desenhar um teste de hipótese:
- H0: O nível médio de açúcar é igual a 10
- H1: O nível médio de açúcar é diferente de 10
Você usa um nível de significância de 0.05.
# H0 : mu = 10
t.test(sugar_cookie, mu = 10)
Aqui está o resultado:

O valor p do teste t de uma amostra é 0.1079, acima do limite de 0.05. O intervalo de confiança de 95% para a média varia de 9.973 a 10.002 gramas e inclui o valor alvo de 10. Portanto, não é possível rejeitar H0: não há evidências suficientes de que a máquina se desvie da receita.
Teste t de Student para amostras independentes no R
O teste t de Student para amostras independentes é a variante mais frequentemente utilizada e aplica-se sempre que os dois conjuntos de medições provêm de sujeitos diferentes: duas lojas, duas máquinas, dois grupos de tratamento.
Suponha que uma fábrica opere duas linhas de produção e você queira saber se elas enchem potes com o mesmo peso.
set.seed(123)
line_a <- rnorm(25, mean = 500, sd = 8)
line_b <- rnorm(25, mean = 505, sd = 8)

# Welch test, the safe default
t.test(line_a, line_b)

# Pooled test, only when the variances are equal
t.test(line_a, line_b, var.equal = TRUE)
Leia a saída em quatro etapas.
- t é o tamanho padronizado da diferença entre as duas médias. Seu sinal reflete apenas a ordem em que você passou os vetores.
- df são os graus de liberdade. O teste de Welch produz um valor fracionário; o teste combinado fornece um número inteiro igual a n1 + n2 – 2.
- valor-p Qual é a probabilidade de se observar uma diferença tão grande se as médias reais fossem idênticas?
- Intervalo de confiança delimita a verdadeira diferença. Quando contém zero, a diferença não é significativa nesse nível.
Se seus dados estiverem em um único dataframe com uma coluna de valores e uma coluna de fatores, use a interface de fórmulas, que é mais fácil de ler e evita a divisão manual dos dados:
t.test(weight ~ line, data = jars)
Qual versão usar? Deixe a variável `var.equal` com seu valor padrão `FALSE`, a menos que você tenha testado e confirmado que as variâncias são iguais. A correção de Welch praticamente não tem custo em termos de poder computacional quando as variâncias coincidem e protege você quando elas não coincidem.
Teste T pareado em R
O teste t pareado, também chamado de teste t para amostras dependentes, aplica-se quando o mesmo grupo é medido duas vezes. Aplicações típicas incluem:
- Teste A / B: Compare duas variantes
- estudos de caso-controle: antes e depois de um tratamento nos mesmos sujeitos
Exemplo de teste T pareado em R
Uma empresa de bebidas está interessada em conhecer o desempenho de um programa de descontos nas vendas. A empresa decidiu acompanhar as vendas diárias de uma de suas lojas onde o programa está sendo promovido. Ao final do programa, a empresa quer saber se existe diferença estatística entre as vendas médias da loja antes e depois do programa.
- a empresa tracAs vendas eram monitoradas diariamente antes do início do programa. Este é o nosso primeiro vetor.
- O programa é promovido durante uma semana e as vendas são registradas todos os dias. Este é o nosso segundo vetor.
- Você realizará o teste t para avaliar a eficácia do programa. Isso é chamado de teste t pareado porque os valores de ambos os vetores vêm da mesma distribuição (ou seja, da mesma loja).
O teste de hipótese é:
- H0: Sem diferença na média
- H1: Os dois meios são diferentes
Lembre-se de que o teste t clássico pressupõe uma variância desconhecida, mas igual, em ambos os grupos. Dados reais raramente satisfazem essa condição exatamente, e ignorar a diferença pode distorcer o resultado.
A solução é o teste t de Welch, que relaxa a suposição de igualdade de variâncias. O R o aplica por padrão porque `var.equal` é `FALSE`, a menos que você especifique o contrário. Neste conjunto de dados, ambos os vetores foram gerados com o mesmo desvio padrão, então você pode definir `var.equal = TRUE` sem problemas.
Você cria dois vetores aleatórios a partir de uma distribuição gaussiana com uma média mais alta para as vendas após o programa.
set.seed(123)
# sales before the program
sales_before <- rnorm(7, mean = 50000, sd = 50)
# sales after the program.This has higher mean
sales_after <- rnorm(7, mean = 50075, sd = 50)
# draw the distribution
t.test(sales_before, sales_after,var.equal = TRUE)

O valor p é 0.04606, ligeiramente abaixo do limite de 0.05, portanto, rejeita-se H0 e conclui-se que as duas médias diferem significativamente. O programa de descontos parece ter impulsionado as vendas.
⚠️ Importante: A chamada acima compara os dois vetores como de treinadores em Entrevista Motivacional amostras. Como ambas as séries são medições na mesma loja, a chamada estatisticamente correta adiciona emparelhado = VERDADEIRO:
t.test(sales_before, sales_after, paired = TRUE)
A versão pareada testa a média das diferenças diárias em vez da diferença entre duas médias. Ela elimina a variação ao nível da loja partilhada por ambos os vetores e, portanto, tem maior poder estatístico.
Como verificar as premissas do teste t no R
O valor p de um teste t só é significativo quando suas premissas são válidas. Cada uma delas possui uma verificação direta.
1. Normalidade. Os testes de uma e duas amostras pressupõem que os valores sejam aproximadamente normais; o teste pareado pressupõe que... diferenças São. Inspecione um gráfico QQ e confirme com o teste de Shapiro-Wilk:
qqnorm(sugar_cookie); qqline(sugar_cookie)
shapiro.test(sugar_cookie)

# for a paired design, test the differences
shapiro.test(sales_after - sales_before)
Um valor p de Shapiro-Wilk acima de 0.05 significa que a normalidade não pode ser rejeitada. Com mais de cerca de 30 observações por grupo, o teorema do limite central torna o teste t robusto a assimetrias moderadas.
2. Variância igual. Somente o teste de duas amostras agrupadas precisa disso. Teste-o com um teste F:
var.test(line_a, line_b)
Um valor p acima de 0.05 indica variâncias iguais, o que justifica var.equal = TRUE.
3. Independência. Isso decorre do desenho do estudo e não pode ser testado posteriormente. Se o mesmo sujeito contribui para ambos os vetores, o teste independente é simplesmente a ferramenta errada e você precisa de `paired = TRUE`.
Quando uma suposição falha. Para dados claramente não normais com amostras pequenas, use as alternativas baseadas em postos: `wilcox.test(x, y)` substitui o teste t de duas amostras e `wilcox.test(x, y, paired = TRUE)` substitui a versão pareada. Nenhuma delas exige normalidade, embora ambas comprometam um pouco o poder estatístico quando os dados são de fato normais.
Teste t em R: Principais conclusões e referência do teste
- Inferência Estatística é a arte de gerar conclusões sobre a distribuição dos dados.
- O Teste T pertence à família das estatísticas inferenciais. É comumente empregado para descobrir se há diferença estatística entre as médias de dois grupos.
- O teste t de uma amostra, ou teste t de Student, compara a média de um vetor com uma média teórica.
- O teste t pareado, ou teste t para amostras dependentes, aplica-se quando o mesmo grupo é medido duas vezes.
A tabela abaixo resume cada teste abordado acima:
| Testar | Hipótese a testar | valor-p | Code | Argumento opcional |
|---|---|---|---|---|
| teste t de uma amostra | A média de um vetor é diferente da média teórica | 0.05 |
t.test(x, mu = mean)
|
|
| teste t de amostra pareada | A média A é diferente da média B para os mesmos indivíduos. | 0.05 |
t.test(A, B, paired = TRUE) |
var.equal = TRUE
|
Se você estiver disposto a assumir variâncias iguais em um teste independente de duas amostras, defina var.equal = TRUE. Deixe com o valor padrão FALSE para executar a correção de Welch, que é mais segura.
