
Gráfico de dispersão em R usando ggplot2 com exemplo
 Evelyn Clarke
⚡ Resumo Inteligente
O gráfico de dispersão em R usando ggplot2 mapeia duas variáveis contínuas para os eixos x e y com geom_point(). Este passo a passo aborda o agrupamento de variáveis contínuas.ping por cor, transformações logarítmicas, linhas de regressão ajustadas, rótulos, facetas, correções de sobreposição, escalas, temas e salvamento.
Por que os gráficos são importantes na análise de dados?
Os gráficos são a terceira parte do processo de análise de dados. A primeira parte é sobre dados extracção, a segunda parte trata limpando e manipulando os dados. Por fim, o cientista de dados pode precisar comunicar seus resultados graficamente.
O fluxo de trabalho de um cientista de dados está resumido na imagem abaixo.
- A primeira tarefa de um cientista de dados é definir uma questão de pesquisa. Esta questão de pesquisa depende dos objetivos e metas do projeto.
- Depois disso, uma das tarefas mais importantes é a engenharia de recursos. O cientista de dados precisa coletar, manipular e limpar os dados
- Quando esta etapa for concluída, ele poderá começar a explorar o conjunto de dados. Às vezes é necessário refinar e alterar a hipótese original devido a uma nova descoberta.

- Quando o explicativo análise é alcançada, o cientista de dados deve considerar a capacidade do leitor de compreender os conceitos e modelos subjacentes.
- Os seus resultados devem ser apresentados num formato que todas as partes interessadas possam compreender. Um dos melhores métodos para comunicar os resultados são através de um gráfico.
- Os gráficos são uma ferramenta incrível para simplificar análises complexas.
O restante deste tutorial ensina como construir esses gráficos usando o pacote ggplot2.
O pacote ggplot2
Este tutorial aborda a criação de gráficos em R com ggplot2.
Neste tutorial, você usará o pacote ggplot2. O pacote implementa a Gramática dos Gráficos descrita por Leland Wilkinson em 2005. O ggplot2 é flexível, vem com muitos temas e permite que você especifique um gráfico em um alto nível de abstração.tracObserve que ele não produz gráficos tridimensionais ou interativos; para isso, são necessários pacotes como plotly ou rgl.
No ggplot2, um gráfico é composto pelos seguintes argumentos:
- dados,
- mapa estéticoping
- objeto geométrico
- transformações estatísticas
- Escalas
- sistema de coordenadas
- ajustes de posição
- facetas
Você aprenderá como controlar esses argumentos no tutorial.
A sintaxe básica do ggplot2 é:
ggplot(data, mapping=aes()) +
geometric object

arguments:
data: Dataset used to plot the graph
mapping: Control the x and y-axis
geometric object: The type of plot you want to show. The most common object are:

- Point: `geom_point()`
- Bar: `geom_bar()`
- Line: `geom_line()`
- Histogram: `geom_histogram()`
Como criar um gráfico de dispersão em R
Vamos ver como o ggplot funciona com o conjunto de dados mtcars. Você começa traçando um gráfico de dispersão da variável mpg e da variável drat.
Gráfico de dispersão básico
library(ggplot2)
ggplot(mtcars, aes(x = drat, y = mpg)) +
    geom_point()
Code Explicação
- Primeiro você passa o conjunto de dados mtcars para o ggplot.
- Dentro do argumento aes(), você adiciona o eixo xey.
- O sinal + significa que você deseja que R continue lendo o código. Isso torna o código mais legível ao quebrá-lo.
- Use geom_point() para o objeto geométrico.
Saída:

Gráfico de dispersão com grupos
Às vezes, pode ser interessante distinguir os valores por um grupo de dados (ou seja, dados em nível de fator).
ggplot(mtcars, aes(x = mpg, y = drat)) +
    geom_point(aes(color = factor(gear)))
Code Explicação
- A função `aes()` dentro de `geom_point()` controla a cor de cada grupo. O grupoping A variável deve ser um fator, portanto, a engrenagem é envolvida em factor().
- Ao todo, você tem o código aes(color = factor(gear)) que altera a cor dos pontos.
Saída:

Alterar a escala do eixo com uma transformação logarítmica
Redimensionar dados é uma parte importante do trabalho do analista, pois as variáveis brutas raramente se apresentam em um formato de sino perfeito. Aplicar logaritmos é uma maneira de comprimir valores extremos e tornar o gráfico menos sensível a outliers.
ggplot(mtcars, aes(x = log(mpg), y = log(drat))) +
    geom_point(aes(color = factor(gear)))
Code Explicação
- Você transforma as variáveis x e y em log() diretamente dentro do mapa aes()ping.
Observe que qualquer outra transformação pode ser aplicada, como padronização ou normalização.
Saída:

Gráfico de dispersão com valores ajustados
Você pode adicionar mais um nível de informação ao gráfico. Você pode sobrepor os valores ajustados de um regressão linear.
my_graph <- ggplot(mtcars, aes(x = log(mpg), y = log(drat))) +
    geom_point(aes(color = factor(gear))) +
    stat_smooth(method = "lm",
        col = "#C42126",
        se = FALSE,
        size = 1)
my_graph
Code Explicação
- `my_graph`: o gráfico é armazenado no objeto `my_graph`, permitindo que etapas posteriores adicionem camadas sem a necessidade de repetir toda a chamada.
- O argumento stat_smooth() controla o método de suavização
- método = “lm”: Regressão linear
- col = “#C42126”: Code para a cor vermelha da linha
- se = FALSE: Não exibe o erro padrão
- size = 1: a espessura da linha. No ggplot2 3.4.0 e versões posteriores, esse argumento foi renomeado para linewidth para geometrias de linha.
Saída:

Observe que outros métodos de suavização estão disponíveis
- glm
- gam
- loess: o padrão para menos de 1,000 observações
- rlm: modelo linear robusto, do pacote MASS
Antes de formatar o gráfico, é importante saber quando um gráfico de dispersão é a escolha certa.
Gráfico de dispersão vs. gráfico de linhas vs. Bubble Gráfico em R
Os três modelos representam graficamente duas variáveis contínuas em relação uma à outra, portanto a escolha se resume ao que o leitor deve extrair da mensagem.
| Critérios | Gráfico de dispersão | Gráfico de Linhas | Bubble gráfico |
|---|---|---|---|
| Shows | Correlação entre duas variáveis | Variação de uma variável ao longo de um eixo ordenado. | Correlação mais uma terceira magnitude |
| Eixo X | Qualquer variável contínua | Geralmente, o tempo ou outra escala ordenada. | Qualquer variável contínua |
| Ordem dos pontos | Irrelevante | Pontos críticos estão conectados | Irrelevante |
| Terceira variável | Através da cor ou da forma | Por meio de linhas separadas | Por tamanho de ponto |
| chamada ggplot2 | geom_point() | linha_geométrica() | geom_point(aes(tamanho = z)) |
Conectar pontos dispersos com uma linha quando o eixo x não possui uma ordem natural é um erro comum: isso implica uma sequência que não existe. Reserve a função `geom_line()` para eixos ordenados, como datas. Para distribuições de uma única variável, use uma função de reta. gráfico de caixa ao invés.
Adicione informações ao gráfico
Até o momento, os gráficos não contêm texto explicativo. O leitor deve ser capaz de compreender a história a partir dos dados, apenas com base no gráfico, sem precisar consultar documentação adicional. Isso significa que o gráfico precisa de boas legendas. Você pode adicionar legendas com a função labs().
A sintaxe básica para labs() é:
labs(title = "Hello Guru99")
arguments:
- title: Main title displayed above the plot
- subtitle: Secondary line below the title
- caption: Note below the plot, usually the data source
- x: Rename the x-axis
- y: Rename the y-axis
- color / fill: Rename the legend

Example: labs(title = "Hello Guru99", subtitle = "My first plot")
Adicione um título
Uma informação obrigatória a adicionar é obviamente um título.
my_graph +
    labs(
        title = "Plot Mile per hours and drat, in log"
         )
Code Explicação
- my_graph: você usa o gráfico armazenado. Evita reescrever todos os códigos cada vez que você adiciona novas informações ao gráfico.
- Você envolve o título dentro de labs().
Saída:

Adicione um título com um nome dinâmico
Um título dinâmico é útil para adicionar informações mais precisas ao título.
Você pode usar a função paste() para imprimir texto estático e texto dinâmico. A sintaxe básica de paste() é:
paste("This is a text", A)
arguments
- " ": Text inside the quotation marks are the static text
- A: Display the variable stored in A
- Note you can add as much static text and variable as you want. You need to separate them with a comma
Exemplo:
A <- 2010
paste("The first year is", A)
Saída:
## [1] "The first year is 2010"
B <- 2018
paste("The first year is", A, "and the last year is", B)
Saída:
## [1] "The first year is 2010 and the last year is 2018"
Você pode adicionar um nome dinâmico ao nosso gráfico, ou seja, a média de mpg.
mean_mpg <- mean(mtcars$mpg)
my_graph + labs(
    title = paste("Plot Mile per hours and drat, in log. Average mpg is", mean_mpg)
)
Code Explicação
- Você cria a média de mpg com mean(mtcars$mpg) armazenado na variável mean_mpg
- Você usa paste() com mean_mpg para criar um título dinâmico retornando o valor médio de mpg
Saída:

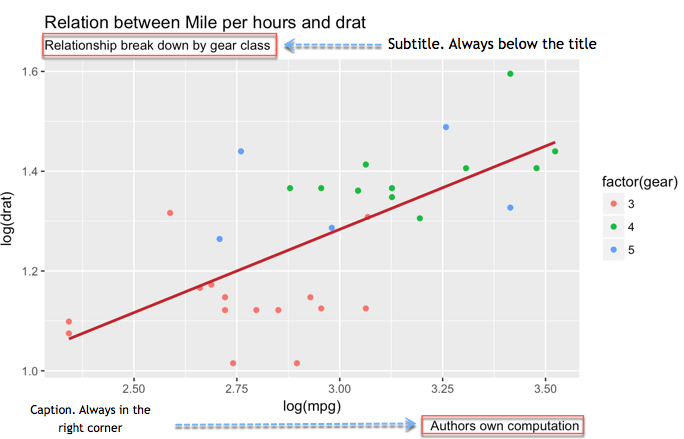
Adicionar uma legenda
Dois outros detalhes tornam o gráfico mais explícito. Você está falando do subtítulo e da legenda. O subtítulo fica logo abaixo do título. A legenda pode informar quem fez o cálculo e a fonte dos dados.
my_graph +
    labs(
        title =
        "Relation between Mile per hours and drat",
        subtitle =
        "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Code Explicação
- Dentro do laboratório (labs()), você adicionou:
- title = “Relação entre milhas por hora e drat”: Adicionar título
- subtitle = “Relacionamento dividido por classe de equipamento”: Adicionar legenda
- caption = “Cálculo do próprio autor: Adicionar legenda
- Você separa cada nova informação com uma vírgula, ,
- Observe que você quebra as linhas de código. Não é obrigatório e só ajuda a ler o código com mais facilidade
Saída:
Renomear eixo x e eixo y
Os nomes das colunas raramente estão prontos para apresentação. Muitas vezes são abreviados ou usam sublinhados entre as palavras, como em GDP_CAP. Renomeie-os no gráfico e adicione as unidades onde forem necessárias.
my_graph +
    labs(
        x = "Drat definition",
        y = "Mile per hours",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Code Explicação
- Dentro do laboratório (labs()), você adicionou:
- x = “Drat definição”: Altere o nome do eixo x
- y = “Milhas por hora”: Altere o nome do eixo y
Saída:

Controle a balança
Você pode controlar a escala do eixo.
A função seq() é conveniente quando você precisa criar uma sequência numérica. A sintaxe básica é:
seq(begin, last, by = x)
arguments:
- begin: First number of the sequence
- last: Last number of the sequence
- by= x: The step. For instance, if x is 2, the code adds 2 to `begin-1` until it reaches `last`
Por exemplo, um intervalo de 0 a 12 com um passo de 4 retorna quatro números: 0, 4, 8 e 12.
seq(0, 12,4)
Saída:
## [1] 0 4 8 12
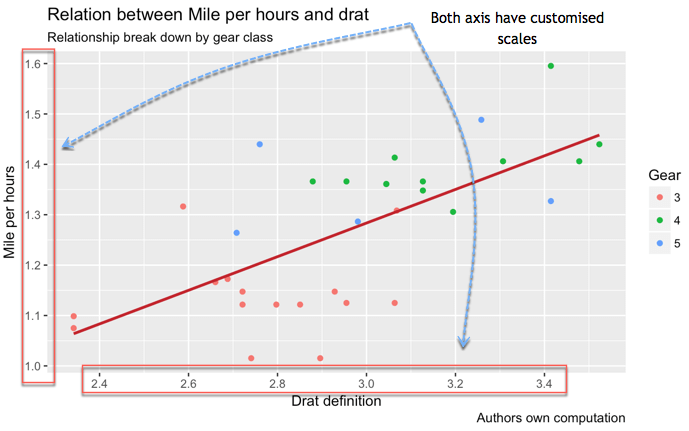
Você pode controlar a escala do eixo xey como abaixo
my_graph +
    scale_x_continuous(breaks = seq(1, 3.6, by = 0.2)) +
    scale_y_continuous(breaks = seq(1, 1.6, by = 0.1)) +
    labs(
        x = "Drat definition",
        y = "Mile per hours",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Code Explicação
- A função scale_y_continuous() controla o eixo y
- A função scale_x_continuous() controla o eixo x.
- O parâmetro breaks controla a divisão do eixo. Você pode adicionar manualmente a sequência de números ou usar a função seq():
- seq(1, 3.6, by = 0.2): Cria a sequência de 1 a 3.6 em passos de 0.2, ou seja, 14 pontos de quebra.
- seq(1, 1.6, by = 0.1): Cria sete números de 1 a 1.6 em incrementos de 0.1
Saída:
Tema
Por fim, o ggplot2 permite que você reestilize todo o gráfico com uma única função de tema. Oito temas completos são fornecidos com o pacote:
- tema_bw()
- tema_luz()
- tema_clássico()
- tema_linedraw()
- tema_escuro()
- tema_mínimo()
- tema_cinza()
- tema_void()
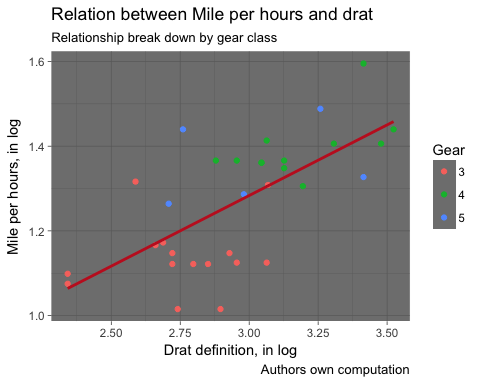
my_graph +
    theme_dark() +
    labs(
        x = "Drat definition, in log",
        y = "Mile per hours, in log",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Saída:

Salvar parcelas
Após todas essas etapas, é hora de salvar e compartilhar seu gráfico. Chame ggsave(“nome_do_arquivo.png”) logo após plotar o gráfico e a imagem será gravada no disco.
O gráfico é salvo no diretório de trabalho. Para verificar o diretório de trabalho, você pode executar este código:
directory <- getwd()
directory
Trace o gráfico final, salve-o e verifique onde ele ficou:
my_graph +
    theme_dark() +
    labs(
        x = "Drat definition, in log",
        y = "Mile per hours, in log",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Saída:
ggsave("my_fantastic_plot.png")
Saída:
## Saving 5 x 4 in image
Observação: Apenas para fins pedagógicos, criamos uma função chamada open_folder() para abrir a pasta do diretório para você. Você só precisa executar o código abaixo e ver onde a imagem está armazenada. Você deverá ver um arquivo com o nome my_fantastic_plot.png.
# Run this code to create the function
open_folder <- function(dir) {
    if (.Platform['OS.type'] == "windows") {
        shell.exec(dir)
    } else {
        system(paste(Sys.getenv("R_BROWSER"), dir))
    }
}

# Call the function to open the folder
open_folder(directory)
Como criar gráficos de dispersão facetados em R com facet_wrap()
O facetamento é um dos oito componentes do ggplot2 listados anteriormente e é a solução mais elegante para um gráfico sobrecarregado. Em vez de comprimir todos os grupos em um único painel, o ggplot2 desenha um pequeno múltiplo para cada nível de uma variável, todos na mesma escala, para que os painéis permaneçam comparáveis.
# One panel per gear count
ggplot(mtcars, aes(x = drat, y = mpg)) +
    geom_point() +
    facet_wrap(~ gear) +
    theme_classic()
A maior parte do trabalho é feita por três argumentos.
- ncol or agora: forçar os painéis a um determinado layout, por exemplo facet_wrap(~ gear, ncol = 2).
- EscalasPor padrão, o valor é "fixo", portanto, todos os painéis compartilham o mesmo intervalo de eixo. Use "free_y" ou "free" quando os grupos apresentarem diferenças significativas de magnitude, mas esteja ciente de que escalas livres podem tornar a comparação visual entre os painéis enganosa.
- rotulador: substitui o nível do fator bruto em cada tira, por exemplo, labeller = label_both para imprimir “engrenagem: 4” em vez de “4”.
Dois gruposping variáveis. Use a função facet_grid() para construir uma matriz de painéis, com a primeira variável distribuída ao longo das linhas e a segunda ao longo das colunas:
ggplot(mtcars, aes(x = drat, y = mpg)) +
    geom_point(aes(color = factor(cyl))) +
    facet_grid(am ~ gear) +
    theme_classic()
Facetas ou cores? A cor funciona bem até cerca de quatro grupos em um gráfico com sobreposição limitada. Além disso, ou sempre que os grupos se sobrepõem muito, o facetamento é mais fácil de ler porque cada painel contém apenas seus próprios pontos. Você pode combinar ambos: facetamento por uma variável e cor por outra, como no exemplo facet_grid() acima.
Como lidar com sobreposição de pontos em gráficos de dispersão no R
Com algumas dezenas de observações, cada ponto é visível. Com milhares, os marcadores se sobrepõem e a região mais densa simplesmente aparece como uma mancha sólida. Isso é plotagem excessiva, e o ggplot2 oferece quatro soluções padrão.
1. Reduzir a opacidade. A solução mais barata. Sobreposição.ping Os pontos escurecem naturalmente, tornando a densidade visível:
ggplot(diamonds, aes(x = carat, y = price)) +
    geom_point(alpha = 0.05) +
    theme_classic()
2. Variação de valores discretos. Quando uma variável assume apenas alguns valores, os pontos coincidem em coordenadas idênticas. Um pequeno deslocamento aleatório os separa:
ggplot(mtcars, aes(x = factor(cyl), y = mpg)) +
    geom_jitter(width = 0.15, height = 0) +
    theme_classic()
Defina a altura como 0 para que os valores de y, que contêm as informações reais, nunca sejam alterados.
3. Jogue o avião fora. Para conjuntos de dados grandes, conte as observações por célula e associe a contagem à cor. Os compartimentos hexagonais evitam os artefatos visuais produzidos pelos compartimentos quadrados.
ggplot(diamonds, aes(x = carat, y = price)) +
    geom_hex(bins = 40) +
    theme_classic()
4. Desenhe as curvas de nível de densidade. As curvas de nível delimitam as regiões onde as observações se concentram e se sobrepõem perfeitamente aos pontos esmaecidos:
ggplot(diamonds, aes(x = carat, y = price)) +
    geom_point(alpha = 0.05) +
    geom_density_2d(color = "#C42126") +
    theme_classic()
Como regra geral, o filtro alfa lida com alguns milhares de pontos, o agrupamento hexagonal lida com dezenas de milhares e, além disso, a amostragem dos dados com dplyr::slice_sample() é a opção pragmática.
Gráfico de dispersão em R: Code Referência
A tabela abaixo lista a chamada do ggplot2 para cada opção abordada acima:
| Objetivo | Code |
|---|---|
| Gráfico de dispersão básico |
ggplot(df, aes(x = x1, y = y)) + geom_point() |
| Gráfico de dispersão com grupo de cores |
ggplot(df, aes(x = x1, y = y)) + geom_point(aes(color = factor(x2))) |
| Adicionar valores ajustados |
ggplot(df, aes(x = x1, y = y)) + geom_point() + stat_smooth(method = "lm") |
| Adicionar título |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(title = paste("Hello Guru99")) |
| Adicionar legenda |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(subtitle = paste("Hello Guru99")) |
| Renomear x |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(x = "X1") |
| Renomear você |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(y = "y1") |
| Controle a balança |
ggplot(df, aes(x = x1, y = y)) + geom_point() + scale_y_continuous(breaks = seq(10, 35, by = 10)) + scale_x_continuous(breaks = seq(2, 5, by = 1)) |
| Criar registros |
ggplot(df, aes(x = log(x1), y = log(y))) + geom_point() |
| Tema |
ggplot(df, aes(x = x1, y = y)) + geom_point() + theme_classic() |
| Faceta por um grupo |
ggplot(df, aes(x = x1, y = y)) + geom_point() + facet_wrap(~ x2) |
| Lidar com sobreposição de gráficos |
ggplot(df, aes(x = x1, y = y)) + geom_point(alpha = 0.3) |
| Economize |
ggsave("my_fantastic_plot.png")
|
