
Matriz de correlação de Pearson e Spearman em R com exemplo
 Evelyn Clarke
⚡ Resumo Inteligente
Em R, as correlações de Pearson e Spearman medem a intensidade com que duas variáveis se correlacionam, usando a função `cor()` para um único par e uma matriz de correlação para vários pares. Este tutorial adiciona testes de significância com o pacote `Hmisc` e visualiza o resultado com mapas de calor do pacote `GGally`.
Correlação Bivariada em R
Um relacionamento bivariado descreve um relacionamento -ou correlação- entre duas variáveis em R. Neste tutorial, discutiremos o conceito de correlação e mostraremos como ele pode ser usado para medir o relacionamento entre quaisquer duas variáveis em R.
Correlação na Programação R
Existem dois métodos principais para calcular a correlação entre duas variáveis na programação R:
- Pearson: Correlação paramétrica
- Lanceiro: Correlação não paramétrica
Matriz de Correlação de Pearson em R
O método de correlação de Pearson é geralmente usado como verificação primária da relação entre duas variáveis.
O Coeficiente de correlação, escrito r, mede a força do linear Relação entre duas variáveis x e y. É calculada da seguinte forma:
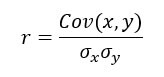
com as
 é o desvio padrão de x
 é o desvio padrão de y
 é o desvio padrão de x
 é o desvio padrão de y
A correlação varia entre -1 e 1.
- Um valor de r próximo ou igual a 0 implica pouca ou nenhuma relação linear entre x e y.
- Quanto mais próximo de 1 ou -1 for o valor de r, mais forte será a relação linear.
Você pode testar se r difere de zero com a estatística t abaixo, comparando-a com a distribuição t de Student com n – 2 graus de liberdade:
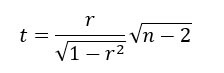
Correlação de classificação de Spearman em R
A correlação de postos ordena as observações por classificação e calcula o nível de similaridade entre as classificações. A correlação de postos tem a vantagem de ser robusta a valores discrepantes e não está ligada à distribuição dos dados. Além disso, a correlação de postos é a escolha certa para variáveis ordinais.
A correlação de Spearman, representada por rho, também varia de -1 a 1, e valores próximos a qualquer um dos extremos indicam uma forte relação monotônica. Ela é calculada da seguinte forma:
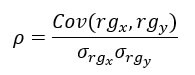
O numerador é a covariância entre as posições de x e y, e o denominador é o produto de seus desvios padrão.
Em R, ambos são calculados com a função cor(), que recebe três argumentos: x, y e método.
cor(x, y, method)
Argumentos:
- x: Primeiro vetor
- y: Segundo vetor
- método: A fórmula usada para calcular a correlação. Três valores de string:
- “Pearson”
- “Kendall”
- "lanceiro"
Um argumento opcional pode ser adicionado se os vetores contiverem valores ausentes: use = “complete.obs”
Usaremos o conjunto de dados BudgetUK. Este conjunto de dados relata a alocação orçamentária das famílias britânicas entre 1980 e 1982. Existem 1519 observações com dez características, entre elas:
- wfood: compartilhe alimentos, compartilhe gastos
- combustível: compartilhe gastos com combustível
- pano: parcela do orçamento para gastos com roupas
- walc: compartilhe gastos com álcool
- wtrans: compartilhar gastos com transporte
- importa: parcela de gastos com outros bens
- totex: gasto total da família em libras
- rendimentos de capitais: renda familiar líquida total
- idade: idade da família
- crianças: número de filhos
Exemplo
library(dplyr)
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/british_household.csv"
data <- read.csv(PATH) %>%
    filter(income < 500) %>%
    mutate(log_income = log(income),
           log_totexp = log(totexp),
           children_fac = factor(children, order = TRUE, labels = c("No", "Yes"))) %>%
    select(-c(X, X.1, children, totexp, income))
glimpse(data)
Code Explicação
- Primeiro importamos os dados e damos uma olhada na função vislumbre() da biblioteca dplyr.
- Três famílias declaram uma renda de 500 ou mais, então o filtro (renda < 500) as remove e a contagem de linhas cai de 1,519 para 1,516.
- É uma prática comum converter uma variável monetária em log. Ajuda a reduzir o impacto de valores discrepantes e diminui a assimetria no conjunto de dados.
Saída:
## Observations: 1,516
## Variables: 10
## $ wfood        <dbl> 0.4272, 0.3739, 0.1941, 0.4438, 0.3331, 0.3752, 0...
## $ wfuel        <dbl> 0.1342, 0.1686, 0.4056, 0.1258, 0.0824, 0.0481, 0...
## $ wcloth       <dbl> 0.0000, 0.0091, 0.0012, 0.0539, 0.0399, 0.1170, 0...
## $ walc         <dbl> 0.0106, 0.0825, 0.0513, 0.0397, 0.1571, 0.0210, 0...
## $ wtrans       <dbl> 0.1458, 0.1215, 0.2063, 0.0652, 0.2403, 0.0955, 0...
## $ wother       <dbl> 0.2822, 0.2444, 0.1415, 0.2716, 0.1473, 0.3431, 0...
## $ age          <int> 25, 39, 47, 33, 31, 24, 46, 25, 30, 41, 48, 24, 2...
## $ log_income   <dbl> 4.867534, 5.010635, 5.438079, 4.605170, 4.605170,...
## $ log_totexp   <dbl> 3.912023, 4.499810, 5.192957, 4.382027, 4.499810,...
## $ children_fac <ord> Yes, Yes, Yes, Yes, No, No, No, No, No, No, Yes, ...
Podemos calcular o coeficiente de correlação entre as variáveis renda e wfood com os métodos “pearson” e “spearman”.
cor(data$log_income, data$wfood, method = "pearson")
Saída:
## [1] -0.2466986
cor(data$log_income, data$wfood, method = "spearman")
Saída:
## [1] -0.2501252
Antes de estender isso a todos os pares de variáveis, vale a pena definir como um único coeficiente deve ser interpretado.
Como interpretar um coeficiente de correlação
Um coeficiente só é útil quando se consegue dizer o que ele significa. As faixas abaixo representam a leitura convencional, e o sinal é lido separadamente da intensidade.
| Valor absoluto de r | Força do relacionamento |
|---|---|
| 0.00 a 0.19 | Muito fraco ou nenhum |
| 0.20 a 0.39 | Fraco |
| 0.40 a 0.59 | Moderado |
| 0.60 a 0.79 | Forte |
| 0.80 a 1.00 | Muito forte |
O valor de -0.2467 calculado anteriormente entre log_income e wfood representa, portanto, uma fraca relação negativa: as famílias mais ricas gastam uma parcela ligeiramente menor do seu orçamento em alimentação.
Três precauções se aplicam a cada coeficiente.
- Correlação não é causalidade. Um r forte indica que as duas variáveis se movem juntas, nunca que uma causa a outra. Uma terceira variável, não medida, geralmente influencia ambas.
- Pearson só enxerga linhas retas. Uma relação perfeita em forma de U resulta em um r próximo de zero. Sempre plote os dados antes de confiar no número.
- O tamanho importa mais do que a importância. Com 1,516 observações, um coeficiente de 0.06 pode ser estatisticamente significativo e, ainda assim, praticamente irrelevante.
Como testar a significância da correlação com cor.test()
A função `cor()` retorna o coeficiente e nada mais. Para um único par, `cor.test()` adiciona o valor p e o intervalo de confiança em uma única chamada.
cor.test(data$log_income, data$wfood, method = "pearson")
O resultado contém quatro partes que valem a pena ler.
- t e df: a estatística de teste e seus graus de liberdade, n – 2.
- valor-p: a probabilidade de se observar um coeficiente tão grande se a correlação verdadeira fosse zero.
- intervalo de confiança de 95%: o intervalo plausível para a correlação verdadeira. Se excluir o zero, a relação é significativa nesse nível.
- estimativa de amostra: o próprio coeficiente, idêntico ao que cor() retorna.
A mesma função executa os testes baseados em classificação alterando apenas um argumento:
# Spearman rank correlation with a p-value
cor.test(data$log_income, data$wfood, method = "spearman")

# One-sided test: is the correlation greater than zero?
cor.test(data$log_income, data$wfood, alternative = "greater")
Quando usar cada um. Use `cor.test()` quando estiver examinando um par específico, pois ele fornece o intervalo de confiança que `rcorr()` omite. Use `rcorr()` do pacote `Hmisc`, mostrado acima, quando precisar de valores p para uma matriz inteira de uma só vez. Observe que testar muitos pares aumenta a taxa de falsos positivos; portanto, ajuste os valores p com `p.adjust(p_value, method = “BH”)` antes de tirar conclusões de uma matriz grande.
Matriz de Correlação em R
Uma correlação bivariada é um bom começo, mas uma visão multivariada oferece um panorama mais amplo. matriz de correlação É uma tabela quadrada que contém a correlação par a par de cada variável com todas as outras.
A função cor() retorna uma matriz de correlação. A única diferença com a correlação bivariada é que não precisamos especificar quais variáveis. Por padrão, R calcula a correlação entre todas as variáveis.
Não é possível calcular a correlação de um fator, portanto, remova todas as colunas categóricas antes de passar o dataframe para a função cor().
Uma matriz de correlação é simétrica, o que significa que os valores acima da diagonal têm os mesmos valores que o valor abaixo. É mais visual mostrar metade da matriz.
children_fac é excluído porque cor() não pode operar em um fator.
# the last column of data is a factor level. We don't include it in the code
mat_1 <-as.dist(round(cor(data[,1:9]),2))
mat_1
Code Explicação
- cor(dados[, 1:9])Calcule a matriz de correlação nas nove colunas numéricas.
- rodada(…, 2)Arredonde todos os coeficientes para duas casas decimais.
- como.dist()Imprima apenas o triângulo inferior, pois a matriz é simétrica.
Saída:
##            wfood wfuel wcloth  walc wtrans wother   age log_income
## wfuel       0.11
## wcloth     -0.33 -0.25
## walc       -0.12 -0.13  -0.09
## wtrans     -0.34 -0.16  -0.19 -0.22
## wother     -0.35 -0.14  -0.22 -0.12  -0.29
## age         0.02 -0.05   0.04 -0.14   0.03   0.02
## log_income -0.25 -0.12   0.10  0.04   0.06   0.13  0.23
## log_totexp -0.50 -0.36   0.34  0.12   0.15   0.15  0.21       0.49
Nível de significância
Um coeficiente por si só não indica se a relação é estatisticamente confiável. A função `rcorr()` da biblioteca `Hmisc` retorna o valor p para cada par. Podemos baixar a biblioteca em [link para a biblioteca]. município e copie o código para colá-lo no terminal:
conda install -c r r-hmisc
O rcorr() requer que um quadro de dados seja armazenado como uma matriz. Podemos converter nossos dados em uma matriz antes de calcular a matriz de correlação com o valor p.
library("Hmisc")
data_rcorr <-as.matrix(data[, 1: 9])

mat_2 <-rcorr(data_rcorr)
# mat_2 <-rcorr(as.matrix(data)) returns the same output
O objeto de lista mat_2 contém três elementos:
- r: Saída da matriz de correlação
- n: Número de observações
- P: valor p
Estamos interessados no terceiro elemento, o valor p. É comum mostrar a matriz de correlação com o valor p em vez do coeficiente de correlação.
p_value <-round(mat_2[["P"]], 3)
p_value
Code Explicação
- mat_2[[“P”]]: Os valores p são armazenados no elemento chamado P
- rodada(mat_2[[“P”]], 3): Arredonde os elementos com três dígitos
Saída:
           wfood wfuel wcloth  walc wtrans wother   age log_income log_totexp
wfood         NA 0.000  0.000 0.000  0.000  0.000 0.365      0.000          0
wfuel      0.000    NA  0.000 0.000  0.000  0.000 0.076      0.000          0
wcloth     0.000 0.000     NA 0.001  0.000  0.000 0.160      0.000          0
walc       0.000 0.000  0.001    NA  0.000  0.000 0.000      0.105          0
wtrans     0.000 0.000  0.000 0.000     NA  0.000 0.259      0.020          0
wother     0.000 0.000  0.000 0.000  0.000     NA 0.355      0.000          0
age        0.365 0.076  0.160 0.000  0.259  0.355    NA      0.000          0
log_income 0.000 0.000  0.000 0.105  0.020  0.000 0.000         NA          0
log_totexp 0.000 0.000  0.000 0.000  0.000  0.000 0.000      0.000         NA
Visualizando Matriz de Correlação em R
Um mapa de calor é outra forma de interpretar uma matriz de correlação. A biblioteca GGally estende o ggplot2 e é instalada a partir do CRAN, em vez do conda:
install.packages("GGally")

A biblioteca inclui diferentes funções para mostrar as estatísticas resumidas, como a correlação e distribuição de todas as variáveis em um matriz.
A função ggcorr() possui muitos argumentos. Apresentaremos apenas os argumentos que usaremos no tutorial:
A função ggcorr
ggcorr(df, method = c("pairwise", "pearson"),
  nbreaks = NULL, digits = 2, low = "#3B9AB2",
  mid = "#EEEEEE", high = "#F21A00",
  geom = "tile", label = FALSE,
  label_alpha = FALSE)
Argumentos:
- df: Conjunto de dados usado
- método: Fórmula para calcular a correlação. Por padrão, pairwise e Pearson são calculados
- nbreaks: Retorna um intervalo categórico para a coloração dos coeficientes. Por padrão, não há quebra e o gradiente de cores é contínuo
- dígitos: Arredonde o coeficiente de correlação. Por padrão, defina como 2
- baixo: Controla o nível inferior da coloração
- médio: Controla o nível médio da coloração
- Alto: Controle o alto nível da coloração
- geometria: controla a forma do argumento geométrico. Por padrão, “bloco”
- rótulo: Valor booleano. Exibir ou não o rótulo. Por padrão, defina como `FALSE`
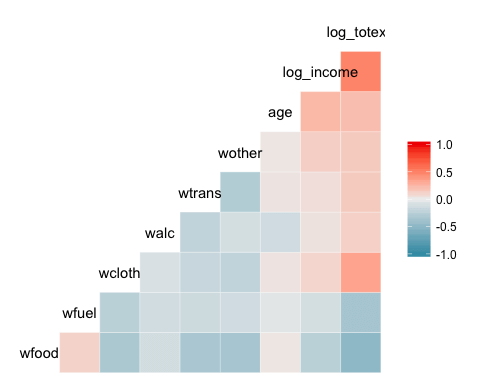
Mapa de calor básico
O gráfico mais básico do pacote é um mapa de calor. A legenda do gráfico mostra um gradiente de cor de –1 a 1, com a cor quente indicando forte correlação positiva e a cor fria, uma correlação negativa.
library(GGally)
ggcorr(data)
Code Explicação
- ggcorr(dados): apenas um argumento é necessário, que é o nome do quadro de dados. As variáveis de nível de fator não são incluídas no gráfico.
Saída:
Adicionando controle ao mapa de calor
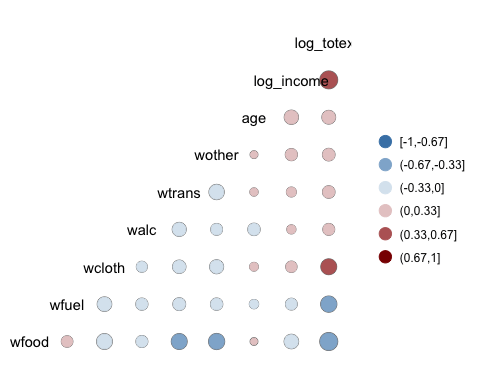
Podemos adicionar mais controles ao gráfico:
ggcorr(data,
    nbreaks = 6,
    low = "steelblue",
    mid = "white",
    high = "darkred",
    geom = "circle")
Code Explicação
- npausas=6: quebre a lenda com 6 classificações.
- baixo = “azul aço”: Use cores mais claras para correlação negativa
- meio = “branco”: Use cores brancas para correlação de intervalos intermediários
- alto = “vermelho escuro”: Use cores escuras para correlação positiva
- geom = “círculo”: use o círculo como o formato das janelas no mapa de calor. O tamanho do círculo é proporcional ao valor absoluto da correlação.
Saída:
Adicionando rótulo ao mapa de calor
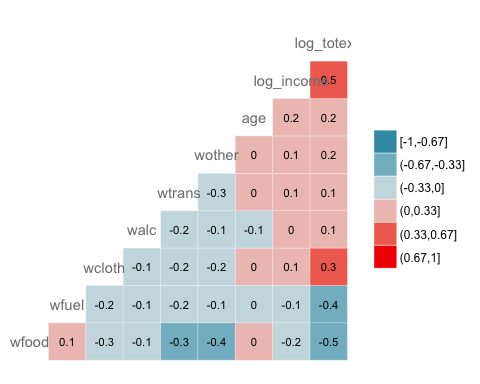
GGally nos permite adicionar um rótulo dentro das janelas:
ggcorr(data,
    nbreaks = 6,
    label = TRUE,
    label_size = 3,
    color = "grey50")
Code Explicação
- rótulo = VERDADEIRO: Adicione os valores dos coeficientes de correlação dentro do mapa de calor.
- cor = “cinza50”: Escolha a cor, ou seja, cinza
- tamanho_da_rótulo = 3: Defina o tamanho da etiqueta como 3
Saída:
A função ggpairs
A biblioteca GGally também fornece a função ggpairs(), que retorna uma matriz de gráficos. Para k variáveis selecionadas, o resultado é uma grade k por k: a diagonal mostra a distribuição de cada variável, enquanto os painéis acima e abaixo da diagonal podem conter cálculos diferentes. A sintaxe é:
ggpairs(df, columns = 1:ncol(df), title = NULL,
    upper = list(continuous = "cor"),
    lower = list(continuous = "smooth"),
    mapping = NULL)
Argumentos:
- df: Conjunto de dados usado
- colunas: Selecione as colunas para desenhar o gráfico
- título: Incluir um título
- superior: Controla as caixas acima da diagonal do gráfico. É necessário fornecer o tipo de cálculo ou gráfico a ser retornado. Se `continuous = “cor”`, pedimos ao R para calcular a correlação. Observe que o argumento precisa ser uma lista. Outros argumentos estão disponíveis; veja a documentação. Documentação GGally para obter mais informações.
- diminuir: Controle as caixas abaixo da diagonal.
- mapa,ping: Indica a estética do gráfico. Por exemplo, podemos calcular o gráfico para diferentes grupos.
Análise bivariada com ggpair com grupoping
O próximo gráfico representa três informações:
- A matriz de correlação entre as variáveis log_totexp, log_income, idade e wtrans agrupadas de acordo com o fato de o domicílio ter filho ou não.
- Trace a distribuição de cada variável por grupo
- Exibir o gráfico de dispersão com a tendência por grupo
library(ggplot2)
ggpairs(data, columns = c("log_totexp", "log_income", "age", "wtrans"), title = "Bivariate analysis of revenue expenditure by the British household", upper = list(continuous = wrap("cor",
        size = 3)),
    lower = list(continuous = wrap("smooth",
        alpha = 0.3,
        size = 0.1)),
    mapping = aes(color = children_fac))
Code Explicação
- colunas = c(“log_totexp”, “log_income”, “idade”, “wtrans”): Escolha as variáveis a serem mostradas no gráfico
- title = “Análise bivariada das receitas e despesas da família britânica”: Adicione um título
- superior = lista(): controla a parte superior do gráfico. Ou seja, acima da diagonal
- contínuo = wrap(“cor”, tamanho = 3)): Calcule o coeficiente de correlação. Envolvemos o argumento contínuo dentro da função wrap() para controlar a estética do gráfico (ou seja, tamanho = 3) -lower = list(): Controla a parte inferior do gráfico. Ou seja, abaixo da diagonal.
- contínuo = wrap(“suave”,alfa = 0.3,tamanho=0.1): adicione um gráfico de dispersão com uma tendência linear. Envolvemos o argumento contínuo dentro da função wrap() para controlar a estética do gráfico (ou seja, tamanho = 0.1, alfa = 0.3)
- mapa,ping = aes(cor = crianças_fac)Divida cada painel por children_fac, o fator ordenado rotulado como “Não” para famílias sem filhos e “Sim” para famílias com filhos.
Saída:

Análise bivariada com ggpair com grupo parcialping
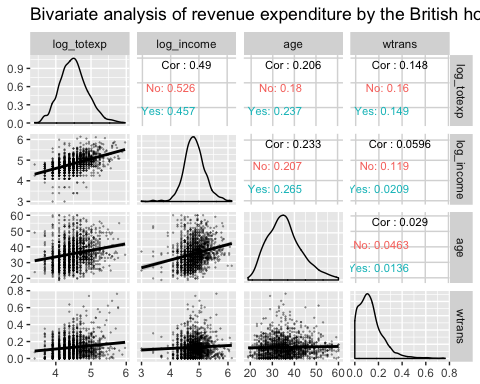
O gráfico abaixo é um pouco diferente. Alteramos a posição do mapa.ping dentro do argumento superior.
ggpairs(data, columns = c("log_totexp", "log_income", "age", "wtrans"),
    title = "Bivariate analysis of revenue expenditure by the British household",
    upper = list(continuous = wrap("cor",
            size = 3),
        mapping = aes(color = children_fac)),
    lower = list(
        continuous = wrap("smooth",
            alpha = 0.3,
            size = 0.1))
)
Code Explicação
- Exatamente o mesmo código do exemplo anterior, exceto por:
- mapa,ping = aes(color = children_fac): Mova a lista para upper = list(). Queremos apenas que a computação seja agrupada por grupo na parte superior do grafo.
Saída:
Correlação em R: Principais conclusões e referência de funções
- Um relacionamento bivariado descreve um relacionamento -ou correlação- entre duas variáveis em R.
- Existem dois métodos principais para calcular a correlação entre duas variáveis em Programação R: Pearson e Spearman.
- O método de correlação de Pearson é geralmente usado como verificação primária da relação entre duas variáveis.
- Uma correlação de classificação classifica as observações por classificação e calcula o nível de similaridade entre as classificações.
- A correlação de Spearman varia de -1 a 1, e valores próximos a qualquer um dos extremos indicam uma forte relação monotônica.
- Uma matriz de correlação é uma tabela quadrada que contém a correlação entre todos os pares de variáveis.
- O valor p indica se uma correlação observada é estatisticamente diferente de zero.
Todas as funções de correlação utilizadas neste tutorial estão listadas abaixo:
| Biblioteca | Objetivo | Forma | Code |
|---|---|---|---|
| Base | Correlação bivariada | Pearson |
cor(dfx2, method = "pearson") |
| Base | Correlação bivariada | Lanceiro |
cor(dfx2, method = "spearman") |
| Base | Correlação multivariada | Pearson |
cor(df, method = "pearson") |
| Base | Correlação multivariada | Lanceiro |
cor(df, method = "spearman") |
| Hmisc | Valor de p | - |
rcorr(as.matrix(data[,1:9]))[["P"]] |
| GGally | Mapa de calor | - |
ggcorr(df)
|
| GGally | Matriz de plotagem multivariada | - |
ggpairs(df, columns = c("x1", "x2")) |
