
Funções na programação R com exemplo
 Equipe editorial
⚡ Resumo Inteligente
As funções em R agrupam um conjunto de instruções sob um único nome, permitindo que uma tarefa repetida seja executada com uma única chamada. Isso inclui funções auxiliares integradas para matemática e estatística, funções definidas pelo usuário e escopo de ambiente.pingOs argumentos condicionais e outros são abordados aqui com exemplos práticos.
O que é uma função em R?
A função, em um ambiente de programação, é um conjunto de instruções. Um programador constrói uma função para evitar repetindo a mesma tarefaou reduzir complexidade.
Uma função deve ser
- escrito para realizar uma tarefa específica
- pode ou não incluir argumentos
- contém um corpo
- Pode ou não retornar um ou mais valores.
Uma abordagem geral para uma função é usar a parte do argumento como inputs, alimente o corpo parte e finalmente retornar um saída. A sintaxe de uma função é a seguinte:
function (arglist)  {
  #Function body
}
R funções integradas importantes
Existem muitas funções integradas em R. R combina seus parâmetros de entrada com seus argumentos de função, por valor ou por posição, e então executa o corpo da função. Os argumentos da função podem ter valores padrão: se você não especificar esses argumentos, R assumirá o valor padrão.
Observação:
É possível ver o código fonte de uma função executando o nome da própria função no console.
Typing Um nome de função sem colchetes imprime seu código-fonte, como mostra o console abaixo.

Veremos três grupos de funções em ação
- Função geral
- Função matemática
- Função estatística
Funções gerais
Já estamos familiarizados com funções gerais como cbind(), rbind(), range(), ordenar()e order(). Cada uma dessas funções tem uma tarefa específica, recebe argumentos e retorna um resultado. A seguir, estão algumas funções importantes que você precisa conhecer:
função diff()
Se você trabalhar em série temporal, você precisa estacionar a série tomando seus valores de atraso. UMA processo estacionário Permite média, variância e autocorrelação constantes ao longo do tempo. Isso melhora principalmente a previsão de uma série temporal. Isso pode ser feito com a função `diff()`. Podemos construir dados de séries temporais aleatórias com uma tendência e, em seguida, usar a função `diff()` para estacionar a série. A função `diff()` aceita um argumento, um vetor, e retorna a diferença defasada e iterada adequada.
ObservaçãoFrequentemente precisamos criar dados aleatórios, mas para aprendizado e comparação, queremos que os números sejam idênticos em todas as máquinas. Para garantir que todos gerem os mesmos dados, usamos a função `set.seed()` com valores arbitrários de 123. `set.seed()` fixa o ponto de partida do gerador de números pseudoaleatórios, de modo que cada máquina produza a mesma sequência. Sem `set.seed()`, cada execução retorna uma sequência diferente.
set.seed(123)
## Create the data
x = rnorm(1000)
ts <- cumsum(x)
## Stationary the serie
diff_ts <- diff(ts)
par(mfrow=c(1,2))
## Plot the series
plot(ts, type='l')
plot(diff(ts), type='l')
Os dois painéis abaixo mostram a série cumulativa original ao lado da série diferenciada, que agora oscila em torno de uma média constante.

função comprimento()
Em muitos casos, queremos saber o comprimento de um vetor para cálculos ou para usá-lo em um laço `for`. A função `length()` conta o número de linhas no vetor `x`. Os códigos a seguir importam o conjunto de dados `cars` e retornam o número de linhas.
ObservaçãoA função `length()` retorna o número de elementos em um vetor. Se a função for passada como argumento, ela retornará o número de elementos em um vetor. matriz ou um quadro de dados, o número de colunas é retornado.
dt <- cars
## number columns
length(dt)
Saída:
## [1] 1
## number rows
length(dt[,1])
Saída:
## [1] 50
Funções matemáticas
Além das funções auxiliares gerais, o R possui uma variedade de funções matemáticas que operam elemento por elemento em um vetor.
| Operator | Descrição |
|---|---|
| abs (x) | Toma o valor absoluto de x |
| registro(x,base=y) | Toma o logaritmo de x com base y; se a base não for especificada, retorna o logaritmo natural |
| exp (x) | Retorna a exponencial de x |
| sqrt (x) | Retorna a raiz quadrada de x |
| fatorial (x) | Retorna o fatorial de x (x!) |
# sequence of number from 44 to 55 both including incremented by 1
x_vector <- seq(45,55, by = 1)
#logarithm
log(x_vector)
Saída:
##  [1] 3.806662 3.828641 3.850148 3.871201 3.891820 3.912023 3.931826
##  [8] 3.951244 3.970292 3.988984 4.007333
#exponential
exp(x_vector)
#squared root
sqrt(x_vector)
Saída:
##  [1] 6.708204 6.782330 6.855655 6.928203 7.000000 7.071068 7.141428
##  [8] 7.211103 7.280110 7.348469 7.416198
#factorial
factorial(x_vector)
Saída:
##  [1] 1.196222e+56 5.502622e+57 2.586232e+59 1.241392e+61 6.082819e+62
##  [6] 3.041409e+64 1.551119e+66 8.065818e+67 4.274883e+69 2.308437e+71
## [11] 1.269640e+73
Funções estatísticas
Enquanto as funções matemáticas transformam valores, as funções estatísticas os resumem. A instalação padrão do R contém uma ampla gama de funções estatísticas. Neste tutorial, vamos analisar brevemente as mais importantes.
Funções estatísticas básicas
| Operator | Descrição |
|---|---|
| média(x) | Média de x |
| mediana (x) | Mediana de x |
| var(x) | Variância de x |
| sd(x) | Desvio padrão de x |
| escala (x) | Pontuações padrão (pontuações z) de x |
| quantil (x) | Os quartis de x |
| resumo(x) | Resumo de x: média, mínimo, máximo etc. |
speed <- dt$speed
speed
# Mean speed of cars dataset
mean(speed)
Saída:
## [1] 15.4
# Median speed of cars dataset
median(speed)
Saída:
## [1] 15
# Variance speed of cars dataset
var(speed)
Saída:
## [1] 27.95918
# Standard deviation speed of cars dataset
sd(speed)
Saída:
## [1] 5.287644
# Standardize vector speed of cars dataset
head(scale(speed), 5)
Saída:
##           [,1]
## [1,] -2.155969
## [2,] -2.155969
## [3,] -1.588609
## [4,] -1.588609
## [5,] -1.399489
# Quantile speed of cars dataset
quantile(speed)
Saída:
##   0%  25%  50%  75% 100%
##    4   12   15   19   25
# Summary speed of cars dataset
summary(speed)
Saída:
##    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
##     4.0    12.0    15.0    15.4    19.0    25.0
Até este ponto, aprendemos muitas funções integradas do R.
ObservaçãoTenha cuidado com o classe do argumento, ou seja, numérico, booleano ou string. Por exemplo, se precisarmos passar um valor de string, precisamos colocar a string entre aspas: “ABC”.
Função de gravação em R
Em algumas ocasiões, precisamos escrever nossa própria função porque temos que realizar uma tarefa específica e não existe uma função pronta. Uma função definida pelo usuário envolve uma nome, argumentos e uma corpo.
function.name <- function(arguments)
{
    computations on the arguments
    some other code
}
Observação: uma boa prática é nomear uma função definida pelo usuário diferente de uma função integrada. Isso evita confusão.
Função de um argumento
No próximo trecho, definimos uma função quadrada simples. A função aceita um valor e retorna o quadrado do valor.
square_function<- function(n)
{
  # compute the square of integer `n`
  n^2
}
# calling the function and passing value 4
square_function(4)
Code Explicação
- A função é denominada função_quadrada; pode ser chamado como quisermos.
- Recebe um argumento “n”. Nós não especificou o tipo de variável para que o usuário possa passar um inteiro, um vetor ou uma matriz
- A função pega a entrada “n” e retorna o quadrado da entrada. Quando terminar de usar a função, podemos removê-la com a função rm().
# depois de criar a função
rm(square_function)
square_function
No console, podemos ver uma mensagem de erro: Erro: objeto 'square_function' não encontrado informando que a função não existe.
Escopo do Meio Ambienteping
Em R, o meio Ambiente É uma coleção de objetos como funções, variáveis, data frames, etc.
O R abre um ambiente cada vez que o RStudio é iniciado.
O ambiente de nível superior disponível é o ambiente global, chamado R_GlobalEnv. E nós temos o ambiente local.
Podemos listar o conteúdo do ambiente atual.
ls(environment())
saída
## [1] "diff_ts"         "dt"              "speed"           "square_function"
## [5] "ts"              "x"               "x_vector"
Você pode ver todas as variáveis e funções criadas no R_GlobalEnv.
A lista acima pode variar dependendo do código histórico que você executar no RStudio.
Observe que n, o argumento da função square_function não está neste ambiente global.
Um novo ambiente é criado para cada função. No exemplo acima, a função `square_function()` cria um novo ambiente dentro do... ambiente global.
Para esclarecer a diferença entre global e local ambiente, vamos estudar o seguinte exemplo
Essas funções pegam um valor x como argumento e o adicionam a y definido fora e dentro da função

A função f retorna a saída 15. Isso ocorre porque y é definido no ambiente global. Qualquer variável definida no ambiente global pode ser usada localmente. A variável y tem o valor 10 durante todas as chamadas de função e está acessível a qualquer momento.
Vamos ver o que acontece se a variável y for definida dentro da função.
Precisamos eliminar `y` antes de executar este código usando rm r
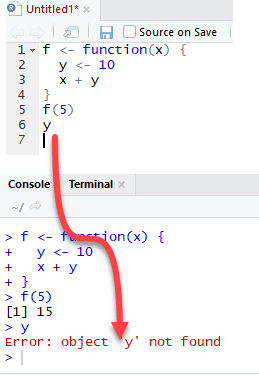
A saída também é 15 quando chamamos f(5), mas retorna um erro quando tentamos imprimir o valor y. A variável y não está no ambiente global.
Finalmente, R usa a definição de variável mais recente para passar dentro do corpo de uma função. Vamos considerar o seguinte exemplo:

R ignora os valores y definidos fora da função porque criamos explicitamente uma variável y dentro do corpo da função.
Função multiargumentos
Podemos escrever uma função com mais de um argumento. Considere a função chamada “tempos”. É uma função simples que multiplica duas variáveis.
times <- function(x,y) {
  x*y
	}
times(2,4)
Saída:
## [1] 8
Quando devemos escrever a função?
Cientistas de dados precisam realizar muitas tarefas repetitivas. Na maioria das vezes, copiamos e colamos trechos de código repetidamente. Por exemplo, a normalização de uma variável é altamente recomendada antes de executarmos uma análise. aprendizado de máquina algoritmo. A fórmula para normalizar uma variável é:

Já sabemos como usar as funções min() e max() em R. Usamos a biblioteca tibble para criar o quadro de dados. Até agora, Tibble é a função mais conveniente para criar um conjunto de dados do zero.
library(tibble)
# Create a data frame
data_frame <- tibble(
  c1 = rnorm(50, 5, 1.5),
  c2 = rnorm(50, 5, 1.5),
  c3 = rnorm(50, 5, 1.5),
)
Vamos proceder em duas etapas para calcular a função descrita acima. Na primeira etapa, criaremos uma variável chamada c1_norm, que representa o reescalonamento de c1. Na segunda etapa, basta copiar e colar o código de c1_norm e substituir os valores por c2 e c3.
Detalhe da função com a coluna c1:
Nominador:: data_frame$c1 -min(data_frame$c1))
Denominador: max(data_frame$c1)-min(data_frame$c1))
Portanto, podemos dividi-los para obter o valor normalizado da coluna c1:
(data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
Podemos criar c1_norm, c2_norm e c3_norm:
Create c1_norm: rescaling of c1
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
# show the first five values
head(data_frame$c1_norm, 5)
Saída:
## [1] 0.3400113 0.4198788 0.8524394 0.4925860 0.5067991
Funciona. Podemos copiar e colar
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
em seguida, altere c1_norm para c2_norm e c1 para c2. Fazemos o mesmo para criar c3_norm
data_frame$c2_norm <- (data_frame$c2 - min(data_frame$c2))/(max(data_frame$c2)-min(data_frame$c2))
data_frame$c3_norm <- (data_frame$c3 - min(data_frame$c3))/(max(data_frame$c3)-min(data_frame$c3))
Redimensionamos perfeitamente as variáveis c1, c2 e c3.
No entanto, esse método é propenso a erros. Podemos copiar e esquecer de alterar o nome da coluna depois de colar. Portanto, uma boa prática é escrever uma função sempre que precisar colar o mesmo código mais de duas vezes. Podemos reorganizar o código em uma fórmula e chamá-la sempre que necessário. Para escrever nossa própria função, precisamos fornecer:
- Nome: normalizar.
- o número de argumentos: precisamos apenas de um argumento, que é a coluna que usamos em nosso cálculo.
- O corpo: esta é simplesmente a fórmula que queremos retornar.
Procederemos passo a passo para criar a função normalizar.
Passo 1) Criamos o numerador, que é x – min(x). Em R, podemos armazenar o numerador em uma variável assim:
nominator <- x-min(x)
Passo 2) Calculamos o denominador: max(x) – min(x). Podemos replicar a ideia do passo 1 e armazenar o cálculo em uma variável:
denominator <- max(x)-min(x)
Passo 3) Realizamos a divisão entre o denominador e o denominador.
normalize <- nominator/denominator
Passo 4) Para retornar valor para a função de chamada, precisamos passar normalize dentro de return() para obter a saída da função.
return(normalize)
Passo 5) Estamos prontos para usar a função por meio de encapsulamento.ping Tudo que estiver dentro do parêntese.
normalize <- function(x){
  # step 1: create the nominator
  nominator <- x-min(x)
  # step 2: create the denominator
  denominator <- max(x)-min(x)
  # step 3: divide nominator by denominator
  normalize <- nominator/denominator
  # return the value
  return(normalize)
}
Vamos testar nossa função com a variável c1:
normalize(data_frame$c1)
Funciona perfeitamente. Criamos nossa primeira função.
Uma função é uma maneira mais abrangente de executar uma tarefa repetitiva. Podemos usar a fórmula de normalização em diferentes colunas, como abaixo:
data_frame$c1_norm_function <- normalize (data_frame$c1)
data_frame$c2_norm_function <- normalize	(data_frame$c2)
data_frame$c3_norm_function <- normalize	(data_frame$c3)
Embora o exemplo seja simples, podemos inferir o poder de uma fórmula. O código acima é mais fácil de ler e evita os erros que ocorrem ao colar código.
Funções com condição
A função normalize() sempre faz a mesma coisa. Às vezes, precisamos incluir condições em uma função para permitir que o código retorne saídas diferentes.
Nas tarefas de aprendizado de máquina, precisamos dividir o conjunto de dados entre um conjunto de treinamento e um conjunto de teste. O conjunto de trens permite que o algoritmo aprenda com os dados. Para testar o desempenho do nosso modelo, podemos usar o conjunto de testes para retornar a medida de desempenho. R não possui uma função para criar dois conjuntos de dados. Podemos escrever nossa própria função para fazer isso. Nossa função recebe dois argumentos e é chamada split_data(). A ideia por trás é simples: multiplicamos o comprimento do conjunto de dados (ou seja, número de observações) por 0.8. Por exemplo, se quisermos dividir o conjunto de dados 80/20, e nosso conjunto de dados contiver 100 linhas, então nossa função irá multiplicar 0.8*100 = 80. 80 linhas serão selecionadas para se tornarem nossos dados de treinamento.
Usaremos o conjunto de dados de qualidade do ar para testar nossa função definida pelo usuário. O conjunto de dados de qualidade do ar possui 153 linhas. Podemos ver isso com o código abaixo:
nrow(airquality)
Saída:
## [1] 153
Procederemos da seguinte forma:
split_data <- function(df, train = TRUE)
Arguments:
-df: Define the dataset
-train: Specify if the function returns the train set or test set. By default, set to TRUE
Nossa função tem dois argumentos. O trem de argumentos é um parâmetro booleano. Se estiver definido como TRUE, nossa função cria o conjunto de dados de trem, caso contrário, cria o conjunto de dados de teste.
Podemos prosseguir como fizemos com a função normalize(). Escrevemos o código como se fosse um código de execução única e, em seguida, envolvemos tudo, incluindo a condição, no corpo da função para criar a função.
Passo 1:
Precisamos calcular o comprimento do conjunto de dados. Isso é feito com a função nrow(). Nrow retorna o número total de linhas no conjunto de dados. Chamamos o comprimento variável.
length<- nrow(airquality)
length
Saída:
## [1] 153
Passo 2:
Multiplicamos o comprimento por 0.8. Ele retornará o número de linhas a serem selecionadas. Deve ser 153 * 0.8 = 122.4
total_row <- length*0.8
total_row
Saída:
## [1] 122.4
Queremos selecionar 122 linhas entre as 153 linhas do conjunto de dados de qualidade do ar. Criamos uma lista contendo valores de 1 a total_row. Armazenamos o resultado na variável chamada split
split <- 1:total_row
split[1:5]
Saída:
## [1] 1 2 3 4 5
split escolhe as primeiras 122 linhas do conjunto de dados. Por exemplo, podemos ver que nossa variável split reúne os valores 1, 2, 3, 4, 5 e assim por diante. Esses valores serão o índice quando selecionarmos as linhas a serem retornadas.
Passo 3:
Precisamos selecionar as linhas no conjunto de dados de qualidade do ar com base nos valores armazenados na variável de divisão. Isso é feito assim:
train_df <- airquality[split, ]
head(train_df)
Saída:
##[1]    Ozone Solar.R Wind Temp Month Day
##[2]  51    13     137 10.3   76     6  20
##[3]  15    18      65 13.2   58     5  15
##[4]  64    32     236  9.2   81     7   3
##[5]  27    NA      NA  8.0   57     5  27
##[6]  58    NA      47 10.3   73     6  27
##[7]  44    23     148  8.0   82     6  13
Passo 4:
Podemos criar o conjunto de dados de teste usando as linhas restantes, 123:153. Isso é feito usando – na frente de split.
test_df <- airquality[-split, ]
head(test_df)
Saída:
##[1] Ozone Solar.R Wind Temp Month Day
##[2]  123    85     188  6.3   94     8  31
##[3]  124    96     167  6.9   91     9   1
##[4]  125    78     197  5.1   92     9   2
##[5]  126    73     183  2.8   93     9   3
##[6]  127    91     189  4.6   93     9   4
##[7]  128    47      95  7.4   87     9   5
Passo 5:
Podemos criar a condição dentro do corpo da função. Lembre-se, temos um trem de argumentos que é um booleano definido como TRUE por padrão para retornar o conjunto de trens. Para criar a condição, usamos a sintaxe if:
  if (train ==TRUE){
    train_df <- airquality[split, ]
      return(train)
  } else {
    test_df <- airquality[-split, ]
      return(test)
  }
É isso, podemos escrever a função. Precisamos apenas alterar a qualidade do ar para df porque queremos testar nossa função para qualquer quadro de dados, não apenas qualidade do ar:
split_data <- function(df, train = TRUE){
  length<- nrow(df)
  total_row <- length *0.8
  split <- 1:total_row
  if (train ==TRUE){
    train_df <- df[split, ]
      return(train_df)
  } else {
    test_df <- df[-split, ]
      return(test_df)
  }
}
Vamos testar nossa função no conjunto de dados de qualidade do ar. Devemos ter um conjunto de treinamento com 122 linhas e um conjunto de teste com 31 linhas.
train <- split_data(airquality, train = TRUE)
dim(train)
Saída:
## [1] 122 6
test <- split_data(airquality, train = FALSE)
dim(test)
Saída:
## [1] 31 6
