
Tutorial de dplyr em R: Mesclar e unir dados com exemplos
 Equipe editorial
⚡ Resumo Inteligente
O pacote dplyr mescla e une data frames em R com quatro verbos: left_join(), right_join(), inner_join() e full_join(). Seu pacote complementar, tidyr, então remodela o resultado da junção usando gather(), spread(), separate() e unite().
Introdução à análise de dados
Antes de qualquer junção ou reshaping O verbo faz sentido, ajuda a entender onde a manipulação de dados se encaixa. A análise dos dados pode ser dividido em três partes:
- Processo de: Primeiro, precisamos coletar dados de muitas fontes e combiná-los.
- Transformam: Esta etapa envolve a manipulação de dados. Depois de consolidarmos todas as fontes de dados, podemos começar a limpar os dados.
- Visualize: O último passo é visualizar nossos dados para verificar irregularidades.
O diagrama abaixo mostra como as três etapas se conectam.
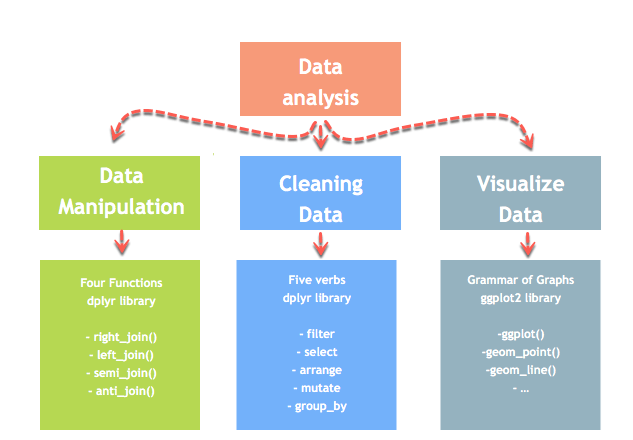
Um dos maiores desafios enfrentados por cientistas de dados é a manipulação de dados. Os dados nunca estão disponíveis no formato desejado. Os cientistas de dados precisam dedicar pelo menos metade do seu tempo à limpeza e manipulação dos dados. Essa é uma das tarefas mais críticas do trabalho. Se o processo de manipulação de dados não for completo, preciso e rigoroso, o modelo não funcionará corretamente.
R dplyr
O R possui um pacote chamado dplyr que lida com a transformação de dados. Ele é construído em torno de um pequeno conjunto de verbos principais — filter(), select(), arrange(), mutate() e summarise() — além de uma família de funções de junção. Uma vez que os dados estejam no formato correto, o ggplot2 pode visualizá-los.
Vamos aprender como usar o pacote dplyr para manipular um Quadro de dadosSe o R ainda não estiver instalado, siga as instruções. Etapas de configuração do R e do RStudio, em seguida, execute install.packages(“dplyr”).
Mesclar dados com dplyr
dplyr fornece uma maneira agradável e conveniente de combinar conjuntos de dados. Podemos ter muitas fontes de dados de entrada e, em algum momento, precisaremos combiná-las. Uma junção com dplyr adiciona variáveis à direita do conjunto de dados original.
dplyr entra
A seguir, apresentamos quatro tipos importantes de junções usadas no dplyr para mesclar dois conjuntos de dados. Todas as quatro utilizam os mesmos argumentos — as duas tabelas e a chave — e diferem apenas em quais linhas não correspondentes permanecem:
| função | Objetivo | Argumentos | Chaves múltiplas |
|---|---|---|---|
| Associação à esquerda() | Mesclar dois conjuntos de dados. Mantenha todas as observações da tabela de origem | x, y, by = “ID” | x, y, by = c(“ID”, “ID2”) |
| right_join() | Mesclar dois conjuntos de dados. Mantenha todas as observações da tabela de destino | x, y, by = “ID” | x, y, by = c(“ID”, “ID2”) |
| junção interna() | Mesclar dois conjuntos de dados. Excluir todas as linhas não correspondentes. | x, y, by = “ID” | x, y, by = c(“ID”, “ID2”) |
| full_join() | Mesclar dois conjuntos de dados. Manter todas as observações. | x, y, by = “ID” | x, y, by = c(“ID”, “ID2”) |
Esses quatro verbos correspondem às junções ESQUERDA, DIREITA, INTERNA e EXTERNA COMPLETA de SQLO R base alcança os mesmos resultados através dos argumentos all, all.x e all.y de mesclar ().
Vamos estudar todos os tipos de junção por meio de um exemplo simples.
Primeiramente, construímos dois conjuntos de dados. A Tabela 1 contém duas variáveis, ID e y, enquanto a Tabela 2 reúne ID e z. Em cada situação, precisamos ter um par de chaves variável. No nosso caso, ID é o nosso chave variável. A função procurará valores idênticos em ambas as tabelas e vinculará os valores retornados à direita da tabela 1. A figura abaixo mostra as duas tabelas lado a lado.

library(dplyr)
df_primary <- tribble(
  ~ID, ~y,
   "A", 5,
   "B", 5,
   "C", 8,
   "D", 0,
  "F", 9)
df_secondary <- tribble(
  ~ID, ~z,
   "A", 30,
   "B", 21,
   "C", 22,
   "D", 25,
   "E", 29)
dplyr left_join()
A maneira mais comum de mesclar dois conjuntos de dados é usando a função `left_join()`. A imagem abaixo mostra que o par chave-valor corresponde às linhas A, B, C e D, enquanto E e F permanecem. Com `left_join()`, mantemos todas as linhas da tabela original e ignoramos as linhas que não possuem par chave-valor na tabela de destino. Em nosso exemplo, o valor E não existe na tabela 1, portanto, essa linha é descartada. O valor F vem da tabela de origem, então ele é mantido após a aplicação de `left_join()` e retorna NA na coluna z.
Exemplo de dplyr left_join()
O diagrama abaixo reproduz o que acontece durante uma junção à esquerda (left_join()).

left_join(df_primary, df_secondary, by ='ID')
Saída:
##
# A tibble: 5 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     F     9    NA
Observe que, quando ambas as tabelas contêm uma coluna com o mesmo nome, o dplyr as diferencia com os sufixos .x e .y mostrados acima.
dplyr right_join()
A função right_join() funciona exatamente como left_join(). A única diferença é a linha eliminada. O valor E, disponível no quadro de dados de destino, existe na nova tabela e assume o valor NA para a coluna y.
Exemplo de dplyr right_join()
O diagrama abaixo mostra a imagem espelhada.

right_join(df_primary, df_secondary, by = 'ID')
Saída:
##
# A tibble: 5 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     E    NA    29
dplyr inner_join()
Quando observações não correspondentes são completamente inúteis, podemos retornar só as linhas que existem em ambos conjuntos de dados. Esta é a escolha certa quando precisamos de um conjunto de dados completo e não queremos imputar valores ausentes com a média ou a mediana.
A função inner_join() entra em ação aqui. Ela exclui as linhas não correspondentes em ambos os lados.
Exemplo de dplyr inner_join()
O diagrama abaixo destaca os quatro IDs que sobrevivem à junção.

inner_join(df_primary, df_secondary, by ='ID')
Saída:
##
# A tibble: 4 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
dplyr full_join()
Por fim, a função full_join() mantém todas as observações e substitui os valores ausentes por NA.
Exemplo de dplyr full_join()
O diagrama abaixo mostra todos os IDs de ambas as tabelas que sobreviveram à junção.

full_join(df_primary, df_secondary, by = 'ID')
Saída:
## # A tibble: 6 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     F     9    NA
## 6     E    NA    29
Vários pares de chaves
Por último, mas não menos importante, podemos ter várias chaves em nosso conjunto de dados. Considere o seguinte conjunto de dados, onde temos os anos e uma lista de produtos comprados pelo cliente. A captura de tela abaixo mostra as duas tabelas e as colunas ID e ano que, juntas, identificam uma linha.
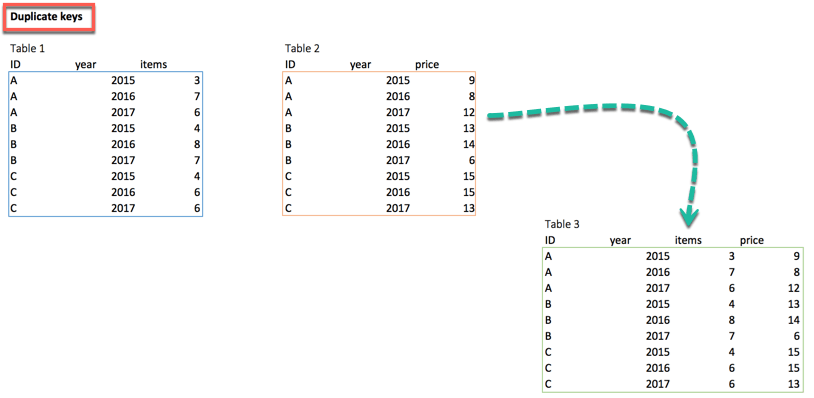
Se unirmos as duas tabelas apenas pelo ID, cada ano será comparado com todos os outros anos, resultando em um número excessivo de linhas. Para solucionar esse problema, podemos utilizar duas variáveis de chave-valor: ID e ano, que aparecem em ambos os conjuntos de dados. Podemos usar o seguinte código para mesclar a tabela 1 e a tabela 2:
df_primary <- tribble(
  ~ID, ~year, ~items,
  "A", 2015,3,
  "A", 2016,7,
  "A", 2017,6,
  "B", 2015,4,
  "B", 2016,8,
  "B", 2017,7,
  "C", 2015,4,
  "C", 2016,6,
  "C", 2017,6)
df_secondary <- tribble(
  ~ID, ~year, ~prices,
  "A", 2015,9,
  "A", 2016,8,
  "A", 2017,12,
  "B", 2015,13,
  "B", 2016,14,
  "B", 2017,6,
  "C", 2015,15,
  "C", 2016,15,
  "C", 2017,13)
left_join(df_primary, df_secondary, by = c('ID', 'year'))
Saída:
## # A tibble: 9 x 4
##      ID  year items prices
##   <chr> <dbl> <dbl>  <dbl>
## 1     A  2015     3      9
## 2     A  2016     7      8
## 3     A  2017     6     12
## 4     B  2015     4     13
## 5     B  2016     8     14
## 6     B  2017     7      6
## 7     C  2015     4     15
## 8     C  2016     6     15
## 9     C  2017     6     13
Desde o dplyr 1.1.0 (janeiro de 2023), a mesma chave pode ser escrita como join_by(ID, year), e o dplyr agora avisa sobre correspondências inesperadas de muitos para muitos, como o dplyr 1.1.0 entra no anúncio explica.
Funções de limpeza de dados em R
A fusão resolve apenas metade do problema, pois a tabela resultante ainda precisa ser remodelada. A seguir, apresentamos as quatro funções importantes para organizar (limpar) os dados:
| função | Objetivo | Argumentos |
|---|---|---|
| juntar() | Transforme os dados de largos em longos | (dados, chave, valor, na.rm = FALSE) |
| espalhar() | Transforme os dados de longos em largos | (dados, chave, valor) |
| separado() | Divida uma variável em duas. | (dados, col, into, sep = “”, remover = VERDADEIRO) |
| unir() | Unir duas variáveis em uma só. | (dados, col, conc, sep = “”, remover = VERDADEIRO) |
Nota de versão: As funções `gather()` e `spread()` foram substituídas por `pivot_longer()` e `pivot_wider()` no tidyr 1.0.0, e a função `separate()` pela família `separate_wider_delim()` no tidyr 1.3.0. As funções substituídas ainda funcionam, portanto todos os exemplos abaixo são válidos, mas novos códigos devem priorizar as famílias mais recentes mostradas no exemplo. vinheta giratória mais organizada. unite() permanece atual.
Utilizamos o pacote tidyr, parte da coleção tidyverse, para manipular, limpar e visualizar dados. Se o R foi instalado com o Anaconda, o pacote já está disponível em [link para o pacote]. https://anaconda.org/r/r-tidyr.
Se ainda não estiver instalado, digite o seguinte comando para instalar o tidyr:
install.packages("tidyr")
juntar()
O objetivo da função gather() é transformar os dados de formato amplo para formato longo.
Sintaxe
gather(data, key, value, na.rm = FALSE)
Arguments:
-data: The data frame used to reshape the dataset
-key: Name of the new column created
-value: Select the columns used to fill the key column
-na.rm: Remove missing values. FALSE by default
Exemplo
Abaixo, podemos visualizar o conceito de resha.ping De largo para comprido. Queremos criar uma única coluna chamada "crescimento", preenchida com as linhas das variáveis trimestrais. A figura abaixo mostra a tabela larga à esquerda e a tabela comprida remodelada à direita.

library(tidyr)
# Create a messy dataset
messy <- data.frame(
  country = c("A", "B", "C"),
  q1_2017 = c(0.03, 0.05, 0.01),
  q2_2017 = c(0.05, 0.07, 0.02),
  q3_2017 = c(0.04, 0.05, 0.01),
  q4_2017 = c(0.03, 0.02, 0.04))
messy
Saída:
##   country q1_2017 q2_2017 q3_2017 q4_2017
## 1       A    0.03    0.05    0.04    0.03
## 2       B    0.05    0.07    0.05    0.02
## 3       C    0.01    0.02    0.01    0.04
# Reshape the data
tidier <-messy %>%
gather(quarter, growth, q1_2017:q4_2017)
tidier
Saída:
##    country quarter growth
## 1        A q1_2017   0.03
## 2        B q1_2017   0.05
## 3        C q1_2017   0.01
## 4        A q2_2017   0.05
## 5        B q2_2017   0.07
## 6        C q2_2017   0.02
## 7        A q3_2017   0.04
## 8        B q3_2017   0.05
## 9        C q3_2017   0.01
## 10       A q4_2017   0.03
## 11       B q4_2017   0.02
## 12       C q4_2017   0.04
Na função gather(), criamos duas novas variáveis, quarter e growth, porque nosso conjunto de dados original tem uma variável de grupo, country, e os pares chave-valor. No tidyr 1.0.0 e versões posteriores, a mesma remodelação é escrita como pivot_longer(messy, cols = q1_2017:q4_2017, names_to = “quarter”, values_to = “growth”).
espalhar()
A função spread() faz o oposto da função gather().
Sintaxe
spread(data, key, value)
arguments:
data: The data frame used to reshape the dataset
key: Column to reshape long to wide
value: Rows used to fill the new column
Exemplo
Podemos remodelar o conjunto de dados mais organizado de volta ao estado desorganizado com spread().
# Reshape the data
messy_1 <- tidier %>%
  spread(quarter, growth)
messy_1
Saída:
##   country q1_2017 q2_2017 q3_2017 q4_2017
## 1       A    0.03    0.05    0.04    0.03
## 2       B    0.05    0.07    0.05    0.02
## 3       C    0.01    0.02    0.01    0.04
O equivalente moderno é pivot_wider(tidier, names_from = quarter, values_from = growth).
separado()
A função `separate()` divide uma coluna em duas de acordo com um separador. Essa função é útil em situações em que a variável é uma data. Nossa análise pode exigir foco no mês e no ano, e queremos separar a coluna em duas novas variáveis.
Sintaxe
separate(data, col, into, sep= "", remove = TRUE)
arguments:
-data: The data frame used to reshape the dataset
-col: The column to split
-into: The name of the new variables
-sep: Indicates the symbol used that separates the variable, i.e.:  "-", "_", "&"
-remove: Remove the old column. By default sets to TRUE.
Exemplo
Podemos dividir o trimestre do ano no conjunto de dados mais organizado aplicando a função separa().
separate_tidier <-tidier %>%
separate(quarter, c("Qrt", "year"), sep ="_")
head(separate_tidier)
Saída:
##   country Qrt year growth
## 1       A  q1 2017   0.03
## 2       B  q1 2017   0.05
## 3       C  q1 2017   0.01
## 4       A  q2 2017   0.05
## 5       B  q2 2017   0.07
## 6       C  q2 2017   0.02
unir()
A função unite() concatena duas colunas em uma só.
Sintaxe
unite(data, col, conc ,sep= "", remove = TRUE)
arguments:
-data: The data frame used to reshape the dataset
-col: Name of the new column
-conc: Name of the columns to concatenate
-sep: Indicates the symbol used that unites the variable, i.e:  "-", "_", "&"
-remove: Remove the old columns. By default, sets to TRUE
Exemplo
No exemplo acima, separamos o trimestre do ano. E se quisermos mesclá-los? Usamos o seguinte código:
unit_tidier <- separate_tidier %>%
  unite(Quarter, Qrt, year, sep ="_")
head(unit_tidier)
Saída:
##   country Quarter growth
## 1       A q1_2017   0.03
## 2       B q1_2017   0.05
## 3       C q1_2017   0.01
## 4       A q2_2017   0.05
## 5       B q2_2017   0.07
## 6       C q2_2017   0.02
O conjunto de dados remodelado está agora pronto para as etapas de modelagem abordadas no restante do documento. Série de tutoriais em R.
