
Quadro de dados R: como criar, anexar, selecionar e subconjunto
 Evelyn Clarke
⚡ Resumo Inteligente
O DataFrame do R armazena colunas de diferentes tipos com o mesmo comprimento, o que o torna a estrutura retangular padrão para análise. Os colchetes dividem linhas e colunas, o cifrão ($) seleciona uma coluna e a função subset() filtra por condição.
O que é um quadro de dados?
A quadro de dados é uma lista de vetores de mesmo comprimento. Uma matriz contém apenas um tipo de dado, enquanto um data frame aceita diferentes tipos de dados (numéricos, caracteres, fatores, etc.).
Essa definição coloca o quadro de dados entre dois vizinhos que você encontrará constantemente em R. matriz é retangular, mas de tipo único, e um Lista é de múltiplos tipos, mas irregular. O dataframe pega emprestada uma propriedade de cada tipo.
| Estrutura | Tipos de coluna | Comprimentos dos elementos | Uso típico |
|---|---|---|---|
| vetor | Apenas um tipo | Sequência única | Uma variável |
| Matriz | Apenas um tipo | Retangular | Álgebra numérica |
| Lista | Qualquer mistura de tipos | Pode variar de acordo com o elemento. | coleções arbitrárias |
| Quadro de dados | Qualquer mistura de tipos | Cada coluna tem o mesmo comprimento. | Análise tabular |
Como um data frame é, na verdade, uma lista internamente, os acessadores usados em listas também funcionam aqui, e é por isso que o símbolo de dólar aparece novamente mais adiante neste tutorial.
Como criar um quadro de dados
Podemos criar um dataframe em R Passando as variáveis a, b, c e d para a função data.frame(), podemos criar o data frame e nomear as colunas com names(), especificando simplesmente o nome de cada variável.
data.frame(df, stringsAsFactors = TRUE)
Argumentos:
- df: Pode ser uma matriz para converter como um quadro de dados ou uma coleção de variáveis para juntar
- stringsAsFactors: Controla se os vetores de caracteres se tornam colunas de fatores. O valor padrão original era TRUE em versões anteriores e passou a ser FALSE desde o R 4.0.0, portanto, passe-o explicitamente quando o comportamento for importante.
Podemos criar um dataframe em R para nosso primeiro conjunto de dados combinando quatro variáveis do mesmo comprimento.
# Create a, b, c, d variables
a <- c(10,20,30,40)
b <- c('book', 'pen', 'textbook', 'pencil_case')
c <- c(TRUE,FALSE,TRUE,FALSE)
d <- c(2.5, 8, 10, 7)
# Join the variables to create a data frame
df <- data.frame(a,b,c,d)
df
Saída:
##     a         b     c     d
## 1  10        book  TRUE   2.5
## 2  20         pen  FALSE  8.0
## 3  30    textbook  TRUE   10.0
## 4  40 pencil_case  FALSE  7.0
Cada vetor tornou-se uma coluna, e os quatro valores em cada vetor tornaram-se as quatro linhas. Observe que os argumentos não tinham nome, então o R derivou os cabeçalhos das colunas dos próprios nomes das variáveis.
Podemos ver que os cabeçalhos das colunas têm o mesmo nome das variáveis. Podemos alterar o nome da coluna em R com os nomes da função(). Verifique o exemplo de criação de dataframe do R abaixo:
# Name the data frame
names(df) <- c('ID', 'items', 'store', 'price')
df
Saída:
##   ID       items store price
## 1 10        book  TRUE   2.5
## 2 20         pen FALSE   8.0
## 3 30    textbook  TRUE  10.0
## 4 40 pencil_case FALSE   7.0
Atribuir um valor a names() substitui todos os cabeçalhos de uma só vez, portanto, o vetor de substituição deve ter exatamente uma entrada por coluna. Para renomear uma única coluna, acesse o vetor names, como em names(df)[2] <- 'product'.
# Print the structure
str(df)
Saída:
## 'data.frame':    4 obs. of  4 variables:
##  $ ID   : num  10 20 30 40
##  $ items: Factor w/ 4 levels "book","pen","pencil_case",..: 1 2 4 3
##  $ store: logi  TRUE FALSE TRUE FALSE
##  $ price: num  2.5 8 10 7
Nota de versão. O resultado acima foi produzido em uma versão do R anterior à 4.0.0, na qual a função `data.frame()` convertia vetores de caracteres em fatores por padrão, razão pela qual `items` é relatado como um fator com quatro níveis. A documentação básica do R registra que esse era o padrão de fábrica. alterado para stringsAsFactors = FALSE para R 4.0.0Executar o mesmo código em uma versão atual resulta em uma coluna de caracteres simples, e a função `str()` imprime "chr" em vez de "char". Adicione `stringsAsFactors = TRUE` à chamada de `data.frame()` para reproduzir a saída impressa ou leia o seguinte: tutorial de fator Para quando os fatores são realmente desejados.
Quadro de dados de fatia
Com a estrutura construída, a próxima tarefa é extrair partes dela. O fatiamento é a maneira básica do R de fazer isso e usa os mesmos colchetes que os vetores, só que com duas posições em vez de uma.
É possível fatiar os valores de um DataFrame. Selecionamos as linhas e colunas a serem retornadas dentro de colchetes, precedidos pelo nome do DataFrame.
Um quadro de dados é composto de linhas e colunas, df[A, B]. A representa as linhas e B as colunas. Podemos fatiar especificando as linhas e/ou colunas.
Na imagem 1 abaixo, a parte esquerda representa o filas, e a parte certa é a colunas. Observe que o símbolo : significa para. Por exemplo, 1:3 pretende selecionar valores de 1 para 3.

No diagrama abaixo, mostramos como acessar diferentes seleções do conjunto de dados:
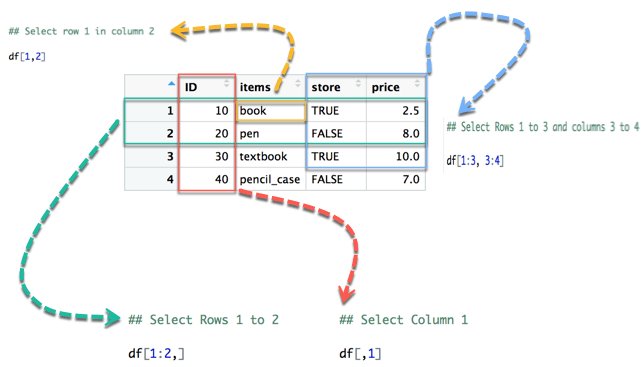
- A seta amarela seleciona o linha 1 em coluna 2
- A seta verde seleciona o linhas 1 a 2
- A seta vermelha seleciona o coluna 1
- A seta azul seleciona o linhas 1 a 3 e colunas 3 a 4
Observe que, se deixarmos a parte esquerda em branco, R selecionará todas as linhas. Por analogia, se deixarmos a parte direita em branco, R selecionará todas as colunas.
Podemos executar o código no console:
## Select row 1 in column 2
df[1,2]
Saída:
## [1] book
## Levels: book pen pencil_case textbook
A linha Levels aparece porque items é um fator nesta sessão. No R 4.0.0 e versões posteriores, a mesma chamada imprime a string única “book” sem a linha Levels.
## Select Rows 1 to 2
df[1:2,]
Saída:
##   ID items store price
## 1 10  book  TRUE   2.5
## 2 20   pen FALSE   8.0
## Select Columns 1
df[,1]
Saída:
## [1] 10 20 30 40
Selecionar uma única coluna com `df[,1]` remove o contêiner do dataframe e retorna um vetor simples. Adicione `drop = FALSE`, como em `df[, 1, drop = FALSE]`, quando for necessário um dataframe com uma única coluna.
## Select Rows 1 to 3 and columns 3 to 4
df[1:3, 3:4]
Saída:
##   store price
## 1  TRUE   2.5
## 2 FALSE   8.0
## 3  TRUE  10.0
Também é possível selecionar as colunas pelos seus nomes. Por exemplo, o código abaixo extracPossui duas colunas: ID e loja.
# Slice with columns name
df[, c('ID', 'store')]
Saída:
##   ID store
## 1 10  TRUE
## 2 20 FALSE
## 3 30  TRUE
## 4 40 FALSE
Os nomes são mais seguros do que as posições no código de produção, porque inserir ou reordenar uma coluna muda silenciosamente a que df[, 3] se refere, enquanto df[, 'store'] continua apontando para os mesmos dados.
Anexar uma coluna ao quadro de dados
Você também pode adicionar uma coluna a um DataFrame. Para isso, utilize o símbolo $ para nomear a nova variável e adicionar uma coluna ao DataFrame em R.
# Create a new vector
quantity <- c(10, 35, 40, 5)

# Add `quantity` to the `df` data frame
df$quantity <- quantity
df
Saída:
##   ID       items store price quantity
## 1 10        book  TRUE   2.5       10
## 2 20         pen FALSE   8.0       35
## 3 30    textbook  TRUE  10.0       40
## 4 40 pencil_case FALSE   7.0        5
Observação: o número de elementos no vetor deve ser igual ao número de elementos no dataframe. Execute a seguinte instrução para adicionar uma coluna ao dataframe em R.
quantity <- c(10, 35, 40)
# Add `quantity` to the `df` data frame
df$quantity <- quantity
Dá erro:
Error in `lt;-.data.frame`(`*tmp*`, quantity, value = c(10, 35, 40))
replacement has 3 rows, data has 4
A mensagem nomeia o operador de substituição para data frames e indica ambas as contagens, informando exatamente o que precisa ser corrigido. O R só reutiliza uma substituição quando seu comprimento divide o número de linhas igualmente, razão pela qual um valor de comprimento 1, como `df$currency <- 'EUR'`, é aceito, enquanto um vetor de comprimento 3 com quatro linhas é rejeitado. `cbind()` adiciona uma coluna da mesma forma, e `rbind()` é seu equivalente para adicionar linhas.
Selecione uma coluna de um quadro de dados
Às vezes, precisamos armazenar uma coluna de um data frame para uso futuro ou realizar uma operação em uma coluna. Podemos usar o sinal $ para selecionar a coluna de um data frame.
# Select the column ID
df$ID
Saída:
## [1] 1 2 3 4
Leia essa saída com atenção. O ID foi construído a partir do vetor c(10, 20, 30, 40), portanto, um console em execução imprime 10 20 30 40 aqui; os números 1 2 3 4 mostrados acima são as posições das linhas, e não os valores armazenados. O [1] no início da linha é simplesmente o índice do primeiro elemento dessa linha, não fazendo parte dos dados.
Três rotas alcançam a mesma coluna: df$ID, df[['ID']] e df[, 'ID']. O cifrão realiza uma correspondência parcial, então df$I ainda encontraria ID, o que é conveniente no console, mas arriscado em um script salvo.
Subconjunto de um quadro de dados
Na seção anterior, selecionamos uma coluna inteira sem condição. É possível subconjunto com base no fato de uma determinada condição ser verdadeira ou não.
Usamos a função subset().
subset(x, condition)
arguments:
- x: data frame used to perform the subset
- condition: define the conditional statement
Queremos devolver apenas os itens com preço superior a 5, então podemos fazer o seguinte:
# Select price above 5
subset(df, subset = price > 5)
Saída:
ID       items store price
2 20         pen FALSE     8
3 30    textbook  TRUE    10
4 40 pencil_case FALSE     7
Os rótulos de linha 2, 3 e 4 são os nomes de linha originais herdados de `df`, o que permite identificar que a primeira linha foi filtrada. A função `subset()` também aceita um argumento `select` para escolher colunas simultaneamente, e a forma equivalente entre colchetes é `df[df$price > 5, ]`. A forma entre colchetes mantém as linhas com valor NA onde a condição não é atendida, enquanto a função `subset()` as descarta; portanto, as duas nem sempre são intercambiáveis.
