
ANOVA em R: Teste de uma e duas vias com exemplos
 Equipe editorial
⚡ Resumo Inteligente
A ANOVA em R compara as médias de três ou mais grupos, dividindo a variação total em componentes entre grupos e dentro de grupos. Este passo a passo executa testes de uma e duas vias no conjunto de dados de venenos, verifica as premissas e isola os pares divergentes com o teste de Tukey HSD.
O que é ANOVA?
Análise de variação A Análise de variância (ANOVA) é uma técnica estatística usada para comparar as médias de dois ou mais grupos. O teste funciona dividindo a variação total de uma medida na parte explicada pela participação no grupo e na parte restante, considerada ruído aleatório. Portanto, a ANOVA em R informa se pelo menos uma média de grupo difere das demais, e não qual delas. É uma extensão direta da análise de variância. teste t para situações em que a variável fatorial possui mais de dois níveis.
Antes de realizar um teste, é útil saber qual membro da família ANOVA se adequa ao seu projeto.
Tipos de testes ANOVA em R
A “ANOVA” é uma família de testes, e não um procedimento único. A escolha do membro correto depende da quantidade de fatores presentes e da forma como os dados foram coletados.
| Testar | Quando usar | Chamada R |
|---|---|---|
| ANOVA unilateral | Um fator com três ou mais níveis | aov(y ~ x, dados = df) |
| ANOVA de duas vias | Dois fatores independentes | aov(y ~ x1 + x2, dados = df) |
| Interação bidirecional | O efeito de um fator depende do outro. | aov(y ~ x1 * x2, dados = df) |
| ANOVA de medidas repetidas | Os mesmos indivíduos foram medidos mais de uma vez. | aov(y ~ x + Erro(sujeito/x)) |
| ANCOVA | Uma covariável contínua deve ser controlada. | aov(y ~ x + covariável, dados = df) |
| MANOVA | Duas ou mais variáveis de resposta simultaneamente | manova(cbind(y1, y2) ~ x) |
Este tutorial aborda as três primeiras variantes. As variantes restantes usam a mesma interface aov(), portanto, uma vez que você consiga ler uma tabela de saída, poderá ler todas.
ANOVA versus teste t no R: principais diferenças
Ambos os testes comparam médias, portanto, é importante ser preciso sobre onde um substitui o outro.
| Critérios | Teste T | ANOVA |
|---|---|---|
| Número de grupos | Exatamente dois | Dois ou mais |
| Estatística de teste | t | F, igual a t ao quadrado quando existem dois grupos |
| Resultado | Indica a direção da diferença. | Apenas relatos indicam que existe uma diferença. |
| É necessário acompanhamento. | nenhum | Teste post hoc como Tukey HSD |
| Função R | t.teste() | aov() |
A tentação com três grupos é realizar três testes t separados. Resista a essa tentação. Cada teste tem sua própria taxa de erro de 5%, então três comparações elevam a chance de um falso positivo para aproximadamente 14%. A ANOVA responde à mesma pergunta com um único teste, e o teste de Tukey HSD lida com os detalhes das comparações aos pares, mantendo a taxa de erro sob controle. Para o caso de dois grupos, veja o [referência]. Tutorial sobre o teste t.
ANOVA unilateral
Existem muitas situações em que você precisa comparar a média entre vários grupos. Por exemplo, o departamento de marketing quer saber se três equipes têm o mesmo desempenho de vendas.
- Equipe: fator de 3 níveis: A, B e C
- Venda: uma medida de desempenho
O teste ANOVA pode dizer se os três grupos têm desempenhos semelhantes.
Para esclarecer se os dados vêm da mesma população, você pode realizar uma análise de variância unidirecional (ANOVA de uma via daqui em diante). Como qualquer outro teste estatístico, ele fornece evidências sobre se a hipótese nula (H0) pode ser rejeitada. Observe que não rejeitar H0 não é o mesmo que provar que ela é verdadeira.
Hipótese no teste ANOVA unidirecional
- H0: As médias entre os grupos são idênticas
- H1: Pelo menos a média de um grupo é diferente
Em outras palavras, não rejeitar H0 significa que não há evidências suficientes para concluir que a média de qualquer grupo difere das demais.
Este teste é semelhante ao teste t, mas a ANOVA é a escolha correta quando há mais de dois grupos. Com exatamente dois grupos, os dois testes são equivalentes e a estatística F é igual ao quadrado da estatística t.
Pressupostos
A ANOVA de uma via baseia-se em três condições: as observações são amostradas aleatoriamente e independentes entre si, os resíduos dentro de cada grupo têm distribuição aproximadamente normal e a variância é a mesma em todos os grupos (homogeneidade da variância). A seção sobre verificação das premissas abaixo mostra como testar cada uma delas no R.
Interpretar teste ANOVA
A estatística F é usada para testar se os dados são de populações significativamente diferentes, ou seja, diferentes médias amostrais.
Para calcular a estatística F, você precisa dividir o variabilidade entre grupos sobre o variabilidade dentro do grupo.
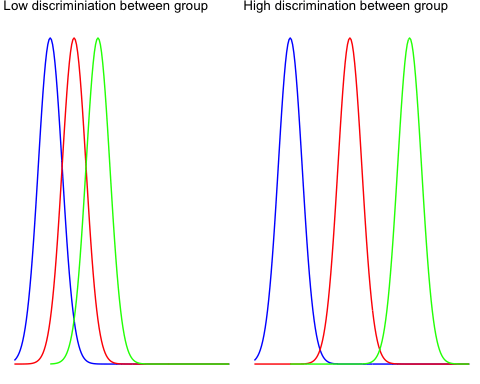
O entre grupos A variabilidade reflete a distância entre a média de cada grupo e a média geral. Compare os dois gráficos abaixo para entender melhor.
O gráfico da esquerda mostra muito pouca variação entre os três grupos, portanto, as médias dos três grupos estão próximas umas das outras. global significar.
O gráfico à direita mostra três distribuições muito distantes entre si, sem sobreposição, portanto a diferença entre a média geral e a média de cada grupo é grande.
O dentro do grupo A variabilidade mede o quanto as observações individuais se distanciam da média do seu próprio grupo. Alguns pontos ficam muito distantes da média do grupo, e o termo intragrupo captura exatamente essa dispersão, que é o erro amostral.
Para entender visualmente o conceito de variabilidade dentro do grupo, observe o gráfico abaixo.
A parte esquerda do gráfico mostra a distribuição de três grupos diferentes. Você aumentou a dispersão de cada amostra e fica claro que a variância individual é grande. O valor da estatística F diminui, portanto, você não rejeitaria a hipótese nula.
A parte direita mostra amostras com as mesmas médias, mas com uma dispersão muito menor. Isso aumenta a estatística F e aponta a favor da hipótese alternativa.

Você pode usar ambas as medidas para construir as estatísticas F. É muito intuitivo entender a estatística F. Se o numerador aumentar, significa que a variabilidade entre grupos é alta e é provável que os grupos da amostra sejam retirados de distribuições completamente diferentes.
Em outras palavras, um valor baixo na estatística F indica pouca ou nenhuma diferença significativa entre as médias dos grupos.
Exemplo de teste ANOVA unidirecional
Você usará o conjunto de dados venenosos para implementar o teste ANOVA unidirecional. O conjunto de dados contém 48 linhas e 3 variáveis:
- Tempo: Tempo de sobrevivência do animal
- veneno: Tipo de veneno usado: nível de fator: 1,2 e 3
- tratar: Tipo de tratamento utilizado: nível de fator: 1,2 e 3
Antes de começar a calcular o teste ANOVA, você precisa preparar os dados da seguinte forma:
- Etapa 1: importe os dados
- Etapa 2: remover variáveis desnecessárias
- Etapa 3: Converta a variável veneno como nível ordenado
library(dplyr)
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/poisons.csv"
df <- read.csv(PATH) %>%
select(-X) %>%
mutate(poison = factor(poison, ordered = TRUE))
glimpse(df)
Saída:
## Observations: 48
## Variables: 3
## $ time   <dbl> 0.31, 0.45, 0.46, 0.43, 0.36, 0.29, 0.40, 0.23, 0.22, 0...
## $ poison <ord> 1, 1, 1, 1, 2, 2, 2, 2, 3, 3, 3, 3, 1, 1, 1, 1, 2, 2, 2...
## $ treat  <fctr> A, A, A, A, A, A, A, A, A, A, A, A, B, B, B, B, B, B, ...
Nosso objetivo é testar a seguinte suposição:
- H0: Não há diferença na média do tempo de sobrevivência entre os grupos
- H1: A média do tempo de sobrevivência é diferente para pelo menos um grupo.
Em outras palavras, você quer saber se existe uma diferença estatística entre a média do tempo de sobrevivência de acordo com o tipo de veneno administrado ao porquinho-da-índia.
Você procederá da seguinte forma:
- Etapa 1: verifique o formato da variável veneno
- Etapa 2: Imprimir a estatística resumida: contagem, média e desvio padrão
- Etapa 3: traçar um gráfico de caixa
- Etapa 4: calcular o teste ANOVA unidirecional
- Etapa 5: Execute uma comparação par a par com o teste de Tukey HSD.
Passo 1) Verifique os níveis de veneno com o código abaixo. Você deverá ver três valores de caracteres, pois o verbo `mutate` converteu a coluna em um fator ordenado.
levels(df$poison)
Saída:
## [1] "1" "2" "3"
Passo 2) Você calcula a média e o desvio padrão.
df %>%
	group_by(poison) %>%
	summarise(
		count_poison = n(),
		mean_time = mean(time, na.rm = TRUE),
		sd_time = sd(time, na.rm = TRUE)
	)
Saída:
##
# A tibble: 3 x 4
##   poison count_poison mean_time    sd_time
##    <ord>        <int>     <dbl>      <dbl>
## 1      1           16  0.617500 0.20942779
## 2      2           16  0.544375 0.28936641
## 3      3           16  0.276250 0.06227627
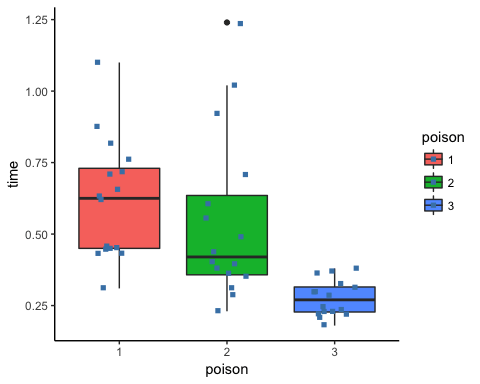
Passo 3) Na etapa três, você pode verificar graficamente se há diferença entre as distribuições. Observe que você inclui o ponto instável.
ggplot(df, aes(x = poison, y = time, fill = poison)) +
    geom_boxplot() +
    geom_jitter(shape = 15,
        color = "steelblue",
        position = position_jitter(0.21)) +
    theme_classic()
Saída:
Passo 4) Você pode executar o teste ANOVA unidirecional com o comando aov. A sintaxe básica para um teste ANOVA é:
aov(formula, data)
Arguments:
- formula: The equation you want to estimate
- data: The dataset used
A sintaxe da fórmula é:
y ~ X1+ X2+...+Xn # X1 +  X2 +... refers to the independent variables
y ~ . # use all the remaining variables as independent variables
Agora você pode responder à pergunta: existe alguma diferença no tempo de sobrevivência entre os porquinhos-da-índia, considerando o tipo de veneno administrado?
Armazene o modelo em um objeto e passe-o para summary() para obter uma impressão legível dos resultados.
anova_one_way <- aov(time~poison, data = df)
summary(anova_one_way)
Code Explicação
- aov(time ~ Poison, data = df): Execute o teste ANOVA com a seguinte fórmula
- summary(anova_one_way): Imprime o resumo do teste
Saída:
##             Df Sum Sq Mean Sq F value   Pr(>F)
## poison       2  1.033  0.5165   11.79 7.66e-05 ***
## Residuals   45  1.972  0.0438
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
O valor p é 7.66e-05, muito abaixo do limite usual de 0.05, e os três asteriscos indicam o nível de significância mais alto. Você pode rejeitar H0 e concluir que pelo menos um grupo de envenenamento apresenta um tempo médio de sobrevivência diferente.
Como verificar as premissas da ANOVA no R
O valor p da ANOVA só é confiável quando as três condições listadas anteriormente são satisfeitas. Cada uma delas possui uma verificação direta no R, e todas são executadas no objeto do modelo ajustado.
1. Independência das observações. Essa é uma característica do desenho do estudo, não dos dados, portanto nenhum teste pode corrigi-la. Cada cobaia deve ser medida uma única vez e alocada ao seu grupo aleatoriamente. Se o mesmo sujeito aparecer em várias linhas, você precisa de um modelo de medidas repetidas.
2. Normalidade dos resíduos. A ANOVA pressupõe que os resíduos, e não os dados brutos, seguem uma distribuição aproximadamente normal. Inspecione o gráfico QQ e confirme com o teste de Shapiro-Wilk.
par(mfrow = c(2, 2))
plot(anova_one_way)          # four diagnostic plots

shapiro.test(residuals(anova_one_way))
Os pontos próximos à diagonal do gráfico QQ normal indicam resíduos com distribuição normal. Um valor p de Shapiro-Wilk acima de 0.05 significa que não é possível rejeitar a normalidade.
3. Homogeneidade da variância. Cada grupo deve apresentar uma dispersão semelhante. O gráfico de Resíduos vs. Valores Ajustados deve ter o formato de uma faixa plana, e não de um funil. Confirme isso com o teste de Levene, que é mais robusto à não normalidade do que o teste de Bartlett.
library(car)
leveneTest(time ~ poison, data = df)

bartlett.test(time ~ poison, data = df)
Um valor p acima de 0.05 indica variâncias iguais.
O que fazer quando uma suposição falha. Se as variâncias forem desiguais, execute `oneway.test(time ~ poison, data = df, var.equal = FALSE)`, a correção de Welch. Se os resíduos forem claramente não normais e a amostra for pequena, utilize o teste de Kruskal-Wallis, `kruskal.test(time ~ poison, data = df)`. Com amostras grandes e balanceadas, a ANOVA é bastante robusta a desvios moderados da normalidade, portanto, um resultado limítrofe no teste de Shapiro-Wilk raramente é fatal.
Comparação parelha
Um teste F significativo indica que as médias dos grupos não são todas iguais, mas não especifica qual par difere. O teste de Tukey para Diferença Significativa Honesta responde a essa pergunta comparando todos os pares e controlando a taxa de erro familiar.
TukeyHSD(anova_one_way)
Saída:

Leia a saída uma linha por par. diff A coluna contém a diferença entre as médias dos dois grupos. lwr e simplif delimitar o intervalo de confiança de 95% para essa diferença, e p adj é o valor p ajustado para comparações múltiplas. Um par difere significativamente quando seu intervalo exclui o zero, ou seja, quando p ajustado é inferior a 0.05. Neste conjunto de dados, as comparações envolvendo o veneno 3 são as significativas, o que corresponde ao gráfico de caixa: o grupo 3 apresenta um tempo médio de sobrevivência claramente menor do que os grupos 1 e 2, enquanto os grupos 1 e 2 são estatisticamente indistinguíveis entre si.
ANOVA de duas vias
A ANOVA de duas vias adiciona um segundo fator à fórmula. Ela funciona exatamente como o teste de uma via, apenas a fórmula muda:
y ~ x1 + x2
Aqui, y é a variável de resposta quantitativa, enquanto x1 e x2 são fatores categóricos.
Hipótese no teste ANOVA bidirecional
- H0: As médias dos grupos são iguais para ambas as variáveis fatoriais.
- H1: Pelo menos uma das médias dos grupos difere para pelo menos um dos dois fatores.
Você adiciona a variável de tratamento ao modelo. Essa variável registra o tratamento administrado ao porquinho-da-índia. A fórmula aditiva abaixo testa se cada fator afeta o tempo de sobrevivência por si só, após considerar o outro.
Ajuste o código adicionando "tratar" junto com a primeira variável independente.
anova_two_way <- aov(time~poison + treat, data = df)
summary(anova_two_way)
Saída:
##             Df Sum Sq Mean Sq F value  Pr(>F)
## poison       2 1.0330  0.5165   20.64 5.7e-07 ***
## treat        3 0.9212  0.3071   12.27 6.7e-06 ***
## Residuals   42 1.0509  0.0250
## ---
Ambos os valores p (5.7e-07 para o veneno e 6.7e-06 para o tratamento) estão muito abaixo de 0.05, portanto, você rejeita H0 para ambos os fatores e conclui que a alteração do veneno ou do tratamento afeta o tempo de sobrevivência.
Adicionando um termo de interação
O modelo aditivo acima pressupõe que o efeito do veneno seja o mesmo, independentemente do tratamento. Para testar essa suposição, substitua o sinal de mais por um asterisco, que representa tanto os efeitos principais quanto sua interação:
anova_interaction <- aov(time~poison * treat, data = df)
summary(anova_interaction)
Se a relação entre veneno e tratamento não for significativa, o modelo aditivo é a melhor escolha, pois utiliza menos graus de liberdade.
ANOVA em R: Guia Rápido de Referência de Testes
A tabela abaixo lista cada teste usado acima, a chamada do R que o executa e a hipótese que ele avalia:
| Testar | Code | Hipótese | Valor P |
|---|---|---|---|
| ANOVA unidirecional |
aov(y ~ X, data = df)
|
H1: A média é diferente para pelo menos um grupo | 0.05 |
| Emparelhados |
TukeyHSD(ANOVA summary) |
0.05 | |
| ANOVA bidirecional |
aov(y ~ X1 + X2, data = df)
|
H1: Pelo menos uma das médias dos grupos difere para algum dos fatores. | 0.05 |
