
Tutorial Hadoop Pig: O que é Apache Pig? Archiarquitetura, exemplo
 Prafulla Ranadive
⚡ Resumo Inteligente
O Apache Pig é uma plataforma de alto nível para analisar grandes conjuntos de dados no Hadoop, combinando a linguagem de fluxo de dados Pig Latin com um ambiente de execução que compila cada script em MapReduce, Tez ou outros formatos. Spark trabalhos automaticamente.
Este tutorial começa com a ideia por trás do Apache Pig e, em seguida, demonstra como instalá-lo e executar um script Pig Latin completo do início ao fim.
O que é Apache Pig?
Porco é um nível elevado linguagem de programação Útil para analisar grandes conjuntos de dados. O Pig foi resultado de um esforço de desenvolvimento no Yahoo!
Em um framework MapReduce, os programas precisam ser traduzidos em uma série de estágios Map e Reduce. No entanto, esse não é um modelo de programação com o qual os analistas de dados estejam familiarizados. Portanto, para superar essa lacuna, um modelo abstrato é necessário para facilitar a compreensão do modelo.tracA cidade chamada Pig foi construída em cima de Hadoop.
O Apache Pig permite que as pessoas se concentrem mais na análise de grandes conjuntos de dados e gastem menos tempo escrevendo programas MapReduce. Assim como os porcos, que comem de tudo, a linguagem de programação Apache Pig foi projetada para funcionar com qualquer tipo de dado. É por isso que o nome é Pig (porco)! O mascote do projeto, abaixo, reforça essa ideia.

O projeto ainda está ativo. Apache Pig 0.18.0 Foi lançado em 15 de setembro de 2025 e adiciona suporte para Hadoop 3, Tez 0.10, Hive 3, Spark 3, HBase 2 e Python 3, de acordo com o Página de lançamentos do Apache PigO passo a passo abaixo foi originalmente escrito para a versão 0.12.1, muito mais antiga, portanto, algumas etapas contêm uma observação indicando que a versão atual se comporta de maneira diferente.
Porco Archiarquitetura
A arquitetura do Pig consiste em dois componentes:
- Porco latim, que é uma linguagem
- Um ambiente de execução, para executar programas em Pig Latin.
Um programa em Pig Latin consiste em uma série de operações ou transformações aplicadas aos dados de entrada para produzir uma saída. Essas operações descrevem um fluxo de dados que é traduzido em uma representação executável pelo ambiente de execução Hadoop Pig. Subjacente a isso, os resultados dessas transformações são uma série de... MapaReduzir tarefas que um programador desconhece. Assim, de certa forma, o Pig no Hadoop permite que o programador se concentre nos dados em vez da natureza da execução.
O Pig Latin é uma linguagem relativamente rígida que utiliza palavras-chave familiares do processamento de dados, como Join, Group e Filter. O diagrama abaixo tracé um script que parte do shell do Grunt, passa pelo analisador sintático, otimizador e compilador até chegar ao mecanismo de execução.

Modos de execução
O Pig no Hadoop possui dois modos de execução, e o passo a passo de instalação mais adiante utiliza ambos:
- Modo local: Nesse modo, a linguagem Hadoop Pig é executada em uma única instância. JVM e utiliza o sistema de arquivos local. Este modo é adequado apenas para análise de conjuntos de dados pequenos usando Pig no Hadoop.
- Modo MapReduce: Nesse modo, as consultas escritas em Pig Latin são traduzidas em tarefas MapReduce e executadas em um cluster Hadoop (o cluster pode ser pseudo-distribuído ou totalmente distribuído). O modo MapReduce com um cluster totalmente distribuído é útil para executar o Pig em grandes conjuntos de dados.
Esses dois formam o par clássico. As versões atuais expõem seis tipos de execução, ou exectypes, cada um selecionado com o mesmo -x bandeira, conforme documentado em Guia de Introdução ao Pig 0.18.0.
| Tipo de execução | Command | Onde o trabalho é realizado |
|---|---|---|
| Locais | porco -x local | Uma única JVM contra o sistema de arquivos local |
| Tez local | porco -x tez_local | Uma única JVM usando o ambiente de execução Tez (experimental) |
| Spark local | porco -x faísca_local | Uma única JVM usando a Spark tempo de execução (experimental) |
| MapaReduzir | porco ou porco -x mapreduce | Um cluster Hadoop com HDFS; esta é a configuração padrão. |
| Tez | porco -x tez | Um cluster Hadoop executando o mecanismo Tez. |
| Spark | porco -x faísca | A Spark, cluster YARN ou Mesos com HDFS |
Tipos de dados em Pig Latin e Operatoros
Antes de escrever um script, é útil saber o que o Pig pode armazenar e o que ele pode fazer com os dados. O modelo de dados é totalmente aninhado, o que permite ao Pig ler arquivos de log e outras entradas com estrutura flexível que uma tabela relacional rejeitaria.
Pig Latin oferece duas famílias de tipos:
- Tipos escalares:
int,long,float,double,chararray,bytearray,boolean,datetime,bigintegerebigdecimalO script de exemplo mais adiante declara cada coluna comochararray. - Tipos complexos: a tupla é um conjunto ordenado de campos e se comporta como uma linha; um Bolsa é uma coleção não ordenada de tuplas e se comporta como uma tabela; uma mapa, é um conjunto de pares chave-valor cuja chave deve ser um
chararray.
Os operadores se enquadram em um número reduzido de funções, e um pequeno grupo deles é responsável por quase todos os oleodutos:
| Operator | O que ele faz |
|---|---|
| CARREGAR / ARMAZENAR | Leia uma relação do sistema de arquivos e escreva o resultado de volta. |
| FILTRO | Mantenha apenas as tuplas que correspondem a uma condição. |
| PARA CADA … GERAR | Trabalhe coluna por coluna, criando novos campos. |
| GRUPO / COGRUPO | Agrupe uma relação, ou duas ou mais relações, por uma chave. |
| Cadastre-se | Combine relações com uma junção interna ou externa. |
| UNIÃO / DIVISÃO | Combinar relações ou dividir uma em várias. |
| ORDENAR POR / DISTINTO / LIMITAR | Ordenar, remover duplicados e limitar o número de tuplas. |
| DESPEJAR / DESCREVER / EXPLICAR / ILUSTRAR | Inspecione resultados, esquemas, planos de execução e execuções de exemplo. |
Os quatro operadores de inspeção também possuem atalhos do Grunt, o que economiza tempo.ping Durante a depuração: \d para DUMP, \de para DESCRIBE, \e para EXPLICAR e \i para ILUSTRAÇÃO.
Pré-requisitos
O Pig é uma ferramenta do lado do cliente. Ele analisa um script, planeja o trabalho e submete tarefas, mas não fornece armazenamento ou um cluster próprio, portanto, é necessário ter uma instalação Hadoop funcionando. A lista de requisitos do Apache é curta.
| Componente | Exigência | Por que é necessário |
|---|---|---|
| Hadoop | Hadoop 2.x ou 3.x, com HADOOP_HOME exportado. | Fornece o HDFS e o mecanismo de execução. Sem o HADOOP_HOME, o Pig 0.18.0 utiliza o Hadoop 2.7.3 embutido. |
| Java | Java 1.7 ou posterior, com JAVA_HOME definido para o diretório raiz de instalação. | Pig e os daemons do Hadoop são Java programas |
| Python (Opcional) | Python 2.7 | Necessário apenas para streaming. Python funções definidas pelo usuário |
| Formiga (opcional) | Formiga 1.8 | Necessário apenas ao compilar ou recompilar o Pig a partir do código-fonte. |
Além dessa lista, há dois pontos práticos. Primeiro, execute tudo como um usuário Linux que já tenha um diretório home em HDFS e permissão para escrever nele; este tutorial usa hduser, a conta criada durante a configuração do Hadoop. Em segundo lugar, inicie o cluster antes de executar o Pig no modo MapReduce, pois o Pig falha imediatamente se o NameNode e o ResourceManager estiverem inativos. Se o Hadoop ainda não estiver instalado, siga as instruções em Como instalar o Hadoop em primeiro lugar.
Como baixar e instalar o Pig
Agora neste tutorial do Apache Pig, aprenderemos como baixar e instalar o Pig:
Antes de iniciarmos o processo propriamente dito, certifique-se de que o Hadoop esteja instalado. Altere o usuário para 'hduser' (o ID usado durante a configuração do Hadoop; você pode usar o ID de usuário utilizado na sua configuração do Hadoop).

Passo 1) Baixe a versão estável mais recente do Pig Hadoop de qualquer um dos sites espelho disponíveis em
https://pig.apache.org/releases.html
Selecione o arquivo tar.gz (e não o src.tar.gz) para fazer o download, conforme mostrado abaixo.

Passo 2) Após a conclusão do download, navegue até o diretório que contém o arquivo tar baixado e mova-o para o local onde deseja configurar o Pig Hadoop. Neste caso, vamos movê-lo para /usr/local.

Acesse o diretório que conterá os arquivos do Pig Hadoop.
cd /usr/local
ExtracO conteúdo do arquivo tar é o seguinte.
sudo tar -xvf pig-0.12.1.tar.gz

Passo 3) Modifique o arquivo ~/.bashrc para adicionar variáveis de ambiente relacionadas ao Pig.
Abra o arquivo ~/.bashrc em qualquer editor de texto de sua preferência e faça as modificações abaixo.
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

Passo 4) Agora, execute essa configuração de ambiente usando o comando abaixo.
. ~/.bashrc

Passo 5) Precisamos recompilar o Pig para que seja compatível com o Hadoop 2.2.0.
Aqui estão os passos para fazer isso.
Acesse o diretório inicial do Pig.
cd $PIG_HOME
Instalar Ant.
sudo apt-get install ant

Observação: o download será iniciado e levará um tempo dependendo da sua velocidade de internet.
Recompile o porco.
sudo ant clean jar-all -Dhadoopversion=23

Observe que, durante o processo de recompilação, vários componentes são baixados, portanto, o sistema deve estar conectado à internet.
Além disso, caso esse processo fique travado em algum ponto e você não veja nenhuma movimentação no prompt de comando por mais de 20 minutos, pressione Ctrl + C e execute o mesmo comando novamente.
No nosso caso, leva 20 minutos.

Esta etapa de recompilação pertence à era 0.12.1, quando os arquivos JAR distribuídos eram compilados para o Hadoop 1 e o -Dhadoopversion=23 A flag alterou a compilação do Ant para a linha Hadoop 0.23 e 2.x. O Apache Pig 0.18.0 inclui binários que já funcionam no Hadoop 2.7 e versões superiores, bem como no Hadoop 3; portanto, em uma versão atual, você normalmente pode descompactar o arquivo tar e ir direto para o teste abaixo.
Passo 6) Teste a instalação do Pig usando o comando
pig -help

Exemplo de script de porco
Com o Pig instalado, o restante deste tutorial do Apache Pig executa um script completo. Usaremos scripts Pig para encontrar o número de produtos vendidos em cada país.
Entrada: Nosso conjunto de dados de entrada é um arquivo CSV. VendasJan2009.csv.
Passo 1) Inicie o Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Passo 2) O Pig in Big Data lê um arquivo do HDFS no modo MapReduce e armazena os resultados de volta no HDFS.
Copie o arquivo SalesJan2009.csv (armazenado no sistema de arquivos local em ~/input/SalesJan2009.csv) para o diretório raiz do HDFS (Hadoop Distributed File System).
Neste exemplo do Apache Pig, o arquivo está na pasta `input`. Se o arquivo estiver armazenado em outro local, forneça esse nome.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

Verifique se o arquivo foi realmente copiado ou não.
$HADOOP_HOME/bin/hdfs dfs -ls /

Passo 3) Configuração do porco.
Primeiro, navegue até $PIG_HOME/conf e guarde uma cópia do arquivo de propriedades original.
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

Abra o arquivo pig.properties usando um editor de texto de sua preferência e especifique o caminho do arquivo de log usando pig.logfile.
sudo gedit pig.properties

O sistema de registro de erros utilizará este arquivo para registrá-los.
Passo 4) Execute o comando 'pig', que iniciará o prompt de comando do Pig, um shell interativo para consultas em Pig.
pig

Passo 5) No prompt de comando do Grunt para Pig, execute os comandos Pig abaixo na ordem indicada.
— A. Carregue o arquivo contendo dados.
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
Pressione Enter após este comando.
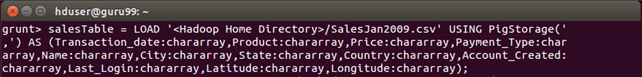
— B. Agrupe os dados pelo campo País.
GroupByCountry = GROUP salesTable BY Country;

— C. Para cada tupla em 'GroupByCountry', gere a string resultante no formato Nome do país: Nº de produtos vendidos.
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
Pressione Enter após este comando.
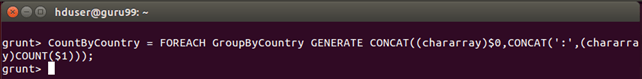
— D. Armazene os resultados do fluxo de dados no diretório 'pig_output_sales' no HDFS.
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

Este comando levará algum tempo para ser executado. Assim que terminar, você deverá ver a seguinte tela.

Passo 6) O resultado pode ser visualizado através da interface de comando como
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

Os resultados também podem ser visualizados através de uma interface web.
Abra http://localhost:50070/ em um navegador da web.
A porta 50070 é a da interface web do NameNode no Hadoop 2. O Hadoop 3 moveu a mesma página para a porta 9870, portanto, use esse endereço se o seu cluster estiver executando o Hadoop 3.

Agora selecione 'Procurar no sistema de arquivos' e navegue até /user/hduser/pig_output_sales.

Abra a parte r-00000 para ler os pares de país e quantidade de produtos gerados pelo script.

Apache Pig vs Hive vs MapReduce
O Pig raramente é avaliado isoladamente. A pergunta usual é se uma tarefa pertence ao Pig, em Colméia ou em um programa MapReduce escrito manualmente, já que os três acabam sendo executados como tarefas no mesmo cluster.
| Aspecto | MapReduce (Java) | Porco apache | Colmeia Apache |
|---|---|---|---|
| Interface | Java API | Pig Latin, uma linguagem de script para fluxo de dados. | HiveQLGenericName, um dialeto SQL |
| Nível de abdominaistracção | Baixo | Suporte: | Alto |
| Usuário típico | Java revelador | Engenheiro de dados ou pesquisador | Analista com experiência em SQL |
| Dados adequados | Qualquer coisa, manuseada manualmente. | Estruturado e semiestruturado; o esquema é opcional no momento do carregamento. | Tabelas estruturadas registradas em um metastore |
| Code volume | A maioria das linhas | Menos filas | Menor número de linhas para uma consulta |
| Executa como | Um trabalho MapReduce | Compila para MapReduce, Tez ou Spark empregos | Compila para MapReduce, Tez ou Spark empregos |
| Melhor em | Controle total e lógica personalizada | Pipelines ETL de múltiplas etapas | Consultas e relatórios ad hoc |
Na prática, a divisão é simples. Use o Hive quando os dados já estiverem organizados em uma tabela e a consulta parecer SQL. Use o Pig quando a entrada for complexa, quando o pipeline for uma cadeia de transformações em vez de uma única consulta ou quando o mesmo script precisar ramificar e recombinar. Use o MapReduce somente quando nenhuma das opções se aplicar.tracA expressão consegue transmitir a lógica, pois o número de linhas aumenta rapidamente.
O porco também convive harmoniosamente com o restante do ecossistema. Sqoop e Flume Os dados brutos são recebidos, o Pig ou o Hive os formatam e um agendador como... Apache Oozie encadeiam as etapas em um fluxo de trabalho repetível. Para uma visão mais ampla de onde essas ferramentas se encaixam, consulte o guia para dados grandes e o resumo de ferramentas de big dataPara uma alternativa comercial de ETL aos scripts escritos manualmente, consulte Talend.
