
Comandos Shell HBase com exemplos
 Equipe editorial
⚡ Resumo Inteligente
Os comandos do shell do HBase permitem gerenciar tabelas e dados diretamente de um prompt interativo, agrupados em comandos gerais, comandos de gerenciamento de tabelas, como create e drop, comandos de manipulação de dados, como put e get, e comandos de replicação de cluster.
Como interagir com o HBase usando comandos do shell e Java API
Após a instalação bem-sucedida do HBase sobre o Hadoop, obtemos um shell interativo para executar vários comandos e realizar diversas operações. Usando esses comandos, podemos executar múltiplas operações em tabelas de dados, o que proporciona maior eficiência no armazenamento de dados e interação flexível para o cliente.
Podemos interagir com o HBase de duas maneiras:
- Modo de shell interativo do HBase e
- Através da Java API.
No HBase, o modo de shell interativo é usado para interagir com o HBase para operações em tabelas, gerenciamento de tabelas e modelagem de dados. Usando o Java Com o modelo de API, podemos realizar todos os tipos de operações de tabela e dados no HBase. Podemos interagir com o HBase usando ambos os métodos. A única diferença entre os dois é que o Java A API usa Java O modo shell usa código para se conectar com o HBase, enquanto o modo shell usa comandos do shell para se conectar com o HBase.
Breve recapitulação do HBase antes de prosseguirmos:
- HBase usa Hadoop O HBase é um sistema de armazenamento que utiliza arquivos para guardar grandes quantidades de dados. Ele consiste em servidores mestre e servidores de região.
- Os dados que serão armazenados no HBase estarão na forma de regiões. Além disso, essas regiões serão divididas e armazenadas em vários servidores de região.
- Esses comandos do shell permitem ao programador definir esquemas de tabelas e operações de dados usando interação completa no modo shell.
- Qualquer comando que utilizarmos terá seu impacto no modelo de dados do HBase.
- Utilizamos comandos do shell do HBase em interpretadores de script do sistema operacional, como o shell Bash.
- O shell Bash é o interpretador de comandos padrão para a maioria dos sistemas. Linux e distribuições de sistemas operacionais Unix.
- As versões avançadas do HBase fornecem comandos de shell com referências orientadas a objetos no estilo JRuby para tabelas.
- Variáveis de referência de tabela podem ser usadas para realizar operações de dados no modo shell do HBase.
Por exemplo:
- Neste tutorial, criamos uma tabela na qual 'education' representa o nome da tabela e corresponde ao nome da coluna “guru99”.
- Em alguns comandos, “guru99” representa o próprio nome de uma tabela.
Comandos gerais
No HBase, os comandos gerais são categorizados nos seguintes comandos:
- Status
- Versão
- Table_help (varredura, eliminação, obtenção, colocação, desabilitação, etc.)
- Quem sou eu
Para acessar o shell de comandos do HBase, primeiro precisamos executar o código mencionado abaixo.
hbase Shell
Após acessar o shell do HBase, podemos executar todos os comandos mencionados abaixo. Com a ajuda desses comandos, podemos realizar todos os tipos de operações em tabelas no modo shell do HBase. O prompt do shell interativo aparece conforme mostrado abaixo:

Vejamos todos esses comandos e seu uso, um por um, com um exemplo.
Status
Syntax:status
Este comando fornecerá detalhes sobre o status do sistema, como o número de servidores presentes no cluster, a quantidade de servidores ativos e o valor médio de carga. Você também pode passar parâmetros específicos, dependendo do nível de detalhamento das informações que deseja obter sobre o sistema. Os parâmetros podem ser 'summary', 'simple' ou 'detailed'; o parâmetro padrão é “summary”.
Abaixo, mostramos como você pode passar diferentes parâmetros para o comando de status. Observando a captura de tela abaixo, teremos uma ideia melhor.
hbase(main):001:0>status
hbase(main):002:0>status 'simple'
hbase(main):003:0>status 'summary'
hbase(main):004:0> status 'detailed'
O resultado do status é mostrado abaixo:

Ao executarmos esse comando de status, ele fornece informações sobre o número de servidores presentes, servidores inativos e a carga média do servidor. Aqui, a captura de tela mostra informações como 1 servidor ativo, 1 servidor inativo e uma carga média de 7.0000.
Versão
Syntax: version
A versão exibida é mostrada abaixo:

- Este comando exibirá a versão do HBase atualmente em uso no modo de comando.
- Se você executar o comando de versão, ele exibirá a saída mostrada acima.
Tabela de ajuda
Syntax:table_help
A saída do comando `table_help` é mostrada abaixo:

Este comando orienta:
- O que são comandos referenciados por tabela e como usá-los.
- Ele fornecerá diferentes usos de comandos do shell do HBase e suas respectivas sintaxes.
- Na captura de tela acima, é possível ver a sintaxe dos comandos “create” e “get_table” e seus respectivos usos. Podemos manipular a tabela por meio desses comandos após sua criação no HBase.
- Isso fornecerá comandos de manipulação de tabelas, como put, get e todas as outras informações de comando.
whoami
Syntax: Whoami
A saída do comando `whoami` é mostrada abaixo:

O comando “whoami” é usado para retornar as informações do usuário atual do HBase no cluster HBase. Ele fornecerá informações como:
- Grupos presentes no HBase.
- As informações do usuário; por exemplo, neste caso, “hduser” representa o nome de usuário, conforme mostrado na captura de tela.
TTL (Tempo de Vida) – Atributo
No HBase, as famílias de colunas podem ser definidas para valores de tempo em segundos usando TTL. O HBase excluirá automaticamente as linhas assim que o tempo de expiração for atingido. Esse atributo se aplica a todas as versões de uma linha, inclusive à versão atual.
O tempo TTL codificado no HBase para a linha é especificado em UTC. Este atributo é usado com comandos de gerenciamento de tabelas. As principais diferenças entre o tratamento de TTL e os TTLs de famílias de colunas são apresentadas abaixo:
- Os TTLs das células são expressos em unidades de milissegundos em vez de segundos.
- O TTL de uma célula não pode estender a vida útil efetiva de uma célula além da configuração de TTL definida no nível da Família de Colunas.
Comandos de gerenciamento de tabelas
Esses comandos permitem que os programadores criem tabelas e esquemas de tabelas com famílias de linhas e colunas. A seguir, estão os comandos de gerenciamento de tabelas:
- Criar
- Lista
- Descrever
- Desabilitar
- Desativar_tudo
- Permitir
- Habilitar todos
- Cair
- Soltar_tudo
- Mostrar_filtros
- Idade
- Alterar_status
Vamos analisar os diversos usos de comandos no HBase com um exemplo.
Criar
Syntax: create <tablename>, <columnfamilyname>
Exemplo:-
hbase(main):001:0> create 'education' ,'guru99'
0 rows(s) in 0.312 seconds
=>Hbase::Table – education
O resultado do comando de criação é mostrado abaixo:

O exemplo acima explica como criar uma tabela no HBase com o nome especificado, de acordo com as especificações de cada família de colunas. Além disso, também podemos passar alguns atributos de escopo de tabela para ela. Para verificar se a tabela 'education' foi criada ou não, usamos o comando "list" abaixo. Veja também criando tabelas HBase com Java e concha.
Lista
Syntax:list
A lista de resultados é mostrada abaixo:

- O comando “list” exibirá todas as tabelas presentes ou criadas no HBase.
- A saída mostrada na captura de tela acima exibe atualmente as tabelas existentes no HBase.
- Aqui, nesta captura de tela, é possível ver que existem um total de 8 tabelas presentes no HBase.
- Podemos filtrar os valores de saída das tabelas passando parâmetros opcionais de expressão regular.
Descrever
Syntax:describe <table name>
hbase(main):010:0>describe 'education'
A saída do comando `describe` é mostrada abaixo:

Este comando descreve a tabela nomeada.
- Isso fornecerá mais informações sobre as famílias de colunas presentes na tabela mencionada.
- No nosso caso, apresenta a descrição da tabela “educação”.
- Isso fornecerá informações sobre o nome da tabela com famílias de colunas, filtros associados, versões e alguns outros detalhes.
desabiltar
Syntax: disable <tablename>
hbase(main):011:0>disable 'education'
A saída de desativação é mostrada abaixo:

- Este comando iniciará a desativação da tabela especificada.
- Se uma tabela precisar ser excluída ou removida, ela precisa ser desativada primeiro.
Aqui, na captura de tela acima, estamos desativando a tabela de educação.
desativar_tudo
Syntax: disable_all<"matching regex"
- Este comando desabilitará todas as tabelas que correspondem ao regex fornecido.
- A implementação é a mesma do comando drop (exceto pela adição de uma expressão regular para correspondência).
- Após a tabela ser desativada, o usuário poderá excluí-la do HBase.
- Antes de excluir ou soltarping Uma tabela deve ser desativada primeiro.
Permitir
Syntax: enable <tablename>
hbase(main):012:0>enable 'education'
A saída do comando `enable` é mostrada abaixo:

- Este comando irá ativar a tabela especificada.
- Qualquer tabela que esteja desativada, para restaurá-la ao seu estado anterior, usamos este comando.
- Se uma tabela estiver desabilitada inicialmente e não for excluída ou descartada, e se quisermos reutilizar a tabela desabilitada, então precisamos habilitá-la usando este comando.
- Aqui, na captura de tela acima, estamos habilitando a tabela “educação”.
mostrar_filtros
Syntax: show_filters
A saída do comando show_filters é mostrada abaixo:

Este comando exibe todos os filtros presentes no HBase, como ColumnPrefixFilter, TimestampsFilter, PageFilter, FamilyFilter, etc.
cair
Syntax:drop <table name>
hbase(main):017:0>drop 'education'
A saída do drop é mostrada abaixo:

Devemos observar os seguintes pontos para o comando drop:
- Para excluir uma tabela presente no HBase, primeiro precisamos desativá-la.
- Para excluir uma tabela presente no HBase, primeiro precisamos desativá-la.
- Portanto, para excluir ou remover uma tabela, primeiro a tabela deve ser desativada usando o comando disable.
- Aqui, na captura de tela acima, estamos soltandoping a tabela “educação”.
- Antes de executar este comando, é necessário desativar a tabela “education”.
drop_all
Syntax: drop_all<"regex">
- Este comando irá excluir todas as tabelas que correspondem à expressão regular fornecida.
- As tabelas precisam ser desativadas primeiro, antes de executar este comando, usando disable_all.
- Tabelas com expressões regulares correspondentes serão removidas do HBase.
está ativado
Syntax: is_enabled 'education'
Este comando verifica se a tabela especificada está habilitada ou não. Geralmente, há alguma confusão entre as ações dos comandos “enable” e “is_enabled”, que esclarecemos aqui:
- Suponha que uma tabela esteja desabilitada; para usar essa tabela, precisamos habilitá-la usando o comando enable.
- O comando is_enabled verifica se a tabela está habilitada ou não.
alterar
Syntax: alter <tablename>, NAME=><column familyname>, VERSIONS=>5
Este comando altera o esquema da família de colunas. Para entender exatamente o que ele faz, explicamos aqui com um exemplo.
Exemplos: Nestes exemplos, vamos executar operações de comando ALTER em tabelas e em suas colunas. Realizaremos operações como:
- Alteração de nomes de família em colunas únicas e múltiplas.
- Excluindo nomes de famílias de colunas de uma tabela.
- Diversas outras operações que utilizam atributos de escopo com uma tabela.
Para alterar ou adicionar a família de colunas 'guru99_1' na tabela 'education', mantendo um máximo de 5 versões de células. Aqui, "education" é o nome da tabela criada anteriormente com o nome de coluna "guru99". Com a ajuda de um comando ALTER, estamos tentando alterar o esquema da família de colunas de guru99 para guru99_1, conforme mostrado abaixo:

hbase> alter 'education', NAME='guru99_1', VERSIONS=>5
Você também pode usar o comando ALTER em várias famílias de colunas. Por exemplo, vamos definir duas novas colunas para nossa tabela existente "education", como mostrado abaixo:

hbase> alter 'edu', 'guru99_1', {NAME => 'guru99_2', IN_MEMORY => true}, {NAME => 'guru99_3', VERSIONS => 5}
- Podemos alterar o esquema de mais de uma coluna por vez usando este comando.
- guru99_2 e guru99_3, conforme mostrado na captura de tela acima, são os dois novos nomes de coluna que definimos para a tabela education.
- Podemos ver como usar esse comando na captura de tela anterior.
Nesta etapa, veremos como excluir uma família de colunas da tabela. Para excluir a família de colunas 'f1' na tabela 'education', use um dos comandos abaixo. O resultado é mostrado na captura de tela a seguir:

hbase> alter 'education', NAME => 'f1', METHOD => 'delete'
hbase> alter 'education', 'delete' =>' guru99_1'
Neste comando, estamos tentando excluir o espaço de colunas chamado guru99_1 que criamos anteriormente na primeira etapa. Como mostrado nas capturas de tela abaixo, são duas etapas: como alterar um atributo de escopo de tabela e como remover o atributo de escopo de tabela.
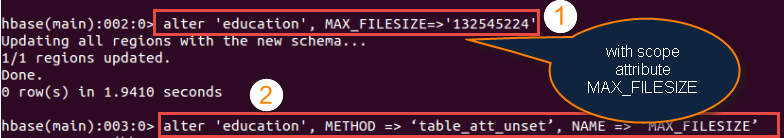
Syntax: alter <'tablename'>, MAX_FILESIZE=>'132545224'
Passo 1) Você pode alterar atributos de escopo de tabela como MAX_FILESIZE, READONLY, MEMSTORE_FLUSHSIZE, DEFERRED_LOG_FLUSH, etc. Estes podem ser colocados no final; por exemplo, para alterar o tamanho máximo de uma região para 128 MB ou qualquer outro valor de memória, usamos este comando.
Uso:
- Podemos usar MAX_FILESIZE com a tabela como um atributo de escopo, como acima.
- O valor representado em MAX_FILESIZE refere-se à memória em bytes.
NOTA: O escopo da tabela MAX_FILESIZE será determinado por alguns atributos presentes no HBase. MAX_FILESIZE também está incluído nos atributos de escopo da tabela.
Passo 2) Você também pode remover um atributo de escopo de tabela usando o método `table_att_unset`. Veja o comando abaixo:
alter 'education', METHOD => 'table_att_unset', NAME => 'MAX_FILESIZE'
- A captura de tela acima mostra o nome da tabela alterado com os atributos de escopo.
- O método `table_att_unset` é usado para remover atributos presentes na tabela.
- No segundo caso, estamos removendo o atributo MAX_FILESIZE.
- Após a execução do comando, ele simplesmente removerá o atributo MAX_FILESIZE da tabela “education”.
alter_status
Syntax: alter_status 'education'
A saída do comando alter_status é mostrada abaixo:

- Por meio desse comando, você pode obter o status do comando alter.
- Indica o número de regiões da tabela que receberam o esquema atualizado. Você informa o nome da tabela.
- Aqui, na captura de tela acima, mostra 1/1 regiões atualizadas. Isso significa que uma região foi atualizada. Depois disso, se a atualização for bem-sucedida, a mensagem "concluído" será exibida.
Comandos de manipulação de dados
Esses comandos operam na tabela para manipulação de dados, como inserir dados em uma tabela, recuperar dados de uma tabela e excluir esquemas, etc. Os comandos que se enquadram nessa categoria são:
- Contar
- colocar
- BAIXE
- Apagar
- apagar tudo
- Truncar
- Escanear
Vamos analisar o uso desses comandos com um exemplo. Veja também leitura e gravação de dados HBase.
Contar
Syntax: count <'tablename'>, CACHE =>1000
- O comando irá recuperar a quantidade de linhas em uma tabela. O valor retornado por este comando é o número de linhas.
- Por padrão, a contagem atual é exibida a cada 1000 linhas.
- O intervalo de contagem pode ser especificado opcionalmente.
- O tamanho padrão do cache é de 10 linhas.
- O comando de contagem funcionará rapidamente quando estiver configurado com o cache correto.
Exemplo:
hbase> count 'guru99', CACHE=>1000
O resultado da contagem é mostrado abaixo:

Este exemplo de contagem busca 1000 linhas por vez da tabela “guru99”. Podemos diminuir o valor do cache se a tabela tiver mais linhas. Mas, por padrão, ele buscará uma linha por vez.
hbase>count 'guru99', INTERVAL => 100000
hbase> count 'guru99', INTERVAL =>10, CACHE=> 1000
Suponha que a tabela “guru99” tenha alguma referência de tabela, como por exemplo, g. Podemos executar o comando count também na referência da tabela, como abaixo:
hbase>g.count INTERVAL=>100000
hbase>g.count INTERVAL=>10, CACHE=>1000
colocar
Syntax: put <'tablename'>,<'rowname'>,<'columnvalue'>,<'value'>
Este comando é usado para os seguintes fins:
- Ele colocará um 'valor' de célula em uma tabela, linha ou coluna definida ou especificada.
- Opcionalmente, poderá incluir um registro de data e hora.
Exemplo: Aqui, estamos inserindo valores na tabela “guru99” na linha r1 e coluna c1.
hbase> put 'guru99', 'r1', 'c1', 'value', 10
Inserimos três valores, 10, 15 e 30, na tabela “guru99”, conforme mostrado na captura de tela abaixo.

Suponha que a tabela “guru99” tenha alguma referência de tabela, como por exemplo, g. Também podemos executar o comando na referência da tabela, como:
hbase> g.put 'guru99', 'r1', 'c1', 'value', 10
O resultado será como mostrado na captura de tela acima, após inserir valores em “guru99”. Para verificar se o valor de entrada foi inserido corretamente na tabela, usamos o comando “scan”. Na captura de tela abaixo, podemos ver que os valores foram inseridos corretamente.

Code Trecho: Para praticar
create 'guru99', {NAME=>'Edu', VERSIONS=>213423443}
put 'guru99', 'r1', 'Edu:c1', 'value', 10
put 'guru99', 'r1', 'Edu:c1', 'value', 15
put 'guru99', 'r1', 'Edu:c1', 'value', 30
A partir do trecho de código, estamos fazendo o seguinte:
- Aqui, estamos criando uma tabela chamada 'guru99' com o nome da coluna sendo "Edu".
- Ao usar o comando “put”, estamos inserindo valores na linha r1, coluna “Edu”, na tabela “guru99”.
BAIXE
Syntax: get <'tablename'>, <'rowname'>, {< Additional parameters>}
Aqui, Inclua TIMERANGE, TIMESTAMP, VERSIONS e FILTERS. Ao usar este comando, você obterá o conteúdo de uma linha ou célula presente na tabela. Além disso, você também pode adicionar parâmetros adicionais, como TIMESTAMP, TIMERANGE, VERSIONS, FILTERS, etc., para obter o conteúdo de uma linha ou célula específica.
O comando `get` abaixo retorna os valores da linha r1 e da coluna c1:

Exemplos:-
hbase> get 'guru99', 'r1', {COLUMN => 'c1'}
Para a tabela “guru99”, os valores da linha r1 e da coluna c1 serão exibidos usando este comando, conforme mostrado na captura de tela acima.
hbase> get 'guru99', 'r1'
Para a tabela “guru99”, os valores da linha r1 serão exibidos usando este comando.
hbase> get 'guru99', 'r1', {TIMERANGE => [ts1, ts2]}
Para a tabela “guru99”, os valores da linha r1 no intervalo de tempo ts1 a ts2 serão exibidos usando este comando.
hbase> get 'guru99', 'r1', {COLUMN => ['c1', 'c2', 'c3']}
Para a tabela “guru99”, os valores da linha r1 e das famílias de colunas c1, c2 e c3 serão exibidos usando este comando.
Apagar
Syntax:delete <'tablename'>,<'row name'>,<'column name'>
- Este comando irá apagar o valor da célula em uma linha ou coluna definida da tabela.
- A função Delete deve e precisa corresponder exatamente às coordenadas da célula excluída.
- Durante a digitalização, a exclusão de uma célula suprime as versões mais antigas dos valores.
Exemplo: O comando delete abaixo remove as células r1 e c1 da tabela guru99:

hbase(main):)020:0> delete 'guru99', 'r1', 'c1''.
- A execução acima excluirá a linha r1 da família de colunas c1 na tabela “guru99”.
- Suponha que a tabela “guru99” tenha alguma referência de tabela, como por exemplo g.
- Também podemos executar o comando na referência da tabela, como hbase> g.delete 'guru99', 'r1', 'c1'.
excluir tudo
Syntax: deleteall <'tablename'>, <'rowname'>
- Este comando apagará todas as células de uma determinada linha.
- Opcionalmente, podemos definir nomes de colunas e um registro de data e hora na sintaxe.
Exemplo: O comando deleteall abaixo remove todas as células da linha r1:

hbase>deleteall 'guru99', 'r1', 'c1'
Isso excluirá todas as linhas e colunas presentes na tabela. Opcionalmente, podemos mencionar os nomes das colunas.
Truncar
Syntax: truncate <tablename>
O comando truncate abaixo esvazia a tabela enquanto keeping seu esquema:

Após o truncamento de uma tabela HBase, o esquema estará presente, mas não os registros. Este comando executa 3 funções; elas estão listadas abaixo:
- Desativa a tabela se ela já existir.
- Remove a tabela se ela já existir.
- Recria a tabela mencionada.
Escanear
Syntax: scan <'tablename'>, {Optional parameters}
Este comando examina a tabela inteira e exibe o seu conteúdo.
- Podemos passar diversas especificações opcionais a este comando scan para obter mais informações sobre as tabelas presentes no sistema.
- As especificações do scanner podem incluir um ou mais dos seguintes atributos.
- São eles: TIMERANGE, FILTER, TIMESTAMP, LIMIT, MAXLENGTH, COLUMNS, CACHE, STARTROW e STOPROW.
scan 'guru99'
O resultado da digitalização é mostrado abaixo:

Na captura de tela acima:
- A imagem mostra a tabela “guru99” com os nomes e valores das colunas.
- Consiste em três valores de linha, r1, r2 e r3, para o valor de coluna único c1.
- Exibe os valores associados às linhas.
Exemplos: - Os diferentes usos do comando scan:
| Command | Uso |
|---|---|
| digitalizar '.META.', {COLUMNS => 'info:regioninfo'} | Exibe todas as informações de metadados relacionadas às colunas presentes nas tabelas do HBase. |
| digitalizar 'guru99', {COLUMNS => ['c1', 'c2'], LIMITE => 10, STARTROW => 'xyz'} | Exibe o conteúdo da tabela guru99 com suas famílias de colunas c1 e c2, limitando os valores a 10. |
| digitalizar 'guru99', {COLUNAS => 'c1', TIMERANGE => [1303668804, 1303668904]} | Exibe o conteúdo de guru99, com a coluna nomeada c1, contendo os valores presentes no intervalo de tempo especificado pelo atributo. |
| digitalizar 'guru99', {RAW => verdadeiro, VERSÕES =>10} | Neste comando, RAW=> true fornece um recurso avançado, como exibir todos os valores de célula presentes na tabela guru99. |
Code Exemplo: Primeiro, crie uma tabela e insira valores nela. A entrada é mostrada na captura de tela abaixo:

create 'guru99', {NAME=>'e', VERSIONS=>2147483647}
put 'guru99', 'r1', 'e:c1', 'value', 10
put 'guru99', 'r1', 'e:c1', 'value', 12
put 'guru99', 'r1', 'e:c1', 'value', 14
delete 'guru99', 'r1', 'e:c1', 11
Se executarmos o comando de varredura:
Query: scan 'guru99', {RAW=>true, VERSIONS=>1000}
Será exibida a saída mostrada abaixo:

A saída mostrada na captura de tela acima fornece as seguintes informações:
- Analisando a tabela guru99 com os atributos RAW=>true, VERSIONS=>1000.
- Exibição de linhas com famílias de colunas e valores.
- Na terceira linha, os valores exibidos mostram o valor excluído presente na coluna.
- O resultado exibido é aleatório; não pode estar na mesma ordem dos valores que inserimos na tabela.
Cluster Comandos de replicação
- Esses comandos funcionam no modo de configuração de cluster do HBase.
- Para adicionar e remover nós de um cluster, bem como para iniciar e parar a replicação, são utilizados estes comandos em geral.
| Command | Funcionalidade |
|---|---|
| add_peer | Adiciona nós a um cluster para replicação. hbase> add_peer '3', zk1,zk2,zk3:2182:/hbase-prod |
| remover_peer | Interrompe o fluxo de replicação definido e exclui todas as informações de metadados sobre o par. hbase> remove_peer '1' |
| start_replication | Reinicia todas as funcionalidades de replicação. hbase> start_replication |
| parar_replicação | Interrompe todas as funcionalidades de replicação. hbase>stop_replication |
