
Tutorial do ELK Stack: Kibana, Logstash e Elasticsearch
 David Carter
⚡ Resumo Inteligente
O ELK Stack combina três ferramentas de código aberto — Elasticsearch, Logstashe Kibana — para coletar, armazenar, pesquisar e visualizar dados de máquinas, fornecendo às equipes de engenharia registro centralizado e análises em tempo real para solução de problemas mais rápida em servidores e aplicativos.
O ELK Stack é uma das soluções de código aberto mais utilizadas para registro centralizado e análise de logs. Este tutorial do ELK Stack explica o que é o Elasticsearch, LogstashEste artigo aborda o Kibana, como as três ferramentas se integram e onde a plataforma é utilizada em trabalhos reais de monitoramento e observabilidade.
O que é a pilha ELK?
O Pilha ELK é uma coleção de três produtos de código aberto — Elasticsearch, Logstashe Kibana. Ele fornece registro centralizado que ajuda a identificar problemas com servidores ou aplicativos, permitindo pesquisar todos os seus registros em um único local. Também ajuda a correlacionar registros de vários servidores dentro de um período específico.
- E Significa Elasticsearch: usado para armazenar logs.
- L é um anagrama para Logstash: usado para navioping, processamento e armazenamento de registros.
- K significa Kibana: um ferramenta de visualização (uma interface web) que é hospedada através do Nginx ou Apache.
Elasticsearch, LogstashO Kibana e o Google Workspace são desenvolvidos, gerenciados e mantidos por uma empresa chamada [nome da empresa]. Elástico.
Em conjunto, o ELK Stack foi projetado para permitir que os usuários coletem dados de qualquer fonte, em qualquer formato, e então pesquisem, analisem e visualizem esses dados em tempo real.
Pilha ELK Archiarquitetura
Agora que você já sabe o que é a pilha, esta seção explica a arquitetura ELK e como os dados fluem entre os componentes.
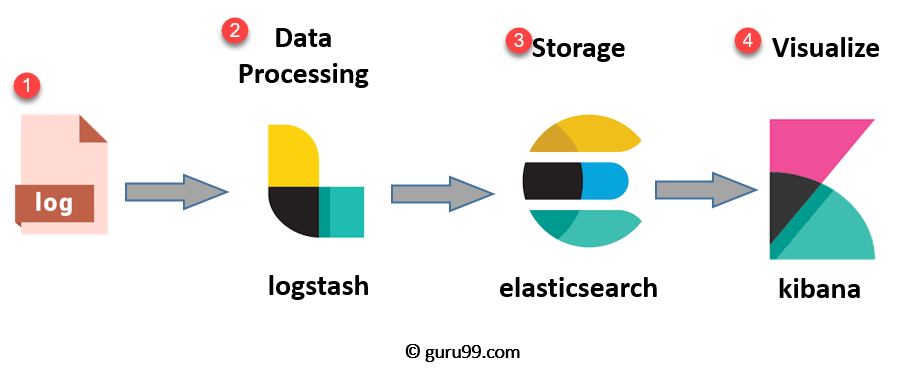
O pipeline ELK segue uma sequência clara na qual cada ferramenta tem uma função específica:
- Registros: Os registros do servidor que precisam ser analisados foram identificados.
- Logstash: Coleta os registros e dados de eventos, depois os analisa e transforma.
- Pesquisa elástica: Os dados transformados por Logstash é armazenado, pesquisado e indexado.
- Kibana: Utiliza o banco de dados Elasticsearch para explorar, visualizar e compartilhar informações.
No entanto, um quarto componente chamado Beats é frequentemente adicionado para coleta de dados. Os Beats são servidores leves que enviam dados para outros servidores, e a adição deles levou a Elastic a renomear o ELK para Elastic Stack.
Ao lidar com grandes volumes de dados, você pode adicionar o Kafka ou o RabbitMQ na entrada do pipeline para armazenamento em buffer e resiliência.
Para maior segurança, um proxy reverso como o Nginx pode ser colocado na frente da pilha.

Com a arquitetura em mente, as seções a seguir examinam mais detalhadamente cada produto de código aberto na pilha.
O que é o Elasticsearch?
Elasticsearch é um Banco de dados NoSQL Baseado no mecanismo de busca Lucene e construído com APIs RESTful, oferece implantação simples, alta confiabilidade e fácil gerenciamento, armazenando todos os seus dados centralmente para que você possa executar consultas avançadas e buscas rápidas de documentos.
O Elasticsearch também permite armazenar, pesquisar e analisar grandes volumes de dados. Ele é frequentemente usado como o mecanismo subjacente que alimenta aplicações com requisitos de pesquisa exigentes.
Graças à adição de análises e diversos recursos avançados, além da busca rápida, o Elasticsearch tem sido amplamente adotado em plataformas de busca para aplicações web e mobile modernas.
Funcionalidades do Elasticsearch
O Elasticsearch oferece um conjunto abrangente de recursos para indexação e pesquisa de dados:
- Um servidor de busca de código aberto escrito em Java.
- Capaz de indexar qualquer tipo de dado heterogêneo.
- Fornece uma interface web REST API com saída em JSON.
- Pesquisa de texto completo.
- Busca em tempo quase real (NRT).
- Um repositório de documentos JSON fragmentado, replicado e pesquisável.
- Armazenamento de documentos distribuído, sem esquema, baseado em REST e JSON.
- Suporte a vários idiomas e geolocalização.
Vantagens do Elasticsearch
- Armazena dados sem esquema e também pode criar um esquema para seus dados.
- Permite manipular registros um a um usando APIs de múltiplos documentos.
- Permite filtrar e consultar seus dados para obter insights.
- Baseado no Apache Lucene e fornece uma API RESTful.
- Oferece escalabilidade horizontal, confiabilidade e capacidade multi-inquilino para indexação em tempo real e busca mais rápida.
- Ajuda você a dimensionar tanto vertical quanto horizontalmente.
A tabela abaixo explica os principais termos que você encontrará ao trabalhar com o Elasticsearch:
| INVERNO | Uso |
|---|---|
| Cluster | Um cluster é uma coleção de nós que, juntos, armazenam seus dados e fornecem recursos combinados de indexação e pesquisa. |
| Node | Um nó é uma única instância do Elasticsearch. Ele é criado quando uma instância do Elasticsearch é iniciada. |
| Índice | Um índice é uma coleção de documentos que compartilham características semelhantes, como dados de clientes ou um catálogo de produtos. É útil para operações de indexação, pesquisa, atualização e exclusão, e você pode definir vários índices em um mesmo cluster. |
| ISO | Um documento é a unidade básica de informação que pode ser indexada. Ele é expresso como um par chave-valor JSON, e cada documento está associado a um tipo e a um ID único. |
| Estilhaço | Cada índice pode ser dividido em vários fragmentos (shards) para distribuir os dados. Um fragmento é a parte atômica de um índice e pode ser espalhado pelo cluster à medida que você adiciona mais nós. |
O que é a Logstash?
Logstash é a ferramenta de pipeline de coleta de dados da pilha. Ela coleta entradas de dados e as envia para o Elasticsearch, reunindo todos os tipos de dados de diferentes fontes e disponibilizando-os para uso posterior.
Logstash É possível unificar dados de fontes distintas e normalizá-los para os destinos que você escolher. Isso permite limpar e democratizar todos os seus dados para uma ampla gama de casos de uso de análise e visualização.
Consiste em três componentes:
- Entrada: Recebe os registros e os converte em um formato legível por máquina.
- Filtros: Um conjunto de condições que executam uma ação específica em um evento.
- Saída: O responsável pela tomada de decisões que encaminha cada evento ou registro processado.
Características do Logstash
Logstash Inclui diversas funcionalidades que tornam o processamento de logs flexível:
- Os eventos passam por cada fase utilizando filas internas.
- Permite diferentes tipos de entrada para seus registros.
- Suporta filtragem e análise de seus registros.
Vantagens de Logstash
- Centraliza o processamento dos seus dados.
- Analisa uma ampla variedade de dados e eventos, tanto estruturados quanto não estruturados.
- Oferece plugins para conexão com diversos tipos de fontes de entrada e plataformas.
O que é Kibana?
O Kibana é a ferramenta de visualização de dados que complementa o ELK Stack. Ele é usado para visualizar documentos do Elasticsearch e ajuda os desenvolvedores a obterem insights rápidos sobre seus dados por meio de diagramas interativos, dados geoespaciais e gráficos que facilitam a compreensão de consultas complexas.
Você pode usar o Kibana para pesquisar, visualizar e interagir com dados armazenados em índices do Elasticsearch. Ele também ajuda você a realizar tarefas avançadas. análise de dados e apresente seus dados em uma variedade de tabelas, gráficos e mapas.
O Kibana oferece suporte a vários métodos para pesquisar seus dados. Os tipos de pesquisa mais comuns estão listados abaixo:
| Tipo de pesquisa | Uso |
|---|---|
| Pesquisas de texto livre | Utilizado para pesquisar uma sequência de caracteres específica. |
| Pesquisas em nível de campo | Utilizado para pesquisar uma sequência de caracteres dentro de um campo específico. |
| Declarações lógicas | Utilizado para combinar pesquisas em uma declaração lógica. |
| pesquisas de proximidade | Utilizado para pesquisar termos dentro de uma proximidade específica de caracteres. |
O Kibana também oferece uma série de recursos poderosos para explorar dados indexados:
- Um painel de controle front-end poderoso que visualiza informações indexadas do cluster Elasticsearch.
- Permite a busca em tempo real de informações indexadas.
- Permite pesquisar, visualizar e interagir com dados armazenados no Elasticsearch.
- Executa consultas em dados e visualiza os resultados em gráficos, tabelas e mapas.
- Um painel configurável para segmentar e analisar dados. Logstash registros no Elasticsearch.
- Fornece dados históricos em forma de gráficos, tabelas e muito mais.
- Oferece painéis de controle em tempo real que são fáceis de configurar.
Vantagens e desvantagens do Kibana
Como qualquer ferramenta, o Kibana possui pontos fortes claros que explicam sua popularidade:
- Visualização fácil de dados.
- Totalmente integrado com o Elasticsearch.
- Funciona como uma ferramenta de visualização dedicada.
- Oferece análise, criação de gráficos, resumo e depuração em tempo real.
- Oferece uma interface intuitiva e fácil de usar.
- Permite o compartilhamento de instantâneos dos registros que você pesquisou.
- Permite salvar e gerenciar vários painéis de controle.
Também possui algumas limitações que devem ser levadas em consideração:
- Ele funciona apenas com o Elasticsearch como fonte de dados.
- Criar e ajustar painéis de controle complexos pode envolver uma curva de aprendizado acentuada.
Por que análise de log?
Em infraestruturas baseadas em nuvem, desempenho e isolamento são muito importantes.
O desempenho das máquinas virtuais na nuvem pode variar de acordo com cargas específicas, ambientes e número de usuários ativos, de modo que a confiabilidade e a falha de nós podem se tornar problemas significativos.
A plataforma de gerenciamento de logs Pode monitorar todos esses problemas. Também pode processar logs do sistema operacional, logs de servidores web Nginx e IIS para análise de tráfego, logs de aplicativos e logs gerados na AWS (Amazon Serviços web).
Em última análise, o gerenciamento de logs ajuda DevOps Engenheiros e administradores de sistemas tomam decisões melhores, baseadas em dados. É por isso que a análise de logs por meio do Elastic Stack ou ferramentas similares se tornou essencial.
ELK x Splunk
Uma pergunta comum é como o ELK Stack se compara com Splunk, uma alternativa comercial popular. A tabela abaixo resume as principais diferenças:
| ELK | Splunk |
|---|---|
| ELK é uma ferramenta de código aberto. | Splunk é uma ferramenta comercial. |
| A ELK não oferece Solaris Portabilidade graças ao Kibana. | Ofertas do Splunk Solaris portabilidade. |
| A velocidade de processamento é estritamente limitada. | Oferece processamento preciso e rápido. |
| ELK é uma pilha de tecnologias criada a partir da combinação do Elasticsearch, Logstashe Kibana. | Splunk é uma ferramenta proprietária que oferece soluções tanto locais quanto em nuvem. |
| No ELK, a busca, a análise e a visualização só são possíveis depois que a pilha estiver configurada. | O Splunk é um pacote completo de gerenciamento de dados, pronto para uso imediato. |
| O ELK oferece integração limitada com outras ferramentas. | O Splunk é útil para configurar integrações com outras ferramentas. |
Estudos de Caso
Muitas empresas renomadas confiam no ELK Stack para executar registro e análise de logs em grande escala. Os exemplos abaixo mostram como ele é usado em produção.
Netflix
Netflix A empresa depende fortemente do ELK Stack para monitorar e analisar os registros de segurança de suas operações de atendimento ao cliente. A plataforma permite Netflix Indexar, armazenar e pesquisar documentos em mais de quinze clusters compostos por aproximadamente 800 nós.
O LinkedIn, rede social profissional, utiliza o ELK Stack para monitorar desempenho e segurança. Sua equipe integrou o ELK ao Kafka para lidar com a carga em tempo real, e a operação abrange mais de 100 clusters em seis data centers.
Tripwire
A Tripwire, fornecedora global de soluções de Gerenciamento de Informações e Eventos de Segurança (SIEM), utiliza o ELK Stack para dar suporte à análise de logs de pacotes de informações.
Suporte:
O Medium, a popular plataforma de publicação de blogs, usa o ELK Stack para depurar problemas em produção e detectar... DynamoDB hotspots. A plataforma ajuda a empresa a dar suporte a 25 milhões de leitores únicos e milhares de novas publicações a cada semana.
Vantagens e desvantagens do ELK Stack
Vantagens
O ELK Stack oferece diversas vantagens que explicam sua ampla adoção:
- Funciona melhor quando os registros de várias aplicações de uma empresa convergem para uma única instância do ELK.
- Isso proporciona uma visão abrangente a partir de uma única instância e elimina a necessidade de acessar centenas de fontes de dados separadas.
- Instalação rápida no local.
- Fácil de implantar e escalável tanto vertical quanto horizontalmente.
- A Elastic oferece diversos clientes de linguagem, incluindo Ruby. PythonPHP, Perl, .NET, Java e JavaRoteiro.
- Existem bibliotecas disponíveis para muitas linguagens de programação e de script.
Desvantagens
Apesar de seus pontos fortes, o ELK Stack apresenta algumas desvantagens a serem consideradas:
- Os diferentes componentes podem se tornar difíceis de gerenciar à medida que você passa para uma configuração mais complexa.
- Existe uma curva de aprendizado real, então espere algumas tentativas e erros enquanto você adquire experiência.
