
Tutorial de Redes Neurais Artificiais (RNA) com TensorFlow
 Equipe editorial
⚡ Resumo Inteligente
As Redes Neurais Artificiais aprendem enviando dados de entrada através de camadas conectadas, avaliando o resultado com uma função de perda e corrigindo os pesos com um otimizador. Este tutorial constrói uma rede neural artificial no TensorFlow e classifica dígitos do MNIST.
O que é Rede Neural Artificial?
An Rede Neural Artificial (ANN) É um sistema computacional inspirado em redes neurais biológicas para criar cérebros artificiais baseados em um conjunto de unidades interconectadas chamadas neurônios artificiais. Ele é projetado para analisar e processar informações da mesma forma que os humanos. Uma Rede Neural Artificial possui capacidade de autoaprendizagem para produzir melhores resultados à medida que mais dados são disponibilizados.
O diagrama abaixo tracé uma passagem completa por essa rede, desde a entrada bruta até o otimizador que corrige os pesos.

Uma Rede Neural Artificial (RNA) é composta por quatro objetos principais:
- Camadas: Todo o aprendizado ocorre nas camadas. Existem 3 camadas: 1) Entrada, 2) Oculta e 3) Saída.
- Característica e rótulo: Dados de entrada para a rede (características) e saída da rede (rótulos)
- Função de perda: Métrica utilizada para estimar o desempenho da fase de aprendizagem.
- Otimizador: Melhore o aprendizado atualizando o conhecimento na rede.
Uma rede neural recebe os dados de entrada e os processa em um conjunto de camadas. Em seguida, a rede avalia seu desempenho com uma função de perda. Essa função fornece à rede uma ideia do caminho que ela precisa percorrer para dominar o conhecimento. A rede aprimora esse conhecimento com a ajuda de um otimizador.
Se você der uma olhada na figura acima, entenderá o mecanismo subjacente.
O programa recebe alguns valores de entrada e os envia para duas camadas totalmente conectadas. Imagine que você tem um problema de matemática. A primeira coisa que você faz é ler o capítulo correspondente para resolvê-lo. Em seguida, você aplica seu novo conhecimento ao problema. Há uma grande chance de você não obter uma boa pontuação. O mesmo acontece com uma rede neural: na primeira vez que ela analisa os dados e faz uma previsão, o resultado não corresponderá perfeitamente aos dados reais.
Para aprimorar seu conhecimento, a rede utiliza um otimizador. Nessa analogia, um otimizador pode ser comparado a reler o capítulo. Você adquire novas ideias ao reler. De forma semelhante, a rede utiliza o otimizador, atualiza seu conhecimento e testa esse novo conhecimento para verificar o quanto ainda precisa aprender. O programa repete esse processo até cometer o menor erro possível.
Na analogia com problemas de matemática, isso significa que você lê o capítulo do livro didático várias vezes até compreender completamente o conteúdo do curso. Mesmo após múltiplas leituras, se você continuar cometendo erros, significa que atingiu o limite do conhecimento adquirido com o material atual. Você precisa usar um livro didático diferente ou testar um método diferente para melhorar seu desempenho. Para uma rede neural, o processo é o mesmo. Se o erro parar de diminuir e a curva de perda se estabilizar, a arquitetura atual não consegue aprender mais nada. A rede precisa ser melhor otimizada para expandir seu aprendizado.
Esses quatro objetos correspondem diretamente aos componentes que você configura ao projetar uma rede.
Rede neural Archiarquitetura
A arquitetura da Rede Neural Artificial consiste nos seguintes componentes:
- Camadas
- Função de ativação
- Função de perda
- Optimizer
Camadas
Uma camada é onde todo o aprendizado acontece. Dentro de uma camada, existe um número arbitrário de neurônios, cada um com seus próprios pesos. Uma rede neural típica é frequentemente processada por camadas densamente conectadas (também chamadas de camadas totalmente conectadas). Isso significa que todas as entradas estão conectadas à saída.
Uma rede neural típica recebe um vetor de entrada e um escalar que contém os rótulos. A configuração mais simples é uma classificação binária com apenas duas classes: 0 e 1.
A rede recebe uma entrada, envia-a para todos os nós conectados e calcula o sinal com uma função de ativação. O diagrama numerado abaixo amplia um único nó para que você possa ver a soma ponderada e a etapa de ativação separadamente.

A figura acima ilustra essa ideia. A primeira camada contém os valores de entrada. A segunda camada, chamada camada oculta, recebe a entrada ponderada da camada anterior.
- O primeiro nó representa os valores de entrada.
- O neurônio é decomposto em uma parte de entrada e uma função de ativação. A parte esquerda recebe toda a entrada da camada anterior. A parte direita é a soma da entrada passada para a função de ativação.
- O valor de saída é calculado a partir das camadas ocultas e usado para fazer uma previsão. Para classificação, é igual ao número de classes. Para regressão, apenas um valor é previsto.
Função de ativação
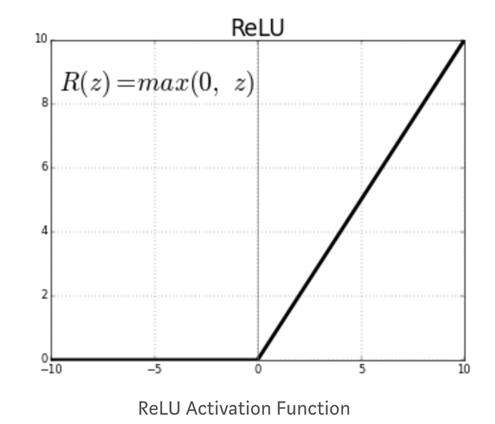
A função de ativação de um nó define a saída para um conjunto de entradas. É necessária uma função de ativação para permitir que a rede aprenda padrões não lineares. Uma função de ativação comum é a ReLU, Unidade Linear Retificada. Essa função retorna zero para todos os valores negativos.
As outras funções de ativação são:
- Linear por partes
- Sigmóide
- Tanh
- ReLU com vazamento
O gráfico abaixo mostra por que a ReLU é descrita dessa forma: a curva é plana em zero para toda entrada negativa e sobe linearmente a partir daí.
A decisão crítica a tomar ao construir uma rede neural é:
- Quantas camadas na rede neural
- Quantas unidades ocultas para cada camada
Redes neurais com muitas camadas e unidades ocultas podem aprender uma representação complexa dos dados, mas tornam o processamento computacional da rede muito custoso.
Função de perda
Depois de definir as camadas ocultas e a função de ativação, você precisa especificar a função de perda e o otimizador.
Para classificação binária, é prática comum usar uma função de perda de entropia cruzada binária. regressão linear, você usa o erro quadrático médio.
A função de perda é uma métrica importante para estimar o desempenho do otimizador. Durante o treinamento, essa métrica será minimizada. Você precisa selecionar essa quantidade com cuidado, dependendo do tipo de problema com o qual está lidando.
Optimizer
A função de perda é uma medida do desempenho do modelo. O otimizador ajudará a melhorar os pesos da rede para diminuir a perda. Existem diferentes otimizadores disponíveis, mas o mais comum é o Gradiente Descendente Estocástico.
Os otimizadores convencionais são:
- Momentum otimização
- Gradiente Acelerado de Nesterov
- AdaGrad
- Otimização de Adam
ArchiA arquitetura por si só não garante um modelo utilizável.
Limitações da rede neural
A seguir, apresentamos as limitações de uma rede neural:
Overfitting
Um problema comum em redes neurais complexas é a dificuldade de generalizar para dados nunca vistos antes. Uma rede neural com muitos pesos pode identificar detalhes específicos no conjunto de treinamento muito bem, mas isso frequentemente leva ao sobreajuste (overfitting). Se os dados estiverem desbalanceados dentro dos grupos (ou seja, se não houver dados suficientes disponíveis em alguns grupos), a rede aprenderá muito bem durante o treinamento, mas não terá a capacidade de generalizar esses padrões para dados nunca vistos antes.
Existe uma compensação em aprendizado de máquina entre otimização e generalização.
- Otimizar um modelo requer encontrar os melhores parâmetros que minimizem a perda no conjunto de treinamento.
- A generalização, entretanto, diz como o modelo se comporta para dados não vistos.
Para evitar que o modelo capture detalhes específicos ou padrões indesejados dos dados de treinamento, você pode usar diferentes técnicas. O melhor método é ter um conjunto de dados balanceado com quantidade suficiente de dados. A arte de reduzir o sobreajuste é chamada de regularização. As três técnicas abaixo são os pontos de partida convencionais.
| Técnica | O que isso restringe | Configuração típica neste tutorial |
|---|---|---|
| Tamanho da rede | O número de camadas e unidades ocultas | Duas camadas ocultas, 300 e 100 unidades |
| Regularização de peso L1/L2 | A magnitude dos coeficientes de ponderação | força_regularização_l1 e força_regularização_l2 de 0.01 |
| Cair fora | A proporção de unidades desligadas por etapa de treinamento | abandono de 0.3 |
Tamanho da rede
Sabe-se que uma rede neural com muitas camadas e unidades ocultas é altamente sofisticada. Uma maneira simples de reduzir a complexidade do modelo é diminuir seu tamanho. Não existe uma única prática ideal para definir o número de camadas. É preciso começar com um número pequeno de camadas e aumentar o tamanho gradualmente até que o modelo comece a apresentar sobreajuste (overfitting).
Regularização de Peso
Uma técnica padrão para evitar o sobreajuste é adicionar restrições aos pesos da rede. A restrição força os pesos da rede a assumirem apenas valores pequenos. Essa restrição é adicionada à função de perda do erro. Existem dois tipos de regularização:
- L1 (Laço): O custo é proporcional ao valor absoluto dos coeficientes de ponderação.
- L2 (Crista): O custo é proporcional ao quadrado do valor dos coeficientes de ponderação.
Cair fora
O dropout é uma técnica peculiar, porém útil. Uma rede neural com dropout significa que algumas unidades serão desativadas aleatoriamente durante uma etapa de treinamento, de modo que seu sinal de saída se torne zero. Imagine que você tenha um array de pesos [0.1, 1.7, 0.7, -0.9]. Se a rede neural tiver dropout, ela se tornará [0.1, 0, 0, -0.9], com zeros distribuídos aleatoriamente. O parâmetro que controla o dropout é a taxa de dropout. Essa taxa define quantas unidades são desativadas. Uma taxa entre 0.2 e 0.5 é comum.
Um pequeno exemplo interativo facilita o acompanhamento do ciclo de treinamento.
Exemplo de rede neural no TensorFlow
Aqui está um exemplo de Rede Neural Artificial em ação, mostrando como uma rede neural funciona em um problema típico de classificação. Existem duas entradas, x1 e x2, cada uma com um valor aleatório. A saída é uma classe binária. O objetivo é classificar o rótulo com base nas duas características. Para realizar essa tarefa, a arquitetura da rede neural é definida da seguinte forma:
- Duas camadas ocultas
- A primeira camada tem quatro neurônios totalmente conectados
- A segunda camada tem dois neurônios totalmente conectados
- A função de ativação é uma ReLU.
- Adicione uma regularização L2 com uma taxa de aprendizagem de 0.003
A rede otimizará os pesos durante 180 épocas com um tamanho de lote de 10. Na animação de exemplo de RNA abaixo, você pode ver como os pesos evoluem ao longo do tempo e como a rede melhora o mapa de classificação.ping.

Em primeiro lugar, a rede atribui valores aleatórios a todos os pesos.
- Com os pesos aleatórios, ou seja, sem otimização, a perda de saída é de 0.453. A imagem abaixo representa a rede com cores diferentes.
- Em geral, a cor laranja representa valores negativos enquanto as cores azuis mostram os valores positivos.
- Os pontos de dados têm a mesma representação: os azuis são os rótulos positivos e os laranjas, os rótulos negativos.

Na segunda camada oculta, as linhas são coloridas de acordo com o sinal dos pesos. As linhas laranjas representam pesos negativos e as azuis, pesos positivos.
Como você pode ver, no mapa de saídapingA rede está cometendo muitos erros. Agora, observe como a rede se comporta após a otimização.
A imagem do exemplo de RNA abaixo mostra os resultados da rede otimizada. Primeiramente, nota-se que a rede aprendeu com sucesso a classificar os pontos de dados. Comparando com a imagem anterior, o peso inicial era -0.43, enquanto após a otimização resultou em um peso de -0.95.

A ideia pode ser generalizada para redes com mais camadas ocultas e neurônios. Você pode experimentar as configurações por conta própria no Parque TensorFlow.
O passo a passo abaixo demonstra como implementar a mesma ideia em código, utilizando um conjunto de dados reais.
Como treinar uma rede neural com TensorFlow
Aqui está o processo passo a passo de como treinar uma rede neural com TensorFlow Rede neural artificial (RNA) usando o estimador DNNClassifier da API.
Usaremos o conjunto de dados MNIST para treinar sua primeira rede neural. Treinando uma rede neural com TensorFlow Não é muito complicado. A etapa de pré-processamento é exatamente igual à dos tutoriais anteriores. Você deverá proceder da seguinte forma:
- Importar os dados
- Transforme os dados
- Construa o tensor
- Construa o modelo
- Treine e avalie o modelo
- Melhorar o modelo
Nota de versão: O código neste passo a passo é direcionado à API Estimator do TensorFlow 1.x. A versão final do pacote tf-estimator foi lançada com o TensorFlow 2.15, e o tf.estimator foi removido no TensorFlow 2.16. Para executar estas etapas em uma versão atual, fixe o TensorFlow 2.15 ou reconstrua a mesma rede de duas camadas com tf.keras.layers.Dense e model.fit().
Etapa 1) Importe os dados
Primeiramente, você precisa importar a biblioteca necessária. Você pode importar o conjunto de dados MNIST usando scikit-learn como mostrado no exemplo de Rede Neural do TensorFlow abaixo.
O conjunto de dados MNIST é o mais comumente usado para testar novas técnicas ou algoritmos. Trata-se de uma coleção de imagens de 28×28 pixels, cada uma mostrando um dígito manuscrito de 0 a 9. Um comitê de redes convolucionais profundas treinadas com distorções elásticas reduziu o erro de teste para 0.27%.
import numpy as np
import tensorflow as tf
np.random.seed(1337)
O passo a passo original baixava os arquivos MNIST manualmente e apontava o fetch_mldata para essa pasta.
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata(' /Users/Thomas/Dropbox/Learning/Upwork/tuto_TF/data/mldata/MNIST original')
print(mnist.data.shape)
print(mnist.target.shape)
Nota sobre a API: O site mldata.org não está mais online e a função fetch_mldata foi removida no scikit-learn 0.22. Em uma instalação atual, substitua a chamada acima por fetch_openml('mnist_784', version=1), que baixa os mesmos 70,000 dígitos e expõe os mesmos dados e atributos de destino.
Depois disso, você divide os dados e obtém o formato de ambos os conjuntos de dados.
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(mnist.data, mnist.target, test_size=0.2, random_state=42)
y_train  = y_train.astype(int)
y_test  = y_test.astype(int)
batch_size =len(X_train)

print(X_train.shape, y_train.shape,y_test.shape )
Etapa 2) Transforme os dados
No tutorial anterior, você aprendeu que precisa transformar os dados para limitar o efeito de outliers. Neste tutorial de Redes Neurais, você transformará os dados usando o escalar min-max. A fórmula é:
(X-min_x)/(max_x - min_x)
O scikit-learn já possui uma função para isso: MinMaxScaler()
## resclae
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
# Train
X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
# test
X_test_scaled = scaler.fit_transform(X_test.astype(np.float64))
Etapa 3) Construa o tensor
Agora você já está familiarizado com a forma de criar. tensores No TensorFlow, você pode converter o conjunto de treinamento em uma coluna numérica.
feature_columns = [tf.feature_column.numeric_column('x', shape=X_train_scaled.shape[1:])]
Etapa 4) Construa o modelo
A arquitetura da rede neural contém duas camadas ocultas, com 300 unidades na primeira camada e 100 unidades na segunda. Esses valores são obtidos por experiência, e não por uma fórmula. Você pode ajustá-los e observar como isso afeta a precisão da rede.
Para construir o modelo, você usa o estimador DNNClassifier. Você precisa definir o número de classes para 10, pois existem dez classes no conjunto de treinamento. Você já está familiarizado com a sintaxe do objeto estimador. Os argumentos feature_columns, n_classes e model_dir são exatamente os mesmos do tutorial anterior. O argumento hidden_units é novo: ele controla tanto o número de camadas quanto a quantidade de nós que cada camada conecta à rede neural. No código abaixo, existem duas camadas ocultas, a primeira conectando 300 nós e a segunda 100 nós.
Para construir o estimador, use tf.estimator.DNNClassifier com os seguintes parâmetros:
- colunas_de_recursos: Defina as colunas a serem usadas na rede.
- unidades_ocultas: Defina o número de neurônios ocultos.
- n_classes: Defina o número de classes a serem previstas.
- diretório_do_modelo: Defina o caminho de TensorBoard
estimator = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    n_classes=10,
    model_dir = '/train/DNN')
Etapa 5) Treine e avalie o modelo
Você pode usar a função de entrada do NumPy para treinar o modelo e avaliá-lo.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_train_scaled},
    y=y_train,
    batch_size=50,
    shuffle=False,
    num_epochs=None)
estimator.train(input_fn = train_input,steps=1000)
eval_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_test_scaled},
    y=y_test,
    shuffle=False,
    batch_size=X_test_scaled.shape[0],
    num_epochs=1)
estimator.evaluate(eval_input,steps=None)
Saída:
{'accuracy': 0.9637143,
 'average_loss': 0.12014342,
 'loss': 1682.0079,
 'global_step': 1000}
A arquitetura atual resulta em uma precisão de aproximadamente 96% no conjunto de avaliação.
Etapa 6) Melhorar o modelo
Você pode tentar melhorar o modelo adicionando parâmetros de regularização.
Aqui, o estimador usa um otimizador Proximal AdaGrad com uma taxa de dropout de 0.3 e as intensidades L1 e L2 definidas como 0.01. Em uma rede neural do TensorFlow, você acessa o otimizador por meio do objeto `train` seguido pelo nome do otimizador. O TensorFlow fornece uma API integrada para o otimizador Proximal AdaGrad.
Para adicionar regularização à rede neural profunda, você pode usar o tf.train.ProximalAdagradOptimizer com os seguintes parâmetros:
- Taxa de aprendizagem: taxa de Aprendizagem
- Regularização L1: força_de_regularização_l1
- Regularização L2: força_de_regularização_l2
estimator_imp = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    dropout=0.3,
    n_classes = 10,
    optimizer=tf.train.ProximalAdagradOptimizer(
      learning_rate=0.01,
      l1_regularization_strength=0.01,
      l2_regularization_strength=0.01
    ),
    model_dir = '/train/DNN1')
estimator_imp.train(input_fn = train_input,steps=1000)
estimator_imp.evaluate(eval_input,steps=None)
Saída:
{'accuracy': 0.95057142,
 'average_loss': 0.17318928,
 'loss': 2424.6499,
 'global_step': 2000}
Os valores escolhidos para reduzir o sobreajuste não melhoraram a precisão do modelo. Seu primeiro modelo teve uma precisão de 96%, enquanto o modelo com o regularizador L2 tem uma precisão de 95%. Você pode experimentar valores diferentes e ver como eles impactam a precisão.
