
Osadzanie słów i Word2Vec z przykładem
 Evelyn Clarke
⚡ Inteligentne podsumowanie
Osadzanie słów i Word2Vec konwertują tekst na gęste wektory numeryczne, dzięki czemu modele uczenia maszynowego rozpoznają słowa o podobnym znaczeniu. W tym materiale wyjaśniono tę technikę, jej architektury CBOW i Skip-Gram, funkcje aktywacji oraz pełną implementację Gensim w rzeczywistych zastosowaniach.
Co to jest osadzanie słów?
Osadzanie słów to typ reprezentacji słów, który pozwala algorytmom uczenia maszynowego rozumieć słowa o podobnym znaczeniu. Jest to technika modelowania języka i uczenia cech, która polega na mapowaniu słów na wektory liczb rzeczywistych za pomocą sieci neuronowych, modeli probabilistycznych lub redukcji wymiarów macierzy współwystępowania słów. Niektóre modele osadzania słów to Word2vec (Google), GloVe (Stanford) i fastText (Facebook).
Osadzanie słów nazywane jest również rozproszonym modelem semantycznym, rozproszonym modelem reprezentowanym, semantyczną przestrzenią wektorową lub modelem przestrzeni wektorowej. Czytając te nazwy, natkniesz się na słowo semantyczny, co oznacza kategoryzowanie podobnych słów. Na przykład owoce takie jak jabłko, mango i banan powinny być umieszczone blisko siebie, podczas gdy książki będą umieszczone daleko od tych słów. W szerszym sensie, osadzanie słów stworzy wektor owoców, który będzie umieszczony daleko od wektorowej reprezentacji książek.
Gdzie stosuje się osadzanie słów?
Osadzanie słów pomaga w generowaniu cech, grupowaniu dokumentów, klasyfikacji tekstu i przetwarzaniu języka naturalnego. Wymieńmy te zastosowania i omówmy każde z nich.
- Oblicz podobne słowa: Osadzanie słów służy do sugerowania słów podobnych do słowa poddawanego modelowi predykcyjnemu. Sugeruje ono również słowa niepodobne, a także słowa najczęściej występujące.
- Utwórz grupę powiązanych słów: Służy do grup semantycznychping, która grupuje rzeczy o podobnych cechach i odsuwa rzeczy od siebie różne.
- Funkcja klasyfikacji tekstu: Tekst jest mapowany na tablice wektorów, które są przekazywane do modelu w celu trenowania i predykcji. Modeli klasyfikatorów tekstowych nie można trenować na ciągach znaków, dlatego ta metoda konwertuje tekst do formy, którą można trenować maszynowo. Funkcje budowania semantyki dodatkowo ułatwiają klasyfikację opartą na tekście.
- Grupowanie dokumentów: To kolejna aplikacja, w której Word Embedding i Word2vec są szeroko stosowane.
- Przetwarzanie języka naturalnego: Istnieje wiele aplikacji, w których osadzanie słów jest przydatne i ma przewagę nad innymi funkcjami, np.tracfazy decyzyjne, takie jak oznaczanie części mowy, analiza sentymentów i analiza składniowa.
Teraz, gdy wiesz już, gdzie stosuje się osadzanie słów, przyjrzyjmy się najpopularniejszemu modelowi używanemu do tworzenia takich osadzeń.
Co to jest Word2vec?
Word2vec to technika lub model, który generuje osadzenia słów w celu lepszej reprezentacji słów. Jest to metoda przetwarzania języka naturalnego, która rejestruje dużą liczbę precyzyjnych zależności składniowych i semantycznych między słowami. Jest to płytka, dwuwarstwowa sieć neuronowa, która po wytrenowaniu potrafi wykrywać synonimy i sugerować dodatkowe słowa dla części zdań.
Zanim przejdziemy dalej, zapoznaj się z różnicą między płytką i głęboką siecią neuronową, jak pokazano na poniższym przykładowym diagramie osadzania słów:
Płytka sieć neuronowa składa się tylko z jednej warstwy ukrytej między wejściem a wyjściem, podczas gdy głęboka sieć neuronowa zawiera wiele warstw ukrytych między wejściem a wyjściem. Wejście jest podporządkowane węzłom, podczas gdy warstwa ukryta, podobnie jak warstwa wyjściowa, zawiera neurony.
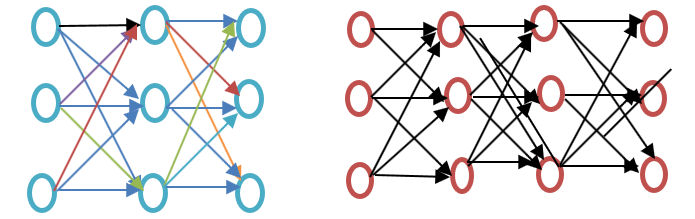
Word2vec to dwuwarstwowa sieć składająca się z warstwy wejściowej, jednej warstwy ukrytej i jednej wyjściowej.
Program Word2vec został opracowany przez grupę badaczy pod kierownictwem Tomasa Mikolova Google. Word2vec jest lepszy i wydajniejszy niż model analizy semantyki ukrytej.
Dlaczego Word2vec?
Word2vec reprezentuje słowa w reprezentacji przestrzeni wektorowej. Słowa są reprezentowane w postaci wektorów, a ich rozmieszczenie jest takie, że słowa o podobnym znaczeniu pojawiają się razem, a słowa o różnym znaczeniu – daleko od siebie. Nazywa się to również relacją semantyczną. Sieci neuronowe nie rozumieją tekstu, lecz jedynie liczby. Osadzanie słów umożliwia konwersję tekstu na wektor liczbowy.
Word2vec rekonstruuje kontekst językowy słów. Zanim przejdziemy dalej, wyjaśnijmy, czym jest kontekst językowy. Zazwyczaj, gdy mówimy lub piszemy, aby się komunikować, inne osoby próbują ustalić cel zdania. Na przykład: „Jaka jest temperatura w Indiach?”. W tym przypadku kontekst jest taki, że użytkownik chce poznać „temperaturę w Indiach”. Krótko mówiąc, głównym celem zdania jest kontekst. Słowa lub zdania otaczające język mówiony lub pisany pomagają w określeniu znaczenia kontekstu. Word2vec uczy się wektorowej reprezentacji słów poprzez te konteksty.
Co robi Word2vec?
Przed osadzeniem programu Word
Ważne jest, aby wiedzieć, jakie podejście było stosowane przed osadzaniem słów i jakie są jego wady, a następnie zobaczymy, jak te wady są przezwyciężane przez osadzanie słów z wykorzystaniem metody Word2vec. Na koniec przejdziemy do tego, jak działa Word2vec, ponieważ ważne jest, aby zrozumieć jego działanie.
Podejście do ukrytej analizy semantycznej
To podejście było stosowane przed wprowadzeniem osadzania słów. Wykorzystywało koncepcję „worka słów”, gdzie słowa są reprezentowane w postaci zakodowanych wektorów. Jest to rzadka reprezentacja wektorowa, której wymiar jest równy rozmiarowi słownika. Jeśli słowo występuje w słowniku, jest brane pod uwagę; w przeciwnym razie nie. Aby dowiedzieć się więcej, zapoznaj się z poniższym programem.
Przykład Word2veca

from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer()
data_corpus = ["guru99 is the best site for online tutorials. I love to visit guru99."]
vocabulary = vectorizer.fit(data_corpus)
X = vectorizer.transform(data_corpus)

print(X.toarray())
print(vectorizer.get_feature_names_out())
Wyjście:
[[1 2 1 1 1 1 1 1 1 1]]
[u'best', u'guru99', u'is', u'love', u'online', u'sitefor', u'the', u'to', u'tutorials', u'visit']
Code Wyjaśnienie
- CountVectorizer to moduł służący do przechowywania słownictwa na podstawie pasujących do niego słów. Jest on importowany z biblioteki sklearn.
- Utwórz obiekt za pomocą klasy CountVectorizer.
- Zapisz na liście dane, które mają zostać dopasowane do CountVectorizer.
- Dane mieszczą się w obiekcie utworzonym z klasy CountVectorizer.
- Zastosuj podejście „worka słów” do zliczania słów w danych za pomocą słownika. Jeśli słowo lub token nie jest dostępny w słowniku, wówczas pozycja indeksu jest ustawiana na zero.
- Zmienna w wierszu 5, czyli x, jest konwertowana na tablicę (metoda dostępna dla x). W ten sposób uzyskuje się liczbę tokenów w zdaniu lub na liście podanej w wierszu 3.
- Pokazuje cechy stanowiące część słownika po dopasowaniu go przy użyciu danych z wiersza 4.
W podejściu semantyki ukrytej wiersz reprezentuje unikalne słowa, natomiast kolumna reprezentuje liczbę wystąpień danego słowa w dokumencie. Jest to reprezentacja słów w formie macierzy dokumentu. Do zliczania częstotliwości słów w dokumencie używa się wzoru TF-IDF (Term Frequency-Inverse Document Frequency), który jest ilorazem częstotliwości występowania danego terminu w dokumencie i częstotliwości występowania danego terminu w całym korpusie.
Wady metody Bag of Words
- Ignoruje kolejność wyrazów, na przykład: to jest złe = złe to jest.
- Ignoruje kontekst słów. Załóżmy, że napiszemy zdanie „Kochał książki. Wykształcenie najlepiej znaleźć w książkach”. Utworzyłoby ono dwa wektory: jeden dla „Kochał książki” i drugi dla „Wykształcenie najlepiej znaleźć w książkach”. Potraktowałby oba jako ortogonalne, co czyni je niezależnymi, ale w rzeczywistości są ze sobą powiązane.
Aby pokonać te ograniczenia, opracowano osadzanie słów. Jednym z podejść zastosowanych w tym celu jest Word2vec.
Jak działa Word2vec?
Word2vec uczy się słowa, przewidując jego kontekst. Weźmy na przykład słowo „On” kocha Piłka nożna."
Chcemy obliczyć Word2vec dla słowa: kocha.
Przypuszczać:
loves = Vin. P(Vout / Vin) is calculated
where,
Vin is the input word.
P is the probability of likelihood.
Vout is the output word.
Słowo kocha Przesuwa się po każdym słowie w korpusie. Kodowane są relacje składniowe i semantyczne między słowami. Pomaga to w znajdowaniu słów podobnych i analogicznych.
Wszystkie losowe cechy tego słowa kocha są obliczane. Cechy te są zmieniane lub aktualizowane w odniesieniu do słów sąsiednich lub kontekstowych za pomocą Powrót do propagacji Metoda.
Innym sposobem nauki jest założenie, że jeśli konteksty dwóch słów są podobne lub dwa słowa mają podobne cechy, to takie słowa są powiązane.
Word2vec Architektura
Word2vec wykorzystuje dwie architektury:
- Ciągły worek słów (CBOW)
- Pomiń gram
Zanim przejdziemy dalej, omówmy, dlaczego te architektury lub modele są ważne z punktu widzenia reprezentacji słów. Uczenie się reprezentacji słów odbywa się zasadniczo bez nadzoru, ale do trenowania modelu potrzebne są cele/etykiety. Skip-gram i CBOW konwertują reprezentację bez nadzoru do formy nadzorowanej w celu trenowania modelu.
W CBOW bieżące słowo jest przewidywane za pomocą okna otaczających okien kontekstowych. Na przykład, jeśli wi-1, Wi-2, Wi + 1, Wi + 2 podano słowa lub kontekst, model ten zapewni wi.
Skip-Gram działa odwrotnie niż CBOW, co oznacza, że przewiduje daną sekwencję lub kontekst na podstawie słowa. Możesz odwrócić przykład, aby to zrozumieć. Jeślii jest podany, to przewidzi kontekst lubi-1, Wi-2, Wi + 1, Wi + 2.
Word2vec oferuje możliwość wyboru pomiędzy CBOW (Continuous Bag of Words) a skip-gramem. Parametry te są podawane podczas trenowania modelu. Można wybrać próbkowanie ujemne lub hierarchiczną warstwę softmax.
Ciągły worek słów
Narysujmy prosty przykładowy diagram Word2vec, aby zrozumieć architekturę ciągłego worka słów.

Obliczmy równania matematycznie. Załóżmy, że V to rozmiar słownika, a N to rozmiar warstwy ukrytej. Dane wejściowe definiuje się jako {xi-1Xi-2Xi + 1Xi + 2 }. Macierz wag otrzymujemy mnożąc V * N. Inną macierz uzyskujemy mnożąc wektor wejściowy przez macierz wag. Można to również zrozumieć za pomocą następującego równania.
h = xitW
gdzie xit a W to odpowiednio wektor wejściowy i macierz wag.
Aby obliczyć zgodność kontekstu z następnym słowem, zapoznaj się z poniższym równaniem.
u = przewidywana reprezentacja * h
gdzie przewidywana reprezentacja jest uzyskiwana z modelu w powyższym równaniu.
Model pomijania grama
Metoda Skip-Gram służy do przewidywania zdania na podstawie słowa wejściowego. Aby lepiej to zrozumieć, narysujmy diagram pokazany w poniższym przykładzie Word2vec.

Można to traktować jako odwrotność modelu Continuous Bag of Words, gdzie dane wejściowe stanowią słowo, a model dostarcza kontekst lub sekwencję. Możemy również stwierdzić, że cel jest podawany na dane wejściowe, a warstwa wyjściowa jest replikowana wielokrotnie, aby pomieścić wybraną liczbę słów kontekstowych. Wektor błędów ze wszystkich warstw wyjściowych jest sumowany w celu dostosowania wag za pomocą metody propagacji wstecznej.
Jaki model wybrać?
CBOW jest kilkakrotnie szybszy niż Skip-Gram i zapewnia lepszą częstotliwość dla często występujących słów, podczas gdy Skip-Gram wymaga niewielkiej ilości danych treningowych i reprezentuje nawet rzadkie słowa lub frazy. Poniższa tabela porównuje obie architektury w skrócie.
| WYGLĄD | CŁUK | Pomiń gram |
|---|---|---|
| Przepowiednia | Przewiduje słowo docelowe na podstawie kontekstu | Przewiduje kontekst na podstawie słowa docelowego |
| Szybkość treningu | Szybciej | Wolniej |
| Często używane słowa | Wyższa dokładność | Niższa dokładność |
| Rzadkie słowa | Słabsza reprezentacja | Silniejsza reprezentacja |
| Dane treningowe | Potrzeba więcej danych | Działa z mniejszą ilością danych |
Związek między Word2vec i NLTK
NLTK jest naturalne Language Toolkit. Służy do wstępnego przetwarzania tekstu. Można wykonywać różne operacje, takie jak tagowanie części mowy, lematyzowanie, stemming, usuwanie słów pomijanych oraz usuwanie słów rzadkich lub najmniej używanych. Pomaga w czyszczeniu tekstu, a także w przygotowywaniu cech z efektywnych słów. Z drugiej strony, Word2vec służy do dopasowywania semantycznego (blisko powiązane elementy) i składniowego (sekwencja). Za pomocą Word2vec można znaleźć słowa podobne, słowa niepodobne, przeprowadzić redukcję wymiarów i wiele innych. Inną ważną funkcją Word2vec jest konwersja reprezentacji tekstu o wyższej liczbie wymiarów na wektory o niższej liczbie wymiarów.
Gdzie używać NLTK i Word2vec?
Jeśli zachodzi potrzeba wykonania pewnych zadań ogólnego przeznaczenia, takich jak tokenizacja, tagowanie POS i parsowanie, należy skorzystać z NLTK, natomiast w celu przewidywania słów na podstawie kontekstu, modelowania tematów lub podobieństwa dokumentów należy użyć Word2vec.
Relacja NLTK i Word2vec za pomocą kodu
NLTK i Word2vec można używać razem do wyszukiwania podobnych reprezentacji słów lub zgodności składniowej. Zestaw narzędzi NLTK umożliwia załadowanie wielu pakietów dołączonych do NLTK, a model można utworzyć za pomocą Word2vec. Następnie można go przetestować na słowach w czasie rzeczywistym. Przyjrzyjmy się połączeniu obu w poniższym kodzie. Przed przejściem do dalszych etapów, zapoznaj się z korpusami udostępnianymi przez NLTK. Możesz je pobrać za pomocą polecenia:
nltk(nltk.download('all'))

Zobacz zrzut ekranu z kodem.
import nltk
import gensim
from nltk.corpus import abc

model = gensim.models.Word2Vec(abc.sents())
X = list(model.wv.vocab)
data = model.most_similar('science')
print(data)

Wyjście:
[('law', 0.9415997266769409), ('practice', 0.9276568293571472), ('discussion', 0.9259148836135864), ('agriculture', 0.9257254004478455), ('media', 0.9232194423675537), ('policy', 0.922248125076294), ('general', 0.9166069030761719), ('undertaking', 0.916458249092102), ('tight', 0.9129181504249573), ('board', 0.9107444286346436)]
Wyjaśnienie Code
- Importowana jest biblioteka nltk, z której można pobrać korpus abc, z którego skorzystamy w następnym kroku.
- Gensim został zaimportowany. Jeśli Gensim Word2vec nie jest zainstalowany, zainstaluj go za pomocą polecenia „pip3 install gensim”. Zobacz zrzut ekranu poniżej.

- Zaimportuj korpus abc pobrany za pomocą nltk.download('abc').
- Przekaż pliki do modelu Word2vec, który jest importowany za pomocą Gensim, jako zdania.
- Słownictwo jest przechowywane w formie zmiennej.
- Model jest testowany na słowie przykładowym naukaponieważ pliki te dotyczą nauki.
- W tym przypadku model przewiduje podobne słowo „nauka”.
Aktywatory i Word2Vec
Funkcja aktywacji neuronu definiuje sygnał wyjściowy tego neuronu po otrzymaniu zestawu bodźców. Jest ona biologicznie inspirowana aktywnością naszego mózgu, gdzie różne neurony są aktywowane przez różne bodźce. Zrozummy funkcję aktywacji za pomocą poniższego diagramu.

Tutaj x1, x2, … x4 są węzłami sieci neuronowej.
w1, w2, w3 to wagi węzłów.
Suma (Σ) wszystkich wag i wartości węzłów działa jako funkcja aktywacji.
Dlaczego funkcja aktywacji?
Bez użycia funkcji aktywacji wyjście będzie liniowe, ale funkcjonalność funkcji liniowej jest ograniczona. Aby osiągnąć złożoną funkcjonalność, taką jak wykrywanie obiektów, klasyfikacja obrazów,ping W przypadku tekstu przekazywanego za pomocą głosu i wielu innych nieliniowych sygnałów wyjściowych, konieczna jest funkcja aktywacji.
Jak obliczana jest warstwa aktywacyjna w osadzaniu słów (Word2vec)
Warstwa Softmax (znormalizowana funkcja wykładnicza) to funkcja warstwy wyjściowej, która aktywuje lub uruchamia każdy węzeł. Innym stosowanym podejściem jest hierarchiczna funkcja Softmax, gdzie złożoność jest obliczana przez O(logarytm).2V), natomiast w softmax jest to O(V), gdzie V to rozmiar słownika. Różnica między nimi polega na redukcji złożoności w hierarchicznej warstwie softmax. Aby zrozumieć jej funkcjonalność, spójrz na poniższy przykład osadzania słów:

Załóżmy, że chcemy obliczyć prawdopodobieństwo zaobserwowania słowa miłość W danym kontekście. Przepływ od korzenia do węzła liścia najpierw przejdzie do węzła 2, a następnie do węzła 5. Zatem jeśli mamy 8 słów w słowniku, potrzebne są tylko trzy obliczenia. Pozwala to na dekompozycję obliczenia prawdopodobieństwa jednego słowa (miłość).
Jakie inne opcje są dostępne oprócz Hierarchical Softmax?
Ogólnie rzecz biorąc, dostępne opcje osadzania słów to: Differentiated Softmax, CNN-Softmax, Importance Sampling, Adaptive Importance Sampling, Noise Contrastive Estimation, Negative Sampling, Self-Normalization i Infrequent Normalization.
Mówiąc konkretnie o programie Word2vec, mamy do dyspozycji próbkowanie negatywne.
Próbkowanie ujemne to metoda próbkowania danych treningowych. Przypomina nieco metodę stochastycznego spadku gradientu, ale z pewnymi różnicami. Próbkowanie ujemne analizuje tylko negatywne przykłady treningowe. Opiera się na estymacji kontrastu szumu i losowo wybiera słowa, które nie występują w kontekście. Jest to szybka metoda treningowa, która losowo wybiera kontekst. Jeśli przewidywane słowo pojawia się w losowo wybranym kontekście, oba wektory są blisko siebie.
Jaki wniosek można wyciągnąć?
Aktywatory pobudzają neurony tak samo, jak nasze neurony są pobudzane przez bodźce zewnętrzne. Warstwa Softmax jest jedną z funkcji warstwy wyjściowej, która pobudza neurony w przypadku osadzania słów. W Word2vec dostępne są takie opcje, jak hierarchiczny softmax i próbkowanie ujemne. Za pomocą aktywatorów można przekształcić funkcję liniową w nieliniową, a za pomocą takich funkcji można zaimplementować złożony algorytm uczenia maszynowego.
Co to jest Gensim?
Gensim to zestaw narzędzi do modelowania tematów i przetwarzania języka naturalnego o otwartym kodzie źródłowym, który jest zaimplementowany w Python i Cython. Zestaw narzędzi Gensim umożliwia użytkownikom importowanie Word2vec do modelowania tematów i odkrywania ukrytej struktury w tekście. Gensim oferuje nie tylko implementację Word2vec, ale także Doc2vec i FastText.
Ta sekcja skupia się na Word2vec, więc skupimy się na bieżącym temacie.
Jak zaimplementować Word2vec przy użyciu Gensima
Do tej pory omówiliśmy, czym jest Word2vec, jakie są jego różne architektury, dlaczego nastąpiło przejście od zbioru słów do Word2vec, jaki jest związek między Word2vec i NLTK z kodem na żywo oraz jakie są funkcje aktywacyjne.
Poniżej przedstawiono krok po kroku metodę implementacji Word2vec przy użyciu Gensim:
Krok 1) Zbieranie danych
Pierwszym krokiem wdrożenia dowolnego modelu uczenia maszynowego lub przetwarzania języka naturalnego jest zbieranie danych.
Proszę zwrócić uwagę na dane, aby zbudować inteligentnego chatbota, jak pokazano w poniższym przykładzie Gensim Word2vec.
[{"tag": "welcome",
"patterns": ["Hi", "How are you", "Is any one to talk?", "Hello", "hi are you available"],
"responses": ["Hello, thanks for contacting us", "Good to see you here", "Hi there, how may I assist you?"]
        },
{"tag": "goodbye",
"patterns": ["Bye", "See you later", "Goodbye", "I will come back soon"],
"responses": ["See you later, thanks for visiting", "have a great day ahead", "Wish you Come back again soon."]
        },
{"tag": "thankful",
"patterns": ["Thanks for helping me", "Thank your guidance", "That's helpful and kind from you"],
"responses": ["Happy to help!", "Any time!", "My pleasure", "It is my duty to help you"]
        },
        {"tag": "hoursopening",
"patterns": ["What hours are you open?", "Tell your opening time?", "When are you open?", "Just your timing please"],
"responses": ["We're open every day 8am-7pm", "Our office hours are 8am-7pm every day", "We open office at 8 am and close at 7 pm"]
        },
{"tag": "payments",
"patterns": ["Can I pay using credit card?", "Can I pay using Mastercard?", "Can I pay using cash only?"],
"responses": ["We accept VISA, Mastercard and credit card", "We accept credit card, debit cards and cash. Please don't worry"]
        }
   ]
Oto, co możemy wywnioskować z danych:
- Dane te zawierają trzy elementy: tag, wzorzec i odpowiedzi. Tag to intencja (temat dyskusji).
- Dane są w formacie JSON.
- Wzór to pytanie, które użytkownicy zadadzą botowi.
- Odpowiedzi to odpowiedzi, których chatbot udzieli na odpowiednie pytanie/wzorzec.
Krok 2) Wstępne przetwarzanie danych
Bardzo ważne jest przetwarzanie surowych danych. Jeśli do maszyny zostaną wprowadzone oczyszczone dane, model będzie reagował dokładniej i efektywniej będzie się uczył danych.
Ten krok obejmuje usunięcie słów ignorowanych, stemmingu, niepotrzebnych słów itp. Przed przejściem dalej ważne jest załadowanie danych i przekonwertowanie ich do ramki danych. Proszę zapoznać się z poniższym kodem.
import json
json_file = 'intents.json'
with open('intents.json', 'r') as f:
    data = json.load(f)
Wyjaśnienie Code:
- Ponieważ dane są w formacie JSON, format JSON jest importowany.
- Plik jest przechowywany w zmiennej.
- Plik zostaje otwarty i załadowany do zmiennej danych.
Dane zostały zaimportowane i nadszedł czas na ich konwersję do ramki danych. Zapoznaj się z poniższym kodem, aby poznać kolejny krok.
import pandas as pd
df = pd.DataFrame(data)
df['patterns'] = df['patterns'].apply(', '.join)
Wyjaśnienie Code:
1. Dane są konwertowane do ramki danych przy użyciu pakietu pandas, który został zaimportowany powyżej.
2. Konwertuje listę we wzorcach kolumn na ciąg znaków.
from nltk.corpus import stopwords
from textblob import Word
stop = stopwords.words('english')
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x.lower() for x in x.split()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in string.punctuation))
df['patterns'] = df['patterns'].str.replace('[^\w\s]', '')
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if not x.isdigit()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in stop))
df['patterns'] = df['patterns'].apply(lambda x: " ".join([Word(word).lemmatize() for word in x.split()]))
Code Wyjaśnienie:
1. Angielskie słowa kluczowe są importowane za pomocą modułu „stop-word” z pakietu narzędzi nltk.
2. Wszystkie słowa tekstu są zamieniane na małe litery za pomocą warunku for i funkcji lambda. Funkcja Lambdy jest funkcją anonimową.
3. Sprawdzane są wszystkie wiersze tekstu w ramce danych pod kątem interpunkcji, a następnie poddawane filtrowaniu.
4. Znaki takie jak liczby lub kropki usuwa się za pomocą wyrażenia regularnego.
5. Digits zostały usunięte z tekstu.
6. Na tym etapie usuwane są słowa stop.
7. Słowa są teraz filtrowane, a różne formy tego samego słowa są usuwane za pomocą lematyzacji. W ten sposób zakończyliśmy wstępne przetwarzanie danych.
Wyjście:
, patterns, responses, tag
0,hi one talk hello hi available,"['Hello, thanks for contacting us', 'Good to see you here', ' Hi there, how may I assist you?']",welcome
1,bye see later goodbye come back soon,"['See you later, thanks for visiting', 'have a great day ahead', 'Wish you Come back again soon.']",goodbye
2,thanks helping thank guidance thats helpful kind,"['Happy to help!', 'Any time!', 'My pleasure', 'It is my duty to help you']",thankful
3,hour open tell opening time open timing please,"[""We're open every day 8am-7pm"", 'Our office hours are 8am-7pm every day', 'We open office at 8 am and close at 7 pm']",hoursopening
4,pay using credit card pay using mastercard pay using cash,"['We accept VISA, Mastercard and credit card', 'We accept credit card, debit cards and cash. Please dont worry']",payments
Krok 3) Budowa sieci neuronowej przy użyciu Word2vec
Teraz czas na zbudowanie modelu z wykorzystaniem modułu Word2vec programu Gensim. Musimy zaimportować Word2vec z Gensim. Zróbmy to, a następnie go zbudujemy, a na ostatnim etapie sprawdzimy model na danych w czasie rzeczywistym.
from gensim.models import Word2Vec
Teraz możemy pomyślnie zbudować model za pomocą Word2Vec. Zapoznaj się z kolejnym wierszem kodu, aby dowiedzieć się, jak utworzyć model za pomocą Word2Vec. Tekst jest dostarczany do modelu w formie listy, więc przekonwertujemy tekst z ramki danych na listę za pomocą poniższego kodu.
Bigger_list = []
for i in df['patterns']:
     li = list(i.split(""))
     Bigger_list.append(li)
Model = Word2Vec(Bigger_list, min_count=1, size=300, workers=4)
Wyjaśnienie Code:
1. Utworzono listę „big_list”, do której dołączona jest lista wewnętrzna. Ten format jest przekazywany do modelu Word2Vec.
2. Implementowana jest pętla, a każdy wpis kolumny wzorców ramki danych jest powtarzany.
3. Każdy element wzorca kolumnowego jest dzielony i zapisywany na wewnętrznej liście li.
4. Do listy wewnętrznej dołączona jest lista zewnętrzna.
5. Ta lista jest dostarczona dla modelu Word2Vec. Przyjrzyjmy się bliżej niektórym podanym tu parametrom.
Min_count: Ignoruje wszystkie słowa, których łączna częstość występowania jest niższa.
Rozmiar: Mówi o wymiarowości wektorów słów.
Pracownicy: Oto wątki służące do trenowania modelu.
Istnieją również inne opcje; poniżej wyjaśniono niektóre z nich.
Okno: Maksymalna odległość między bieżącym a przewidywanym słowem w zdaniu.
Sg: To algorytm treningowy: 1 dla skip-gramu i 0 dla ciągłego worka słów. Omówiliśmy je szczegółowo powyżej.
HS: Jeśli wartość wynosi 1, wówczas do szkolenia stosujemy hierarchiczną metodę softmax, a jeśli 0, wówczas używane jest próbkowanie ujemne.
Alfa: Początkowa szybkość uczenia się.
Wyświetlmy końcowy kod poniżej:
# list of libraries used by the code
import string
from gensim.models import Word2Vec
import logging
from nltk.corpus import stopwords
from textblob import Word
import json
import pandas as pd
# data in json format
json_file = 'intents.json'
with open('intents.json', 'r') as f:
    data = json.load(f)
# displaying the list of stopwords
stop = stopwords.words('english')
# dataframe
df = pd.DataFrame(data)

df['patterns'] = df['patterns'].apply(', '.join)
# cleaning the data using the NLP approach
print(df)
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x.lower() for x in x.split()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in string.punctuation))
df['patterns'] = df['patterns'].str.replace('[^\w\s]', '')
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if not x.isdigit()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in stop))
df['patterns'] = df['patterns'].apply(lambda x: " ".join([Word(word).lemmatize() for word in x.split()]))
# taking the outer list
bigger_list = []
for i in df['patterns']:
    li = list(i.split(" "))
    bigger_list.append(li)
# structure of data to be taken by the model.word2vec
print("Data format for the overall list:", bigger_list)
# custom data is fed to machine for further processing
model = Word2Vec(bigger_list, min_count=1, size=300, workers=4)
Krok 4) Zapis modelu
Model można zapisać w formacie bin i pliku modelu. Bin to format binarny. Aby zapisać model, zapoznaj się z poniższymi instrukcjami.
model.save("word2vec.model")
model.save("model.bin")
Wyjaśnienie powyższego kodu
1. Model zapisywany jest w postaci pliku .model.
2. Model zapisywany jest w postaci pliku .bin.
Wykorzystamy ten model do przeprowadzania testów w czasie rzeczywistym, np. w celu wykrycia podobnych i niepodobnych słów oraz najpopularniejszych słów.
Krok 5) Załadowanie modelu i wykonanie testów w czasie rzeczywistym
Model ładuje się za pomocą poniższego kodu:
model = Word2Vec.load('model.bin')
Jeśli chcesz wydrukować z niego słownik, możesz to zrobić za pomocą poniższego polecenia:
vocab = list(model.wv.vocab)
Proszę zobaczyć wynik:
['see', 'thank', 'back', 'thanks', 'soon', 'open', 'mastercard', 'card', 'time', 'pay', 'talk', 'cash', 'one', 'please', 'goodbye', 'thats', 'helpful', 'hour', 'credit', 'hi', 'later', 'guidance', 'opening', 'timing', 'hello', 'helping', 'bye', 'tell', 'come', 'using', 'kind', 'available']
Krok 6) Sprawdzanie większości podobnych słów
Zaimplementujmy rzeczy praktycznie:
similar_words = model.most_similar('thanks')
print(similar_words)
Proszę zobaczyć wynik:
[('kind', 0.16104359924793243), ('using', 0.1352398842573166), ('come', 0.11500970274209976), ('later', 0.09989878535270691), ('helping', 0.04855936020612717), ('credit', 0.04659383371472359), ('pay', 0.0329081267118454), ('thank', 0.02484947443008423), ('hour', 0.0202352125197649), ('opening', 0.018177658319473267)]
Krok 7) Nie pasuje do podanych słów
dissimlar_words = model.doesnt_match('See you later, thanks for visiting'.split())
print(dissimlar_words)
Dostarczyliśmy słowa Do zobaczenia później, dziękuję za wizytę. To wypisuje słowo najbardziej różniące się od siebie. Uruchommy ten kod i znajdźmy wynik.
Wynik po wykonaniu powyższego kodu:
Thanks
Krok 8) Znalezienie podobieństwa między dwoma słowami
Wynik jest wyrażony w kategoriach prawdopodobieństwa podobieństwa między dwoma słowami. Poniżej znajduje się kod, który pokazuje, jak wykonać tę sekcję.
similarity_two_words = model.similarity('please', 'see')
print("Please provide the similarity between these two words:")
print(similarity_two_words)
Wynik powyższego kodu jest następujący:
0.13706
Możesz znaleźć podobne słowa, wykonując poniższy kod:
similar = model.similar_by_word('kind')
print(similar)
Dane wyjściowe powyższego kodu:
[('credit', 0.11764447391033173), ('cash', 0.11440904438495636), ('one', 0.11151769757270813), ('hour', 0.0944807156920433), ('using', 0.0705675333738327), ('thats', 0.05206916481256485), ('later', 0.04502468928694725), ('bye', 0.03960943967103958), ('back', 0.03837274760007858), ('thank', 0.0380823090672493)]
