
Model Seq2seq (sekwencja do sekwencji) z PyTorch
 Zespół redakcyjny
⚡ Inteligentne podsumowanie
Seq2Seq to architektura kodera-dekodera, która mapuje sekwencję wejściową na sekwencję wyjściową przy użyciu dwóch rekurencyjnych sieci neuronowych, obsługując tłumaczenie maszynowe i inne zadania przetwarzania języka naturalnego, w których długości danych wejściowych i wyjściowych różnią się.
Co to jest NLP?
NLP, czyli przetwarzanie języka naturalnego, to jedna z popularnych gałęzi sztucznej inteligencji, która pomaga komputerom rozumieć, manipulować lub reagować na człowieka w jego języku naturalnym. NLP jest siłą napędową Google Translate co pomaga nam zrozumieć inne języki.
Co to jest Seq2Seq?
Sekwencja2sekw to metoda tłumaczenia maszynowego i przetwarzania języka oparta na koderze-dekoderze, która odwzorowuje wejście sekwencji na wyjście sekwencji ze znacznikiem i wartością uwagi. Pomysł jest taki, aby użyć 2 RNN, które będą współpracować ze specjalnym tokenem i próbować przewidzieć następną sekwencję stanów z poprzedniej sekwencji.
Jak przewidzieć sekwencję na podstawie poprzedniej sekwencji
Poniżej przedstawiono kroki umożliwiające przewidzenie sekwencji na podstawie poprzedniej sekwencji za pomocą PyTorch.
Krok 1) Ładowanie naszych danych
W przypadku naszego zbioru danych użyjesz zbioru danych z Pary zdań dwujęzycznych rozdzielane tabulatorami. W tym miejscu użyję zestawu danych z języka angielskiego na indonezyjski. Możesz wybrać cokolwiek chcesz, ale pamiętaj o zmianie nazwy pliku i katalogu w kodzie.
from __future__ import unicode_literals, print_function, division
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F

import numpy as np
import pandas as pd

import os
import re
import random

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
Krok 2) Przygotowanie danych
Nie można bezpośrednio korzystać ze zbioru danych. Należy podzielić zdania na słowa i przekształcić je w wektor jedno-gorący. Każde słowo zostanie jednoznacznie zindeksowane w klasie Lang, aby utworzyć słownik. Klasa Lang będzie przechowywać każde zdanie i dzielić je słowo po słowie za pomocą funkcji addSentence. Następnie utwórz słownik, indeksując każde nieznane słowo dla modeli sekwencyjnych.
SOS_token = 0
EOS_token = 1
MAX_LENGTH = 20

#initialize Lang Class
class Lang:
   def __init__(self):
       #initialize containers to hold the words and corresponding index
       self.word2index = {}
       self.word2count = {}
       self.index2word = {0: "SOS", 1: "EOS"}
       self.n_words = 2  # Count SOS and EOS

#split a sentence into words and add it to the container
   def addSentence(self, sentence):
       for word in sentence.split(' '):
           self.addWord(word)

#If the word is not in the container, the word will be added to it, else, update the word counter
   def addWord(self, word):
       if word not in self.word2index:
           self.word2index[word] = self.n_words
           self.word2count[word] = 1
           self.index2word[self.n_words] = word
           self.n_words += 1
       else:
           self.word2count[word] += 1
Klasa Lang to klasa, która pomoże nam utworzyć słownik. Dla każdego języka każde zdanie zostanie podzielone na słowa, a następnie dodane do kontenera. Każdy kontener będzie przechowywał słowa w odpowiednim indeksie, liczył słowa i dodawał indeks słowa, abyśmy mogli go użyć do znalezienia indeksu słowa lub wyszukania słowa z jego indeksu.
Ponieważ nasze dane są oddzielone tabulatorem, należy użyć pandy jako nasz moduł ładujący dane. Pandas odczyta nasze dane jako ramkę danych i podzieli je na zdanie źródłowe i docelowe. Dla każdego zdania, które posiadasz, znormalizujesz je do małych liter, usuniesz wszystkie znaki niebędące znakami, przekonwertujesz je z Unicode na ASCII i podzielisz zdania, aby zawierały wszystkie słowa.
#Normalize every sentence
def normalize_sentence(df, lang):
   sentence = df[lang].str.lower()
   sentence = sentence.str.replace('[^A-Za-z\s]+', '')
   sentence = sentence.str.normalize('NFD')
   sentence = sentence.str.encode('ascii', errors='ignore').str.decode('utf-8')
   return sentence

def read_sentence(df, lang1, lang2):
   sentence1 = normalize_sentence(df, lang1)
   sentence2 = normalize_sentence(df, lang2)
   return sentence1, sentence2

def read_file(loc, lang1, lang2):
   df = pd.read_csv(loc, delimiter='\t', header=None, names=[lang1, lang2])
   return df

def process_data(lang1,lang2):
   df = read_file('text/%s-%s.txt' % (lang1, lang2), lang1, lang2)
   print("Read %s sentence pairs" % len(df))
   sentence1, sentence2 = read_sentence(df, lang1, lang2)

   source = Lang()
   target = Lang()
   pairs = []
   for i in range(len(df)):
       if len(sentence1[i].split(' ')) < MAX_LENGTH and len(sentence2[i].split(' ')) < MAX_LENGTH:
           full = [sentence1[i], sentence2[i]]
           source.addSentence(sentence1[i])
           target.addSentence(sentence2[i])
           pairs.append(full)

   return source, target, pairs
Kolejną przydatną funkcją, z której skorzystasz, jest konwersja par na tensory. Jest to bardzo ważne, ponieważ nasza sieć odczytuje tylko dane typu tensor. Jest to również istotne, ponieważ jest to część, w której na każdym końcu zdania znajduje się token informujący sieć o zakończeniu wprowadzania danych. Dla każdego słowa w zdaniu sieć pobiera indeks z odpowiedniego słowa w słowniku i dodaje token na końcu zdania.
def indexesFromSentence(lang, sentence):
   return [lang.word2index[word] for word in sentence.split(' ')]

def tensorFromSentence(lang, sentence):
   indexes = indexesFromSentence(lang, sentence)
   indexes.append(EOS_token)
   return torch.tensor(indexes, dtype=torch.long, device=device).view(-1, 1)

def tensorsFromPair(input_lang, output_lang, pair):
   input_tensor = tensorFromSentence(input_lang, pair[0])
   target_tensor = tensorFromSentence(output_lang, pair[1])
   return (input_tensor, target_tensor)
Model Seq2Seq

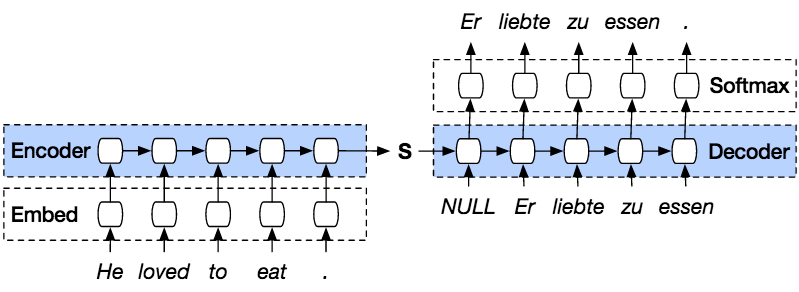
PyTorModel ch Seq2seq to rodzaj modelu wykorzystującego PyTorKoder-dekoder na modelu. Koder koduje zdanie słowo po słowie do indeksu słownika lub znanych słów z indeksem, a dekoder przewiduje wyjście zakodowanego wejścia, dekodując dane wejściowe sekwencyjnie i starając się użyć ostatniego wejścia jako następnego, jeśli to możliwe. Dzięki tej metodzie możliwe jest również przewidzenie następnego wejścia, aby utworzyć zdanie. Każde zdanie zostanie przypisane do tokena oznaczającego koniec sekwencji. Po zakończeniu predykcji pojawi się również token oznaczający koniec wyjścia. Zatem z kodera zostanie przekazany stan do dekodera, aby przewidzieć wyjście.

Koder zakoduje nasze zdanie wejściowe słowo po słowie, sekwencyjnie, a na końcu pojawi się token oznaczający koniec zdania. Koder składa się z warstwy osadzania i warstwy GRU. Warstwa osadzania to tablica wyszukiwania, która przechowuje osadzanie naszego wejścia w słowniku słów o stałym rozmiarze. Zostanie on przekazany do warstwy GRU. Warstwa GRU to bramkowana jednostka rekurencyjna, która składa się z wielowarstwowego typu RNN który obliczy sekwencyjne dane wejściowe. Ta warstwa obliczy stan ukryty na podstawie poprzedniej i zaktualizuje reset, aktualizację i nowe bramki.

Dekoder dekoduje sygnał wejściowy z wyjścia enkodera. Stara się przewidzieć kolejny sygnał wyjściowy i, jeśli to możliwe, użyć go jako kolejnego sygnału wejściowego. Dekoder składa się z warstwy osadzania, warstwy GRU oraz warstwy liniowej. Warstwa osadzania tworzy tabelę wyszukiwania dla sygnału wyjściowego i przekazuje ją do warstwy GRU w celu obliczenia przewidywanego stanu wyjściowego. Następnie warstwa liniowa pomaga obliczyć funkcję aktywacji, aby określić rzeczywistą wartość przewidywanego sygnału wyjściowego.
class Encoder(nn.Module):
   def __init__(self, input_dim, hidden_dim, embbed_dim, num_layers):
       super(Encoder, self).__init__()

       #set the encoder input dimesion , embbed dimesion, hidden dimesion, and number of layers
       self.input_dim = input_dim
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.num_layers = num_layers

       #initialize the embedding layer with input and embbed dimention
       self.embedding = nn.Embedding(input_dim, self.embbed_dim)
       #intialize the GRU to take the input dimetion of embbed, and output dimention of hidden and
       #set the number of gru layers
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)

   def forward(self, src):
       embedded = self.embedding(src).view(1,1,-1)
       outputs, hidden = self.gru(embedded)
       return outputs, hidden

class Decoder(nn.Module):
   def __init__(self, output_dim, hidden_dim, embbed_dim, num_layers):
       super(Decoder, self).__init__()

#set the encoder output dimension, embed dimension, hidden dimension, and number of layers
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.output_dim = output_dim
       self.num_layers = num_layers

# initialize every layer with the appropriate dimension. For the decoder layer, it will consist of an embedding, GRU, a Linear layer and a Log softmax activation function.
       self.embedding = nn.Embedding(output_dim, self.embbed_dim)
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)
       self.out = nn.Linear(self.hidden_dim, output_dim)
       self.softmax = nn.LogSoftmax(dim=1)

   def forward(self, input, hidden):
# reshape the input to (1, batch_size)
       input = input.view(1, -1)
       embedded = F.relu(self.embedding(input))
       output, hidden = self.gru(embedded, hidden)
       prediction = self.softmax(self.out(output[0]))
       return prediction, hidden

class Seq2Seq(nn.Module):
   def __init__(self, encoder, decoder, device, MAX_LENGTH=MAX_LENGTH):
       super().__init__()

#initialize the encoder and decoder
       self.encoder = encoder
       self.decoder = decoder
       self.device = device

   def forward(self, source, target, teacher_forcing_ratio=0.5):
       input_length = source.size(0) #get the input length (number of words in sentence)
       batch_size = target.shape[1]
       target_length = target.shape[0]
       vocab_size = self.decoder.output_dim

#initialize a variable to hold the predicted outputs
       outputs = torch.zeros(target_length, batch_size, vocab_size).to(self.device)

#encode every word in a sentence
       for i in range(input_length):
           encoder_output, encoder_hidden = self.encoder(source[i])

#use the encoder's hidden layer as the decoder hidden
       decoder_hidden = encoder_hidden.to(device)

#add a token before the first predicted word
       decoder_input = torch.tensor([SOS_token], device=device)  # SOS

#topk is used to get the top K value over a list
#predict the output word from the current target word. If we enable the teaching force, then the next decoder input is the next word, else, use the decoder output highest value.
       for t in range(target_length):
           decoder_output, decoder_hidden = self.decoder(decoder_input, decoder_hidden)
           outputs[t] = decoder_output
           teacher_force = random.random() < teacher_forcing_ratio
           topv, topi = decoder_output.topk(1)
           input = (target[t] if teacher_force else topi)
           if(teacher_force == False and input.item() == EOS_token):
               break

       return outputs
Krok 3) Trenowanie modelu
Proces uczenia w modelach Seq2seq rozpoczyna się od konwersji każdej pary zdań na tensory na podstawie ich indeksu Lang. Nasz model konwersji sekwencji na sekwencję będzie wykorzystywał SGD jako optymalizator oraz funkcję NLLLoss do obliczania strat. Proces uczenia rozpoczyna się od podania pary zdań do modelu w celu przewidzenia poprawnego wyniku. Na każdym kroku wynik z modelu będzie obliczany przy użyciu prawdziwych słów, aby znaleźć straty i zaktualizować parametry. Ponieważ wykonasz 75000 iteracji, nasz model konwersji sekwencji na sekwencję wygeneruje 75000 losowych par z naszego zbioru danych.
teacher_forcing_ratio = 0.5

def clacModel(model, input_tensor, target_tensor, model_optimizer, criterion):
   model_optimizer.zero_grad()

   input_length = input_tensor.size(0)
   loss = 0
   epoch_loss = 0
   # print(input_tensor.shape)

   output = model(input_tensor, target_tensor)

   num_iter = output.size(0)
   print(num_iter)

#calculate the loss from a predicted sentence with the expected result
   for ot in range(num_iter):
       loss += criterion(output[ot], target_tensor[ot])

   loss.backward()
   model_optimizer.step()
   epoch_loss = loss.item() / num_iter

   return epoch_loss

def trainModel(model, source, target, pairs, num_iteration=20000):
   model.train()

   optimizer = optim.SGD(model.parameters(), lr=0.01)
   criterion = nn.NLLLoss()
   total_loss_iterations = 0

   training_pairs = [tensorsFromPair(source, target, random.choice(pairs))
                     for i in range(num_iteration)]

   for iter in range(1, num_iteration+1):
       training_pair = training_pairs[iter - 1]
       input_tensor = training_pair[0]
       target_tensor = training_pair[1]

       loss = clacModel(model, input_tensor, target_tensor, optimizer, criterion)

       total_loss_iterations += loss

       if iter % 5000 == 0:
           avarage_loss= total_loss_iterations / 5000
           total_loss_iterations = 0
           print('%d %.4f' % (iter, avarage_loss))

   torch.save(model.state_dict(), 'mytraining.pt')
   return model
Krok 4) Przetestuj model
Proces oceny Seq2seq PyTorZadaniem ch jest sprawdzenie wyników modelu. Każda para modeli „Sekwencja do sekwencji” zostanie wprowadzona do modelu i wygeneruje przewidywane słowa. Następnie sprawdzisz najwyższą wartość na każdym wyjściu, aby znaleźć prawidłowy indeks. Na koniec porównasz ją, aby sprawdzić naszą prognozę modelu z prawdziwym zdaniem.
def evaluate(model, input_lang, output_lang, sentences, max_length=MAX_LENGTH): with torch.no_grad(): input_tensor = tensorFromSentence(input_lang, sentences[0]) output_tensor = tensorFromSentence(output_lang, sentences[1]) decoded_words = [] output = model(input_tensor, output_tensor) # print(output_tensor) for ot in range(output.size(0)): topv, topi = output[ot].topk(1) # print(topi) if topi[0].item() == EOS_token: decoded_words.append('' ) break else: decoded_words.append(output_lang.index2word[topi[0].item()]) return decoded_words def evaluateRandomly(model, source, target, pairs, n=10): for i in range(n): pair = random.choice(pairs) print('source {}'.format(pair[0])) print('target {}'.format(pair[1])) output_words = evaluate(model, source, target, pair) output_sentence = ' '.join(output_words) print('predicted {}'.format(output_sentence))
Teraz zacznijmy szkolenie za pomocą Seq to Seq, z liczbą iteracji równą 75000 i liczbą warstw RNN równą 1 i ukrytym rozmiarem 512.
lang1 = 'eng'
lang2 = 'ind'
source, target, pairs = process_data(lang1, lang2)

randomize = random.choice(pairs)
print('random sentence {}'.format(randomize))

#print number of words
input_size = source.n_words
output_size = target.n_words
print('Input : {} Output : {}'.format(input_size, output_size))

embed_size = 256
hidden_size = 512
num_layers = 1
num_iteration = 100000

#create encoder-decoder model
encoder = Encoder(input_size, hidden_size, embed_size, num_layers)
decoder = Decoder(output_size, hidden_size, embed_size, num_layers)

model = Seq2Seq(encoder, decoder, device).to(device)

#print model
print(encoder)
print(decoder)

model = trainModel(model, source, target, pairs, num_iteration)
evaluateRandomly(model, source, target, pairs)
Jak widać, nasze przewidywane zdanie nie jest zbyt dobrze dopasowane, więc aby uzyskać większą dokładność, musisz trenować z dużo większą ilością danych i próbować dodać więcej iteracji i liczbę warstw za pomocą Sequence do uczenia się sekwencyjnego.
random sentence ['tom is finishing his work', 'tom sedang menyelesaikan pekerjaannya']
Input : 3551 Output : 4253
Encoder(
  (embedding): Embedding(3551, 256)
  (gru): GRU(256, 512)
)
Decoder(
  (embedding): Embedding(4253, 256)
  (gru): GRU(256, 512)
  (out): Linear(in_features=512, out_features=4253, bias=True)
  (softmax): LogSoftmax()
)
5000 4.0906
10000 3.9129
15000 3.8171
20000 3.8369
25000 3.8199
30000 3.7957
75000 3.7044
