
Jak obsługiwać tabelę internetową w Selenium
 Krishna Szczebel
⚡ Inteligentne podsumowanie
Selenium Obsługa tabel internetowych umożliwia inżynierom ds. zapewnienia jakości odczytywanie danych tabelarycznych z wierszy i kolumn HTML przy użyciu XPath, CSS i Selenium 4 lokalizatory względne. W tym artykule omówiono tabele statyczne, tabele zagnieżdżone, predykaty atrybutów i techniki sztucznej inteligencji dla siatek dynamicznych.
W czym jest tabela internetowa Selenium?
A Tabela internetowa in Selenium to element WebElement służący do tabelarycznej reprezentacji danych lub informacji. Wyświetlane dane mogą być statyczne lub dynamiczne. Dostęp do komórek i wierszy tabeli WebElement odbywa się za pomocą metod WebElement połączonych z lokalizatorami. Typowym przykładem jest siatka specyfikacji produktu wyświetlana na stronie produktu w sklepie internetowym.
Odczytywanie tabeli HTML Web
Testerzy często potrzebują dostępu do elementów, zazwyczaj wartości tekstowych, znajdujących się w tabelach HTML. Projektanci stron internetowych rzadko jednak dodają atrybut id lub name do poszczególnych komórek. Dlatego metody takie jak By.id(), By.name() czy By.cssSelector() rzadko działają. W tym scenariuszu najpewniejszą opcją jest By.xpath(), ponieważ analizuje relacje nadrzędny-podrzędny wewnątrz znacznika tabeli.
Jak obsługiwać tabelę internetową w Selenium
Rozważ poniższy kod HTML do obsługi tabel internetowych Selenium.

Użyjemy XPath aby uzyskać tekst wewnętrzny komórki zawierającej tekst „czwarta komórka”.

Krok 1 – Ustaw element nadrzędny (tabelę)
Lokalizatory XPath w WebDriver zawsze zaczynają się od podwójnego ukośnika „//”, po którym następuje element nadrzędny. Ponieważ mamy do czynienia z tabelami internetowymi w Selenium, elementem nadrzędnym powinien zawsze być etykietka. Pierwsza część naszego Selenium Lokalizator tabeli XPath musi zatem zaczynać się od „//table”.

Krok 2 – Dodaj elementy podrzędne
Element bezpośrednio pod Jest , Więc jest dzieckiem . Odwrotnie, jest rodzicem Wszystkie elementy podrzędne w XPath są umieszczane po prawej stronie elementu nadrzędnego i rozdzielone jednym ukośnikiem „/”, jak pokazano poniżej.


Krok 3 – Dodaj predykaty
Ten element zawiera dwa Tagi. Te dwa tagi są elementami podrzędnymi , Więc jest rodzicem obojga. Dwoje elementy są rodzeństwem. Rodzeństwo to elementy potomne, które mają tego samego rodzica.
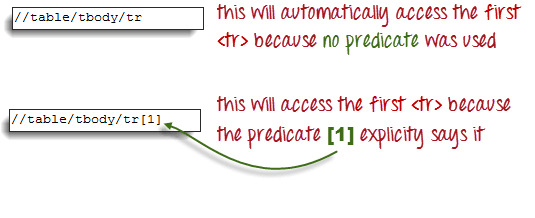
Aby dotrzeć do który zawiera „czwartą komórkę”, musimy najpierw uzyskać dostęp do Dopiero , nie pierwszy. Wpisanie tylko „//table/tbody/tr” będzie dotyczyło pierwszego etykietka.
Jak więc uzyskać dostęp do drugiego ? Odpowiedź brzmi: użyj Predykaty. Predykaty to liczby lub atrybuty HTML ujęte w nawiasy kwadratowe „[ ]”, które odróżniają element podrzędny od jego elementów pokrewnychPonieważ wiersz, którego potrzebujemy, jest drugim, jako predykat używamy „[2]”.

Jeśli pominiemy predykat, XPath zwróci pierwszy element bliźniaczy. Zatem każdy z poniższych kodów XPath dotrze do pierwszego .
Krok 4 – Dodaj kolejne elementy potomne, używając odpowiednich predykatów
Następnym elementem, którego potrzebujemy jest drugi Stosując zasady z kroków 2 i 3, dochodzimy do XPath pokazanego poniżej.

Teraz, gdy mamy poprawny lokalizator XPath, możemy uzyskać dostęp do komórki i odczytać jej tekst wewnętrzny za pomocą poniższego kodu. Zakłada to, że strona HTML została zapisana jako „newhtml.html” na dysku C.

public static void main(String[] args) {
    String baseUrl = "https://demo.guru99.com/test/write-xpath-table.html";
    WebDriver driver = new FirefoxDriver();

    driver.get(baseUrl);
    String innerText = driver.findElement(
        By.xpath("//table/tbody/tr[2]/td[2]")).getText();
    System.out.println(innerText);
    driver.quit();
}
Dostęp do zagnieżdżonych tabel
Te same zasady dotyczą tabel zagnieżdżonych. Tabele zagnieżdżone to tabele umieszczone wewnątrz innej tabeli. Przykład jest pokazany poniżej.


Aby uzyskać dostęp do komórki zawierającej tekst „4-5-6” korzystając z koncepcji rodzica/dziecka i predykatu z poprzedniej sekcji, możemy utworzyć ścieżkę XPath pokazaną poniżej.

Poniższy kod WebDriver pobiera wewnętrzny tekst docelowej komórki.

public static void main(String[] args) {
    String baseUrl = "https://demo.guru99.com/test/accessing-nested-table.html";
    WebDriver driver = new FirefoxDriver();

    driver.get(baseUrl);
    String innerText = driver.findElement(
        By.xpath("//table/tbody/tr[2]/td[2]/table/tbody/tr/td[2]")).getText();
    System.out.println(innerText);
    driver.quit();
}
Poniższe dane wyjściowe potwierdzają, że pomyślnie uzyskano dostęp do tabeli wewnętrznej.

Używanie atrybutów jako predykatów
Jeśli element znajduje się głęboko w kodzie HTML, gdzie liczenie elementów pokrewnych staje się uciążliwe, możemy zamiast tego wykorzystać atrybut unique tego elementu.
W poniższym przykładzie komórka „Nowy Jork – Chicago” jest głęboko zakopana w Mercury Strona główna wycieczek.

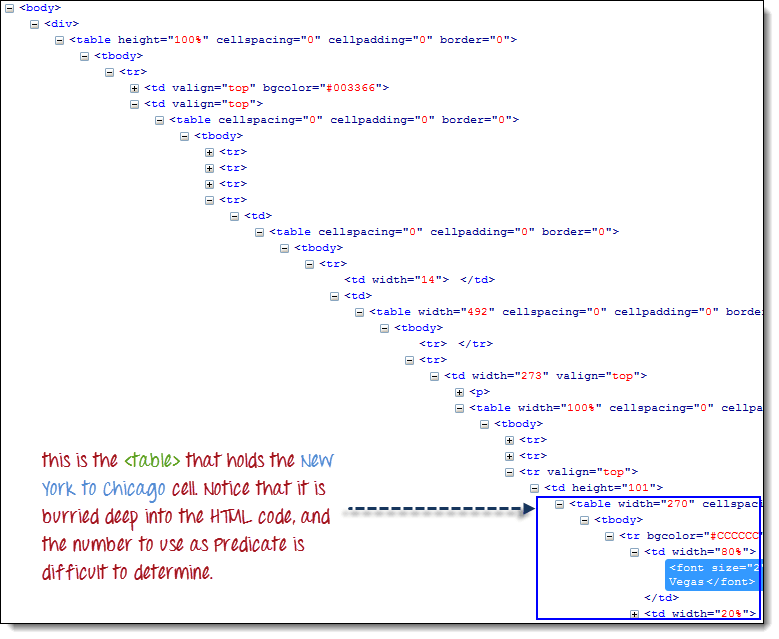
Jako predykatu możemy użyć unikalnego atrybutu tabeli (szerokość=”270″). Atrybuty są używane jako predykaty poprzez poprzedzenie ich symbolem @W powyższym przykładzie komórka „Nowy Jork – Chicago” znajduje się w pierwszej czwartego , więc nasza ścieżka XPath powinna wyglądać tak, jak pokazano poniżej.

Pamiętaj, że gdy wstawisz XPath do środka Java, zastąp podwójne cudzysłowy wokół „270” ukośnikiem odwrotnym, aby ciąg By.xpath() nie został zakończony przedwcześnie.

Jesteśmy teraz gotowi, aby uzyskać dostęp do tej komórki za pomocą poniższego kodu.

public static void main(String[] args) {
    String baseUrl = "https://demo.guru99.com/test/newtours/";
    WebDriver driver = new FirefoxDriver();

    driver.get(baseUrl);
    String innerText = driver.findElement(By
        .xpath("//table[@width=\"270\"]/tbody/tr[4]/td"))
        .getText();
    System.out.println(innerText);
    driver.quit();
}
Skrót: użyj elementu Inspect, aby uzyskać dostęp do tabel w Selenium
Jeśli trudno jest uzyskać indeks lub atrybut elementu, najszybszym sposobem wygenerowania XPath jest użycie funkcji Inspect Element w narzędziach deweloperskich nowoczesnych przeglądarek.
Rozważ poniższy przykład z Mercury Strona główna wycieczek.

Krok 1
Kliknij prawym przyciskiem myszy komórkę docelową i wybierz polecenie Inspekcja, aby wyświetlić ścieżkę DOM, a następnie skopiuj pełną ścieżkę XPath.

Krok 2
Poszukaj pierwszego elementu nadrzędnego „tabeli” i usuń wszystko po jego lewej stronie.

Krok 3
Pozostałą część XPath poprzedź podwójnym ukośnikiem „//” i skopiuj ją do kodu WebDriver.

Poniższy kod WebDriver pobiera tekst wewnętrzny głęboko zagnieżdżonego elementu.

public static void main(String[] args) {
    String baseUrl = "https://demo.guru99.com/test/newtours/";
    WebDriver driver = new FirefoxDriver();

    driver.get(baseUrl);
    String innerText = driver.findElement(By
        .xpath("//table/tbody/tr/td[2]"
        + "//table/tbody/tr[4]/td/"
        + "table/tbody/tr/td[2]/"
        + "table/tbody/tr[2]/td[1]/"
        + "table[2]/tbody/tr[3]/td[2]/font"))
        .getText();
    System.out.println(innerText);
    driver.quit();
}
Jak zliczać wiersze i kolumny w dynamicznej tabeli internetowej
Dynamiczne tabele internetowe, takie jak pulpity nawigacyjne czy wyniki wyszukiwania, renderują różną liczbę wierszy przy każdym ładowaniu. Aby sobie z nimi poradzić, użyj findElements aby zdobyć każdy do listy, a następnie wykonaj pętlę, aby odczytać każdą komórkę. Poniższy fragment kodu zlicza wiersze i odczytuje każdą komórkę w tabeli, której identyfikator to „klienci”.
List<WebElement> rows = driver.findElements(
    By.xpath("//table[@id='customers']//tr"));
System.out.println("Total rows: " + rows.size());

for (int i = 1; i <= rows.size(); i++) {
    List<WebElement> cells = driver.findElements(
        By.xpath("//table[@id='customers']//tr[" + i + "]/td"));
    for (WebElement cell : cells) {
        System.out.println(cell.getText());
    }
}
Owiń lokalizator w WebDriverWait w visibilityOfAllElementsLocatedBy gdy tabela jest ładowana przez AJAX. Zapobiega to nieaktualnym odwołaniom do elementów w wolno renderujących się siatkach.
Selenium 4 lokalizatory względne dla tabel internetowych
Selenium 4 wprowadził lokalizatory względne, które wskazują elementy według pozycji wizualnej. Są one przydatne, gdy indeksy XPath ulegają uszkodzeniu z powodu zmiany kolejności wierszy. Metody above(), below(), toLeftOf(), toRightOf(), near() wszystkie akceptują element zakotwiczony WebElement.
import static org.openqa.selenium.support.locators.RelativeLocator.with;

WebElement emailHeader = driver.findElement(By.xpath("//th[text()='Email']"));
WebElement emailCell = driver.findElement(
    with(By.tagName("td")).below(emailHeader));
System.out.println(emailCell.getText());
Lokalizatory względne pozostają czytelne, gdy zmienia się kolejność kolumn. Połącz je z jawnymi oczekiwaniami na najsilniejsze wyniki na stronach opartych na danych.
Narzędzia AI do obsługi dynamicznych tabel internetowych
Platformy testowe wspomagane sztuczną inteligencją redukują konieczność konserwacji lokalizatorów w sieciach, które często się zmieniają. Narzędzia takie jak Testim, Mabl, Funkcjonować Wykorzystują komputerowe widzenie i modele DOM do wykrywania przesunięć kolumn i samonaprawiających się lokalizatorów. Identyfikują wiersze na podstawie tekstu nagłówka i podobieństwa komórek, a nie stałych indeksów XPath.
Dla czystej Selenium projekty, biblioteki takie jak Healenium Opakuj WebDriver i przepisz uszkodzone lokalizatory w czasie wykonywania. Połącz te narzędzia z WebDriverWait, aby zachować stabilność skryptów tabel dynamicznych bez przepisywania selektorów po każdej zmianie interfejsu użytkownika.
Podsumowanie
- By.xpath() to najbardziej niezawodny sposób dostępu do komórek tabeli internetowej w Selenium.
- Jeśli trudno jest policzyć rodzeństwo, użyj unikatowego atrybutu jako predykatu, poprzedzonego symbolem @.
- findElements zwraca listę który obsługuje liczenie wierszy w tabelach dynamicznych.
- Selenium 4 lokalizatory względne (powyżej, poniżej, w pobliżu) redukują zależność od XPath pozycyjnego.
- Funkcja Inspect Element w DevTools przyspiesza generowanie XPath dla głęboko ukrytych komórek.
- Narzędzia AI, takie jak Testim, Mabl i Healenium – samonaprawiające się lokalizatory do zmiany siatek.
