
Wielokrotna regresja liniowa w R: prosta i krokowa z przykładami
 Evelyn Clarke
⚡ Inteligentne podsumowanie
Prosta i wielokrotna regresja liniowa w R modeluje wynik ciągły jako ważoną sumę predyktorów dopasowanych metodą najmniejszych kwadratów. Ten przewodnik obejmuje lm(), odczyt współczynników, predyktory czynnikowe, diagnostykę reszt, predykcję i automatyczny dobór zmiennych.
Gdzie regresja liniowa wpisuje się w uczenie maszynowe
Regresja liniowa jest jedną z najstarszych nadzorowanych metod uczenie maszynowe algorytmy i nadal jest to pierwszy model, po który sięga większość analityków. Jednym z najwcześniejszych zastosowań uczenia maszynowego był filtr spamu.
Inne typowe zastosowania uczenia maszynowego obejmują:
- Identyfikacja niechcianych wiadomości spamowych w wiadomościach e-mail
- Segmentacja zachowań klientów pod kątem reklamy ukierunkowanej
- Ograniczenie nieuczciwych transakcji kartami kredytowymi
- Optymalizacja zużycia energii w domach i budynkach biurowych
- Rozpoznawanie twarzy
Nadzorowana nauka
In Nadzorowana nauka, dane szkoleniowe, które przekazujesz algorytmowi, zawierają etykietę.
Klasyfikacja Jest prawdopodobnie najczęściej stosowaną techniką uczenia nadzorowanego. Jednym z pierwszych zadań klasyfikacyjnych, z którymi zmierzyli się badacze, był filtr spamu. Celem uczenia jest przewidzenie, czy wiadomość e-mail zostanie sklasyfikowana jako spam, czy jako ham (dobry e-mail). Po etapie uczenia maszyna potrafi wykryć klasę wiadomości.
Regresje są powszechnie stosowane w dziedzinie uczenia maszynowego do przewidywania wartości ciągłej. Zadanie regresji może przewidywać wartość zmienna zależna w oparciu o zestaw niezależne zmienne (zwane także predyktorami lub regresorami). Na przykład regresja liniowa może przewidzieć cenę akcji, prognozę pogody, sprzedaż i tak dalej.
Niektóre podstawowe algorytmy uczenia nadzorowanego to:
- Regresja liniowa
- Regresja logistyczna
- Najbliżsi sąsiedzi
- Obsługa maszyny wektorowej (SVM)
- Drzewa decyzyjne i losowy las
- Sieci neuronowe
Uczenie się bez nadzoru
In Uczenie się bez nadzoru, dane treningowe są nieoznakowane. System próbuje uczyć się bez odniesienia. Poniżej znajduje się lista algorytmów uczenia bez nadzoru.
- K-średnia
- Hierarchiczny Cluster Analiza
- Maksymalizacja oczekiwań
- Wizualizacja i redukcja wymiarowości
- Analiza głównych składowych
- PCA jądra
- Osadzanie lokalnie-liniowe
Mając na uwadze ten kontekst, w dalszej części tego samouczka krok po kroku budujemy modele regresji w języku R.
Prosta regresja liniowa w R
Regresja liniowa odpowiada na proste pytanie: czy można zmierzyć dokładną zależność między jedną zmienną docelową i zbiorem predyktorów?
Najprostszym modelem probabilistycznym jest model liniowy:

gdzie
- y = zmienna zależna
- x = zmienna niezależna
-
 = składnik błędu losowego
-
 = przechwycić
-
 = Współczynnik x
Rozważmy następującą fabułę:
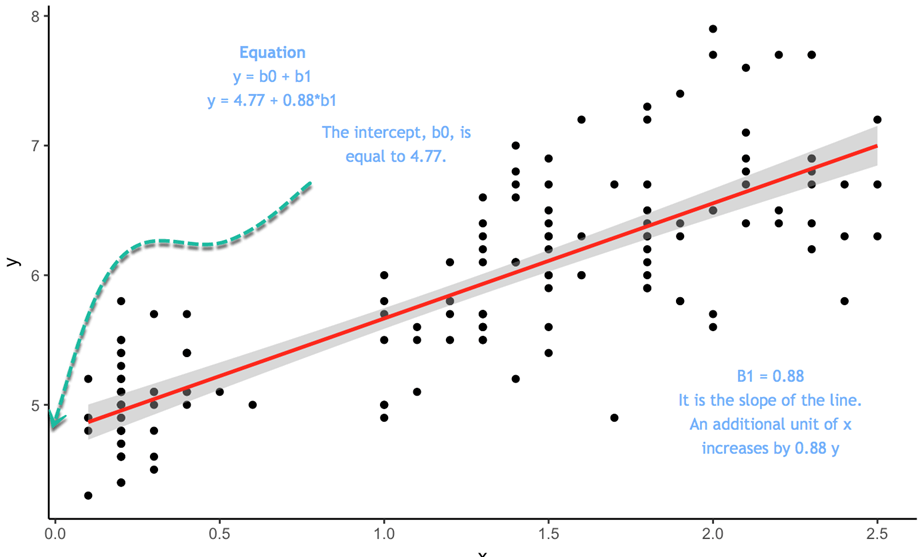
Równanie to 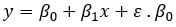 W tym równaniu punkt przecięcia wynosi 4.77, więc gdy x jest równe 0, dopasowana wartość y wynosi 4.77. Nachylenie pokazuje, w jakiej proporcji y zmienia się, gdy x się zmienia.
Aby oszacować optymalne wartości  oraz
 , używasz metody zwanej Zwykłe najmniejsze kwadraty (OLS). Metoda ta stara się znaleźć parametry minimalizujące sumę kwadratów błędów, czyli odległość pionową pomiędzy przewidywanymi wartościami y i rzeczywistymi wartościami y. Różnica jest znana jako termin błędu.
Przed oszacowaniem modelu można określić, czy liniowa zależność między y i x jest wiarygodna, wykreślając wykres rozrzutu.
Wykres punktowy
Do wyjaśnienia koncepcji prostej regresji liniowej użyjemy bardzo prostego zbioru danych. Zaimportujemy średni wzrost i wagę amerykańskich kobiet. Zbiór danych zawiera 15 obserwacji. Chcesz zmierzyć, czy wzrost jest dodatnio skorelowany z wagą.
library(ggplot2)
path <- 'https://raw.githubusercontent.com/guru99-edu/R-Programming/master/women.csv'
df <-read.csv(path)
ggplot(df,aes(x=height, y =  weight))+
geom_point()
Wyjście:

Wykres punktowy sugeruje ogólną tendencję wzrostu wagi wraz ze wzrostem wzrostu. W następnym kroku zmierzysz, o ile wzrasta waga wraz z każdą dodatkową jednostką wzrostu.
Oszacowania najmniejszych kwadratów
W prostej regresji OLS obliczenie  oraz jest proste. Ten samouczek nie wyprowadza wzorów, a jedynie je podaje.
Chcesz oszacować: 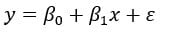
Celem regresji OLS jest zminimalizowanie następującego równania:

gdzie
 jest rzeczywistą wartością i
 jest wartością przewidywaną.
Rozwiązanie dla is 
Należy pamiętać, że  oznacza średnią wartość x
Rozwiązanie dla  is

W R możesz użyć funkcji cov() i var() do oszacowania i możesz użyć funkcji mean() do oszacowania 
beta <- cov(df$height, df$weight) / var (df$height)
beta
Wyjście:
##[1] 3.45
alpha <- mean(df$weight) - beta * mean(df$height)
alpha
Wyjście:
## [1] -87.51667
Współczynnik beta oznacza, że każdy dodatkowy cal wzrostu powoduje zwiększenie średniej wagi o 3.45 funta.
Ręczne szacowanie równania liniowego jest pouczające, ale niepraktyczne. R udostępnia funkcję lm(), która zrobi to za Ciebie, i będziesz jej używać od następnej sekcji. W rzeczywistych projektach prawie nigdy nie uda Ci się dopasować modelu z jednym predyktorem; zadania regresyjne zazwyczaj wymagają użycia wielu estymatorów jednocześnie.
Wielokrotna regresja liniowa w R
Praktyczne zastosowania analizy regresji wykorzystują modele bardziej złożone niż prosty model liniowy. Model probabilistyczny obejmujący więcej niż jedną zmienną niezależną nazywa się modele regresji wielokrotnej. Ogólna postać tego modelu to:

W notacji macierzowej możesz przepisać model:

Zmienna zależna y jest teraz funkcją k zmiennych niezależnych. Wartość współczynnika  określa udział zmiennej niezależnej
 oraz .
Krótko przedstawimy założenie, które przyjęliśmy na temat błędu losowego  z OLS:
- Średnia równa 0
- Wariancja równa

- Normalna dystrybucja
- Błędy losowe są niezależne (w sensie probabilistycznym)

Musisz rozwiązać , wektor współczynników regresji, który minimalizuje sumę kwadratów błędów między przewidywaną i rzeczywistą wartością y.
Rozwiązanie w formie zamkniętej to:

z:
- wskazuje transponować macierzy X
 wskazuje odwracalna macierz
 wskazuje odwracalna macierz
Poniższe przykłady wykorzystują wbudowany zbiór danych mtcars. Celem jest przewidywanie liczby mil na galon (mpg) na podstawie zestawu cech.
Zmienne ciągłe w R
Na razie użyjesz tylko zmiennych ciągłych i odłożysz na bok cechy kategoryczne. Zmienna am jest zmienną binarną przyjmującą wartość 1, jeśli skrzynia biegów jest manualna i 0 dla samochodów z automatyczną skrzynią biegów; vs jest również zmienną binarną.
library(dplyr)
df <- mtcars %>%
select(-c(am, vs, cyl, gear, carb))
glimpse(df)
Wyjście:
## Observations: 32
## Variables: 6
## $ mpg  <dbl> 21.0, 21.0, 22.8, 21.4, 18.7, 18.1, 14.3, 24.4, 22.8, 19....
## $ disp <dbl> 160.0, 160.0, 108.0, 258.0, 360.0, 225.0, 360.0, 146.7, 1...
## $ hp   <dbl> 110, 110, 93, 110, 175, 105, 245, 62, 95, 123, 123, 180, ...
## $ drat <dbl> 3.90, 3.90, 3.85, 3.08, 3.15, 2.76, 3.21, 3.69, 3.92, 3.9...
## $ wt   <dbl> 2.620, 2.875, 2.320, 3.215, 3.440, 3.460, 3.570, 3.190, 3...
## $ qsec <dbl> 16.46, 17.02, 18.61, 19.44, 17.02, 20.22, 15.84, 20.00, 2...
Do obliczenia parametrów można użyć funkcji lm(). Podstawowa składnia tej funkcji jest następująca:
lm(formula, data, subset)
Arguments:
	-formula: The equation you want to estimate
	-data: The dataset used
	-subset: Estimate the model on a subset of the dataset
Pamiętaj, że równanie ma następującą postać

w R
- Symbol = zostaje zastąpiony przez ~
- Każde x jest zastępowane nazwą zmiennej
- Jeśli chcesz usunąć stałą, dodaj -1 na końcu formuły
Przykład:
Chcesz oszacować wagę poszczególnych osób na podstawie ich wzrostu i dochodów. Równanie jest

Równanie w R zapisuje się w następujący sposób:
y ~ X1+ X2+…+Xn # Z przecięciem
A więc dla naszego przykładu:
- Zważ ~ wzrost + dochód
Twoim celem jest oszacowanie mili na galon na podstawie zestawu zmiennych. Równanie do oszacowania to:

Oszacujesz swoją pierwszą regresję liniową i zapiszesz wynik w dopasowanym obiekcie.
model <- mpg ~ disp + hp + drat + wt + qsec
fit <- lm(model, df)
fit
Code Wyjaśnienie
- model <- mpg ~ disp + hp + drat + wt + qsec: Zapisz model, aby oszacować
- lm(model, df): Oszacuj model za pomocą ramki danych df
##
## Call:
## lm(formula = model, data = df)
##
## Coefficients:
## (Intercept)         disp           hp         drat           wt
##    16.53357      0.00872     -0.02060      2.01577     -4.38546
##        qsec
##     0.64015
Dane wyjściowe nie dostarczają wystarczających informacji o jakości dopasowania. Możesz uzyskać dostęp do większej ilości szczegółów, takich jak istotność współczynników, stopień swobody i kształt reszt za pomocą funkcji summary().
summary(fit)
Wyjście:
## return the p-value and coefficient
##
## Call:
## lm(formula = model, data = df)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -3.5404 -1.6701 -0.4264  1.1320  5.4996
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 16.53357   10.96423   1.508  0.14362
## disp         0.00872    0.01119   0.779  0.44281
## hp          -0.02060    0.01528  -1.348  0.18936
## drat         2.01578    1.30946   1.539  0.13579
## wt          -4.38546    1.24343  -3.527  0.00158 **
## qsec         0.64015    0.45934   1.394  0.17523
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.558 on 26 degrees of freedom
## Multiple R-squared:  0.8489, Adjusted R-squared:  0.8199
## F-statistic: 29.22 on 5 and 26 DF, p-value: 6.892e-10
Wniosek z wyników powyższej tabeli
- Tabela pokazuje silną negatywną zależność między wt i mpg oraz dodatni współczynnik dla drat.
- Jedynie zmienna wt ma statystyczny wpływ na mpg. Pamiętaj, że aby przetestować hipotezę w statystyce, używamy:
- H0: Brak wpływu statystycznego
- H1: Predyktor ma znaczący wpływ na y
- Jeśli wartość p jest mniejsza niż 0.05, oznacza to, że zmienna jest istotna statystycznie
- Skorygowany R-kwadrat: udział wariancji y wyjaśniony przez model, skorygowany o liczbę predyktorów. W tym przypadku wynosi on 0.8199, co oznacza, że model wyjaśnia około 82 procent wariancji mpg. R-kwadrat zawsze mieści się w przedziale od 0 do 1, a im wyższa wartość, tym lepiej.
Możesz uruchomić ANOVA test mający na celu oszacowanie wpływu każdej cechy na wariancje za pomocą funkcji anova().
anova(fit)
Wyjście:
## Analysis of Variance Table
##
## Response: mpg
##           Df Sum Sq Mean Sq  F value   Pr(>F)
## disp       1 808.89  808.89 123.6185 2.23e-11 ***
## hp         1  33.67   33.67   5.1449 0.031854 *
## drat       1  30.15   30.15   4.6073 0.041340 *
## wt         1  70.51   70.51  10.7754 0.002933 **
## qsec       1  12.71   12.71   1.9422 0.175233
## Residuals 26 170.13    6.54
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Bardziej konwencjonalnym sposobem oszacowania wydajności modelu jest przedstawienie reszty w odniesieniu do różnych miar.
Możesz użyć funkcji plot(), aby wyświetlić cztery wykresy:
– Wartości reszty a wartości dopasowane
– Wykres normalnego QQ: kwartyl teoretyczny vs reszty standaryzowane
– Lokalizacja skali: dopasowane wartości vs pierwiastki kwadratowe reszt standaryzowanych
– Pozostałości a dźwignia: Dźwignia a standardowe reszty
Dodajesz kod par(mfrow = c(2, 2)) przed plot(fit). Jeśli nie dodasz tej linijki kodu, R poprosi Cię o naciśnięcie klawisza Enter, aby wyświetlić kolejny wykres.
par(mfrow = c(2, 2))
Code Wyjaśnienie
- (mfrow=c(2,2)): zwróć okno z czterema wykresami obok siebie.
- Pierwsze 2 dodają liczbę wierszy
- Drugie 2 dodaje liczbę kolumn.
- Jeśli napiszesz (mfrow=c(3,2)): utworzysz okno z 3 wierszami i 2 kolumnami
plot(fit)
Wyjście:

Formuła lm() zwraca listę zawierającą wiele przydatnych informacji. Dostęp do nich można uzyskać za pomocą utworzonego obiektu fit, a następnie znaku $ i informacji, które chcesz uzyskać.tract.
– współczynniki: `fit$współczynniki`
– reszty: `fit$residuals`
– dopasowana wartość: `fit$fitted.values`
Regresja czynników w R
W ostatnim oszacowaniu modelu regresję mpg przeprowadza się wyłącznie na zmiennych ciągłych. Dodanie zmiennych czynnikowych do modelu jest proste. Dodajesz zmienną am do swojego modelu. Ważne jest, aby upewnić się, że zmienna jest poziomem czynnika, a nie ciągła.
df <- mtcars %>%
    mutate(cyl = factor(cyl),
        vs = factor(vs),
        am = factor(am),
        gear = factor(gear),
        carb = factor(carb))
model <- mpg ~ .
summary(lm(model, df))
Wyjście:
##
## Call:
## lm(formula = model, data = df)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -3.5087 -1.3584 -0.0948  0.7745  4.6251
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 23.87913   20.06582   1.190   0.2525
## cyl6        -2.64870    3.04089  -0.871   0.3975
## cyl8        -0.33616    7.15954  -0.047   0.9632
## disp         0.03555    0.03190   1.114   0.2827
## hp          -0.07051    0.03943  -1.788   0.0939 .
## drat         1.18283    2.48348   0.476   0.6407
## wt          -4.52978    2.53875  -1.784   0.0946 .
## qsec         0.36784    0.93540   0.393   0.6997
## vs1          1.93085    2.87126   0.672   0.5115
## am1          1.21212    3.21355   0.377   0.7113
## gear4        1.11435    3.79952   0.293   0.7733
## gear5        2.52840    3.73636   0.677   0.5089
## carb2       -0.97935    2.31797  -0.423   0.6787
## carb3        2.99964    4.29355   0.699   0.4955
## carb4        1.09142    4.44962   0.245   0.8096
## carb6        4.47757    6.38406   0.701   0.4938
## carb8        7.25041    8.36057   0.867   0.3995
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.833 on 15 degrees of freedom
## Multiple R-squared:  0.8931, Adjusted R-squared:  0.779
## F-statistic:  7.83 on 16 and 15 DF,  p-value: 0.000124
R wykorzystuje pierwszy poziom czynnika jako grupę bazową. Należy porównać współczynniki drugiej grupy z grupą bazową.
Założenia regresji liniowej w R
Zwykła metoda najmniejszych kwadratów generuje wiarygodne współczynniki i wartości p tylko wtedy, gdy spełnione są pięć warunków. Cztery wykresy diagnostyczne wygenerowane przez plot(fit) istnieją właśnie po to, by je sprawdzić.
- Liniowość: Zależność między każdym predyktorem a y jest liniowa. Sprawdź Resztki a dopasowane wykres; widoczna krzywa oznacza, że potrzebna jest transformacja lub wyraz wielomianowy.
- Niezależność: Warunki błędu są nieskorelowane. Dane uporządkowane czasowo często naruszają tę zasadę, co można sprawdzić za pomocą funkcji durbinWatsonTest() z pakietu car.
- Homoskedastyczność: Wariancja błędu jest stała w przypadku wszystkich dopasowanych wartości. Kształt lejka w Skala-Lokalizacja fabuła sygnalizuje naruszenie.
- Normalność reszt: Błędy mają rozkład normalny. Punkty powinny znajdować się na przekątnej Normalny QQ wątek.
- Brak współliniowości: Predyktory nie są niemal identyczne. Współczynnik inflacji wariancji powyżej 5 to typowa linia ostrzegawcza.
library(car)
vif(fit)           # variance inflation factors
shapiro.test(residuals(fit))   # normality of residuals
Naruszenia nie zawsze unieważniają model, ale zmieniają poziom zaufania do wartości p, dlatego należy je sprawdzić przed zgłoszeniem jakiegokolwiek współczynnika.
Jak tworzyć prognozy za pomocą modelu regresji liniowej w R
Dopasowanie modelu to dopiero połowa zadania. Funkcja predict() stosuje dopasowane współczynniki do nowych obserwacji.
predict(object, newdata, interval = "none", level = 0.95)
arguments:
-object: The model returned by lm()
-newdata: A data frame whose columns match the predictors used in the formula
-interval: "none", "confidence" for the mean response, or "prediction" for a single new case
-level: The confidence level, 0.95 by default
Wykonaj te trzy kroki.
- Zbuduj ramkę danych nowych przypadków. Nazwy kolumn muszą dokładnie odpowiadać nazwom predyktorów we wzorze, a poziomy czynników muszą odpowiadać danym szkoleniowym.
- Wywołaj predict(). Przekaż dopasowany obiekt i nową ramkę danych.
- Dodaj interwał. Wybierz opcję „pewność”, jeśli chcesz poznać niepewność co do średniej odpowiedzi, lub opcję „przewidywanie”, jeśli chcesz poznać zasięg pojedynczego samochodu.
new_cars <- data.frame(wt = c(2.5, 3.2), hp = c(110, 175))
fit_final <- lm(mpg ~ wt + hp, data = mtcars)

predict(fit_final, newdata = new_cars)
predict(fit_final, newdata = new_cars, interval = "prediction")
Odczyt wyniku. Przewiduje się, że samochód ważący 2.5 tysiąca funtów (ok. 1100 kg) i o mocy 110 koni mechanicznych będzie miał zużycie paliwa na poziomie około 24.1 mpg. Przedział prognozy jest zawsze szerszy niż przedział ufności, ponieważ zawiera niepewność pojedynczej obserwacji nałożoną na niepewność dopasowanej linii.
Dwie zasady zapewniają uczciwość prognoz. Nigdy nie ekstrapoluj poza zakres predyktorów treningowych, ponieważ linia prosta nie ma żadnych dowodów. I zawsze dokonuj oceny na podstawie danych, których model nie widział, w przeciwnym razie raportowany błąd jest optymistyczny.
Regresja liniowa a regresja logistyczna w R
Analitycy często sięgają po lm(), gdy wynik nie jest ciągły. Poniższa tabela pokazuje, gdzie leży granica.
| kryteria | regresji liniowej | Regresja logistyczna |
|---|---|---|
| Zmienna odpowiedzi | Ciągły | Binarny lub kategoryczny |
| Przewidywany wynik | Dowolna liczba rzeczywista | Prawdopodobieństwo między 0 a 1 |
| Wyceny | Zwykłe najmniejsze kwadraty | Maksymalne prawdopodobieństwo |
| Dopasuj miarę | R-kwadrat, RMSE | AIC, odchylenie, dokładność |
| Funkcja R | lm(formuła, dane) | glm(formuła, dane, rodzina = „dwumianowy”) |
Jeżeli wynikiem jest decyzja „tak” lub „nie”, przejdź do uogólniony model liniowy zamiast forsować linię prostą przez zera i jedynki.
Regresja liniowa krok po kroku w R
Ostatnia część tego samouczka dotyczy regresja krokowa algorytm. Celem tego algorytmu jest dodawanie i usuwanie potencjalnych kandydatów w modelach oraz zachowanie tych, którzy mają istotny wpływ na zmienną zależną. Ten algorytm jest sensowny, gdy zbiór danych zawiera dużą listę predyktorów. Nie musisz ręcznie dodawać i usuwać zmiennych niezależnych. Regresja krokowa jest budowana w celu wybrania najlepszych kandydatów pasujących do modelu.
Zobaczmy w praktyce, jak to działa. Zbiór danych mtcars ze zmiennymi ciągłymi służy wyłącznie do ilustracji dydaktycznej. Przed rozpoczęciem analizy warto zbadać zależności w danych za pomocą macierzy korelacji. Biblioteka GGally jest rozszerzeniem ggplot2.
Biblioteka zawiera różne funkcje umożliwiające pokazanie statystyk podsumowujących, takich jak korelacja i rozkład wszystkich zmiennych w macierzy. Użyjemy funkcji ggscatmat, ale możesz odwołać się do winieta aby uzyskać więcej informacji na temat biblioteki GGally.
Podstawowa składnia ggscatmat() jest następująca:
ggscatmat(df, columns = 1:ncol(df), corMethod = "pearson")
arguments:
-df:  A matrix of continuous variables
-columns: Pick up the columns to use in the function. By default, all columns are used
-corMethod: Define the function to compute the correlation between variable. By default, the algorithm uses the Pearson formula
Wyświetlasz korelację wszystkich zmiennych i decydujesz, które z nich najlepiej nadają się do pierwszego kroku regresji krokowej. Istnieją silne korelacje między zmiennymi a zmienną zależną, mpg.
library(GGally)
df <- mtcars %>%
	select(-c(am, vs, cyl, gear, carb))
ggscatmat(df, columns = 1: ncol(df))
Wyjście:

Przykład regresji krok po kroku
Wybór zmiennych jest ważnym elementem dopasowania modelu, a regresja krokowa przeprowadza to wyszukiwanie automatycznie. Aby oszacować liczbę możliwych wyborów w zbiorze danych, należy obliczyć  gdzie k jest liczbą predyktorów. Ilość możliwości rośnie wraz z liczbą zmiennych niezależnych. Dlatego musisz mieć automatyczne wyszukiwanie.
Musisz zainstalować pakiet olsrr z CRAN. Pakiet nie jest jeszcze dostępny w Anacondzie. Dlatego instalujesz go bezpośrednio z wiersza poleceń:
install.packages("olsrr")
Możesz wykreślić wszystkie podzbiory możliwości za pomocą kryteriów dopasowania (tj. R-kwadrat, skorygowany R-kwadrat, kryteria Bayesa). Model o najniższych kryteriach AIC będzie modelem ostatecznym.
library(olsrr)
model <- mpg~.
fit <- lm(model, df)
test <- ols_all_subset(fit)
plot(test)
Code Wyjaśnienie
- mpg ~.: Skonstruuj model do oszacowania
- lm(model, df): Uruchom model OLS
- ols_all_subset(dopasowanie): Stwórz wykresy z odpowiednimi informacjami statystycznymi
- fabuła (test): Narysuj wykresy
Wyjście:

Modele regresji liniowej wykorzystują test t Aby oszacować statystyczny wpływ zmiennej niezależnej na zmienną zależną. Naukowcy zazwyczaj ustalają maksymalny próg na 10 procent, a niższe wartości p wskazują na silniejsze powiązanie statystyczne. Regresja krokowa jest oparta na tym teście, aby dodawać i usuwać potencjalne predyktory. Algorytm działa w następujący sposób:

- Krok 1: Regresuj każdy predyktor na y oddzielnie. Mianowicie dokonaj regresji x_1 na y, x_2 na y do x_n. Przechowuj Wartość p i utrzymuj regresor z wartością p niższą niż zdefiniowany próg (domyślnie 0.1). Predyktory o istotności mniejszej niż próg zostaną dodane do ostatecznego modelu. Jeśli żadna zmienna nie ma wartości p niższej niż próg wejściowy, algorytm zatrzymuje się i otrzymujesz ostateczny model tylko ze stałą.
- Krok 2: Użyj predyktora z najniższą wartością p i dodaj osobno jedną zmienną. Regresujesz stałą, najlepszy predyktor kroku pierwszego i trzecią zmienną. Dodajesz do modelu krokowego nowe predyktory o wartości niższej niż próg wejściowy. Jeśli żadna zmienna nie ma wartości p niższej niż 0.1, algorytm się zatrzymuje, a Ty masz swój ostateczny model z tylko jednym predyktorem. Regresujesz model krokowy, aby sprawdzić istotność najlepszych predyktorów kroku 1. Jeśli jest wyższa niż próg usuwania, zachowujesz ją w modelu krokowym. W przeciwnym razie ją wykluczasz.
- Krok 3: Powtarzasz krok 2 na nowym najlepszym modelu krokowym. Algorytm dodaje predyktory do modelu krokowego na podstawie wprowadzanych wartości i wyklucza predyktor z modelu krokowego, jeśli nie spełnia on progu wykluczającego.
- Algorytm jest kontynuowany, dopóki nie będzie można dodać ani wykluczyć żadnej zmiennej.
Algorytm można wykonać za pomocą funkcji ols_stepwise() z pakietu olsrr.
ols_stepwise(fit, pent = 0.1, prem = 0.3, details = FALSE)

arguments:
-fit:  Model to fit. Need to use `lm()`before to run `ols_stepwise()
-pent: Threshold of the p-value used to enter a variable into the stepwise model. By default, 0.1
-prem: Threshold of the p-value used to exclude a variable into the stepwise model. By default, 0.3
-details: Print the details of each step
⚠️ Uwaga dotycząca opakowania: W najnowszych wersjach olsrr zmieniono nazwy tych funkcji. Użyj ols_step_all_possible() zamiast ols_all_subset() i ols_step_both_p() Zamiast ols_stepwise(). Argumenty i dane wyjściowe pozostają niezmienione.
Wcześniej pokażemy Ci kroki algorytmu. Poniżej znajduje się tabela ze zmiennymi zależnymi i niezależnymi:
| Zmienna zależna | Zmienne niezależne |
|---|---|
| mpg | dysp |
| hp | |
| szczur | |
| wt | |
| sek |
Rozpocznij
Na początek algorytm rozpoczyna się od uruchomienia modelu dla każdej zmiennej niezależnej z osobna. Tabela pokazuje wartość p dla każdego modelu.
## [[1]]
##  (Intercept)         disp
## 3.576586e-21 9.380327e-10
##
## [[2]]
##  (Intercept)           hp
## 6.642736e-18 1.787835e-07
##
## [[3]]
##  (Intercept)         drat
## 0.1796390847 0.0000177624
##
## [[4]]
##  (Intercept)           wt
## 8.241799e-19 1.293959e-10
##
## [[5]
## (Intercept)        qsec
##  0.61385436  0.01708199
Aby wejść do modelu, algorytm zachowuje zmienną o najniższej wartości p. Z powyższego wyniku wynika, że wag
Krok 1
W pierwszym kroku algorytm uruchamia mpg niezależnie na wt i pozostałych zmiennych.
## [[1]]
##  (Intercept)           wt         disp
## 4.910746e-16 7.430725e-03 6.361981e-02
##
## [[2]]
##  (Intercept)           wt           hp
## 2.565459e-20 1.119647e-06 1.451229e-03
##
## [[3]]
##  (Intercept)           wt         drat
## 2.737824e-04 1.589075e-06 3.308544e-01
##
## [[4]]
##  (Intercept)           wt         qsec
## 7.650466e-04 2.518948e-11 1.499883e-03
Każda zmienna jest potencjalnym kandydatem do wejścia do modelu finalnego. Jednak algorytm zachowuje tylko zmienną o niższej wartości p. Okazuje się, że hp ma nieco niższą wartość p niż qsec, więc hp wchodzi do modelu finalnego.
Krok 2
Algorytm powtarza pierwszy krok, ale tym razem z dwiema niezależnymi zmiennymi w ostatecznym modelu.
## [[1]]
##  (Intercept)           wt           hp         disp
## 1.161936e-16 1.330991e-03 1.097103e-02 9.285070e-01
##
## [[2]]
##  (Intercept)           wt           hp         drat
## 5.133678e-05 3.642961e-04 1.178415e-03 1.987554e-01
##
## [[3]]
##  (Intercept)           wt           hp         qsec
## 2.784556e-03 3.217222e-06 2.441762e-01 2.546284e-01
Żaden z pozostałych kandydatów nie ma wartości p poniżej progu wejścia. Algorytm zatrzymuje się w tym miejscu, a oto ostateczny model:
##
## Call:
## lm(formula = mpg ~ wt + hp, data = df)
##
## Residuals:
##    Min     1Q Median     3Q    Max
## -3.941 -1.600 -0.182  1.050  5.854
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 37.22727    1.59879  23.285  < 2e-16 ***
## wt          -3.87783    0.63273  -6.129 1.12e-06 ***
## hp          -0.03177    0.00903  -3.519  0.00145 **
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.593 on 29 degrees of freedom
## Multiple R-squared:  0.8268, Adjusted R-squared:  0.8148
## F-statistic: 69.21 on 2 and 29 DF,  p-value: 9.109e-12
Aby porównać wyniki, możesz użyć funkcji ols_stepwise().
stp_s <-ols_stepwise(fit, details=TRUE)
Wyjście:
Algorytm znajduje rozwiązanie po wykonaniu dwóch kroków i zwraca takie same dane wyjściowe, jak w przypadku ręcznego przejścia opisanego powyżej.
Ostateczny model jest zatem objaśniany przez dwa predyktory i punkt przecięcia: liczba mil na galon jest negatywnie skorelowana zarówno z mocą brutto, jak i masą.
## You are selecting variables based on p value...
## 1 variable(s) added....
## Variable Selection Procedure
##  Dependent Variable: mpg
##
##  Stepwise Selection: Step 1
##
##  Variable wt Entered
##
##                         Model Summary
## --------------------------------------------------------------
## R                       0.868       RMSE                3.046
## R-Squared               0.753       Coef. Var          15.161
## Adj. R-Squared          0.745       MSE                 9.277
## Pred R-Squared          0.709       MAE                 2.341
## --------------------------------------------------------------
##  RMSE: Root Mean Square Error
##  MSE: Mean Square Error
##  MAE: Mean Absolute Error
##		ANOVA
## --------------------------------------------------------------------
##                 Sum of
##                Squares        DF    Mean Square      F         Sig.
## --------------------------------------------------------------------
## Regression     847.725         1        847.725    91.375    0.0000
## Residual       278.322        30          9.277
## Total         1126.047        31
## --------------------------------------------------------------------
##
##                                   Parameter Estimates
## ----------------------------------------------------------------------------------------
##       model      Beta    Std. Error    Std. Beta      t        Sig      lower     upper
## ----------------------------------------------------------------------------------------
## (Intercept)    37.285         1.878                 19.858    0.000    33.450    41.120
##          wt    -5.344         0.559       -0.868    -9.559    0.000    -6.486    -4.203
## ----------------------------------------------------------------------------------------
## 1 variable(s) added...
## Stepwise Selection: Step 2
##
##  Variable hp Entered
##
##                         Model Summary
## --------------------------------------------------------------
## R                       0.909       RMSE                2.593
## R-Squared               0.827       Coef. Var          12.909
## Adj. R-Squared          0.815       MSE                 6.726
## Pred R-Squared          0.781       MAE                 1.901
## --------------------------------------------------------------
##  RMSE: Root Mean Square Error
##  MSE: Mean Square Error
##  MAE: Mean Absolute Error
##			ANOVA
## --------------------------------------------------------------------
##                 Sum of
##                Squares        DF    Mean Square      F         Sig.
## --------------------------------------------------------------------
## Regression     930.999         2        465.500    69.211    0.0000
## Residual       195.048        29          6.726
## Total         1126.047        31
## --------------------------------------------------------------------
##
##                                   Parameter Estimates
## ----------------------------------------------------------------------------------------
##       model      Beta    Std. Error    Std. Beta      t        Sig      lower     upper
## ----------------------------------------------------------------------------------------
## (Intercept)    37.227         1.599                 23.285    0.000    33.957    40.497
##          wt    -3.878         0.633       -0.630    -6.129    0.000    -5.172    -2.584
##          hp    -0.032         0.009       -0.361    -3.519    0.001    -0.050    -0.013
## ----------------------------------------------------------------------------------------
## No more variables to be added or removed.
Regresja liniowa w R: najważniejsze wnioski i odniesienie do funkcji
- Regresja liniowa odpowiada na proste pytanie: czy można zmierzyć dokładną zależność między jedną zmienną docelową i zbiorem predyktorów?
- Metoda najmniejszych kwadratów zwykłych znajduje parametry, które minimalizują sumę kwadratów błędów, czyli pionową odległość między przewidywanymi wartościami y i rzeczywistymi wartościami y.
- Model probabilistyczny, który zawiera więcej niż jedną zmienną niezależną, nazywany jest modelem regresji wielokrotnej.
- Celem algorytmu regresji liniowej krok po kroku jest dodawanie i usuwanie potencjalnych kandydatów w modelach oraz pozostawianie tych, którzy mają istotny wpływ na zmienną zależną.
- Wybór zmiennych stanowi istotną część dopasowywania modelu, a regresja krokowa umożliwia automatyczne przeprowadzenie tego wyszukiwania.
Poniżej znajduje się lista wszystkich funkcji użytych w tym samouczku:
| Biblioteka | Cel | Funkcjonować | Argumenty |
|---|---|---|---|
| baza | Oblicz regresję liniową | lm() | formuła, dane |
| baza | Podsumuj model | streszczenie() | dopasować |
| baza | Extracwspółczynniki t | lm()$współczynnik | |
| baza | Extract reszty | lm()$reszty | |
| baza | Extracwartość dopasowana t | lm()$dopasowane.wartości | |
| olsrr | Uruchom regresję krokową | ols_stepwise() | pasuje, pent = 0.1, premia = 0.3, szczegóły = FAŁSZ |
Note:Pamiętaj, aby przed dopasowaniem modelu przekształcić zmienne kategoryczne w czynniki.
