
Co to jest testowanie oparte na modelu?
 Zespół redakcyjny
⚡ Inteligentne podsumowanie
Testowanie oparte na modelach sprawdza zachowanie oprogramowania w czasie wykonywania w porównaniu z przewidywaniami tworzonymi przez model abs.tracModel systemu, generujący przypadki testowe automatycznie z skończonych maszyn stanów, diagramów stanów lub notacji UML, a nie ręcznie.
Co to jest testowanie oparte na modelu?
Testowanie oparte na modelu To technika testowania oprogramowania, w której zachowanie testowanego oprogramowania w czasie wykonywania jest sprawdzane pod kątem przewidywań modelu. Model to opis zachowania systemu, wyrażony za pomocą sekwencji wejściowych, akcji, warunków, danych wyjściowych oraz przepływu danych od wejścia do wyjścia. Użyteczny model musi być zrozumiały w praktyce, wielokrotnego użytku i możliwy do udostępniania, a także musi precyzyjnie opisywać testowany system.
Dostępnych jest wiele modeli, a każdy z nich opisuje inny aspekt zachowania systemu. Typowe przykłady to:
- Przepływ danych
- Kontrola przepływu
- Wykresy zależności
- Tabele decyzyjne
- Maszyny przejścia stanów
Testowanie oparte na modelu opisuje zachowanie systemu w odpowiedzi na działanie określone przez model. Podaj działanie, a następnie sprawdź, czy system reaguje zgodnie z przewidywaniami modelu. Wszelkie rozbieżności między nimi są albo defektem oprogramowania, albo błędem modelu i warto znaleźć oba.
To lekka, formalna metoda walidacji systemu, która równie dobrze sprawdza się w testowaniu sprzętu, jak i oprogramowania. Ponieważ testy opierają się na specyfikacji zachowania, a nie na kodzie, technika ta jest… testy czarnej skrzynki Rodzina techniki testowania oprogramowania.
Przykład testowania opartego na modelu
Najprostszym sposobem na odczytanie modelu behawioralnego jest prześledzenie go od początku do końca. Poniższy diagram przedstawia proste zadanie edycji tekstu, gdzie każde pole reprezentuje stan, w jakim może znajdować się aplikacja, a każda strzałka reprezentuje akcję, którą może wykonać użytkownik.

Model wyjaśnia uproszczone podejście do pisania wierszy w Notatniku i możliwe działania związane z każdym krokiem. Dla każdej czynności, takiej jak uruchomienie aplikacji, wpisanie wiersza lub zapisanie pliku, walizka testowa Można wygenerować i zweryfikować wynik. Przejście przez ten sam diagram inną ścieżką, na przykład rozpoczynanie i zamykanie bez zapisywania, generuje inny przypadek testowy bez dodatkowych kosztów projektowych, co stanowi ekonomiczny argument przemawiający za całą techniką.
Rodzaje MBT
Istnieją dwa typy ram testowania opartego na modelach, a różnica między nimi polega po prostu na tym, kiedy generowane są kroki testowe:
- Offline / a priori: Generowanie zestawów testów przed ich wykonaniem. Zestaw testów to zbiór przypadków testowych, a w tym trybie zestaw jest przechowywany, sprawdzany i ponownie uruchamiany jak każdy inny. testowanie automatyzacji kapitał.
- Online / na bieżąco: Generowanie zestawów testów w trakcie wykonywania testów, gdzie następny krok jest wybierany na podstawie tego, jak system faktycznie zareagował na poprzedni krok.
Generowanie offline jest odpowiednie dla środowisk regulowanych, które wymagają weryfikowalnego i powtarzalnego zestawu. Generowanie online jest odpowiednie dla długotrwałych sesji eksploracyjnych w systemach stanowych, ponieważ generator może reagować na rzeczywistą odpowiedź, a nie na przewidywaną.
Jak działa testowanie oparte na modelach
Niezależnie od użytego frameworka, technika przebiega według tych samych pięciu etapów. Każdy etap generuje artefakt, który jest następnie przetwarzany w kolejnym etapie, dlatego to model, a nie skrypt testowy, staje się elementem, który zespół utrzymuje.
- Krok 1: Zbuduj model. Przetłumacz wymagania lub specyfikację na język ABStracModel oczekiwanego zachowania, definiujący stany, przejścia między nimi oraz dane wejściowe wyzwalające każde przejście.
- Krok 2: Wybierz kryteria doboru testu. Kryteria wskazują generatorowi moment zatrzymania. Najczęściej spotykane to pokrycie wszystkich stanów, które obejmuje każdy stan co najmniej raz; pokrycie wszystkich przejść, które obejmuje każdą strzałkę co najmniej raz; oraz pokrycie ścieżek lub przepływów danych w celu głębszej eksploracji.
- Krok 3: Generuj mięśnie brzuchatracprzypadki testowe t. Narzędzie porusza się po modelu i emituje sekwencje abstrackroki spełniające wybrane kryteria, wraz z oczekiwanym wynikiem każdego kroku.
- Krok 4: Utwardzanie mięśni brzuchatractesty t. Warstwa adaptera mapuje każdy abstracnie można podjąć się rzeczywistej akcji przeciwko systemowi, takiej jak interakcja z interfejsem użytkownika, API połączenie lub wiadomość protokołu. Ta mapaping jest zapisywany raz i wykorzystywany ponownie w każdym generowanym teście.
- Krok 5: Wykonanie i wydanie werdyktu. Konkretne testy przeprowadza się na systemie poddawanym testowi, każdą zaobserwowaną odpowiedź porównuje się z przewidywaniami modelu, a następnie rejestruje się werdykt o zaliczeniu lub niezaliczeniu testu. tracz powrotem do elementu modelu, który go wytworzył.
tracZdolność stworzona w kroku 5 to praktyczny zysk. Gdy wymaganie ulega zmianie, model ulega zmianie, a testy, których to dotyczy, są generowane ponownie, a nie przepisywane, dlatego zespoły często testy regresji w stosunku do stabilnej specyfikacji korzyść jest największa.
Różne modele w testowaniu
Aby zrozumieć MBT, konieczne jest zrozumienie niektórych modeli opisanych poniżej. Każdy z nich opiera się na wymianie siły ekspresji na wysiłek, więc wybór zależy od stopnia skomplikowania testowanego zachowania.
Maszyny skończone
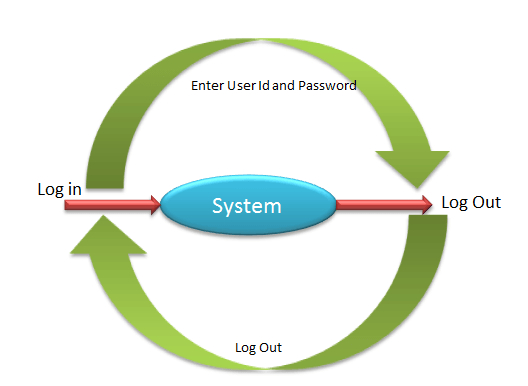
Model ten pomaga testerom ocenić wynik w zależności od wybranego sygnału wejściowego. Różne kombinacje sygnałów wejściowych mogą skutkować odpowiadającym im stanem systemu.
System będzie miał określony stan i stan aktualny, które będą ustalane na podstawie zestawu danych wejściowych podanych przez testerów.
Rozważ poniższy przykład. System umożliwia pracownikom logowanie się do aplikacji. Aktualny stan pracownika to „Niedostępny”, a po zalogowaniu się do systemu zmienia się na „Zalogowany”. W stanie „Zalogowany” pracownik może przeglądać, drukować i skanować dokumenty w systemie.
Automat stanowy dla tego przykładu pokazano tutaj, przy czym każda strzałka jest oznaczona przez wejście powodujące przejście.
Wykresy stanu
Diagram stanów jest rozszerzeniem skończonej maszyny stanów i może być stosowany w złożonych systemach czasu rzeczywistego. Diagramy stanów opisują różne zachowania systemu, mają określoną liczbę stanów, a zachowanie systemu jest analizowane i reprezentowane w postaci zdarzeń dla każdego stanu. Rozszerzeniem, które ma znaczenie w praktyce, jest hierarchia: diagram stanów umożliwia zagnieżdżanie i tworzenie stanów równoległych, dzięki czemu maszyna, która potrzebowałaby kilkudziesięciu stanów płaskich, może zostać narysowana w sposób zwarty.
Na przykład defekty są zgłaszane w narzędziu do zarządzania defektami ze statusem „Nowy”. Po naprawieniu defektu przez programistów, status musi zostać zmieniony na „Naprawiony”. Jeśli defekt nie zostanie naprawiony, status zmienia się na „Otwarty ponownie”. Diagramy stanów powinny być zaprojektowane tak, aby dla każdego stanu wywoływane było zdarzenie.
Cykl życia defektu przedstawiono poniżej, przy czym każdy status pokazano jako stan, a każda czynność przepływu pracy jako zdarzenie, które przenosi defekt między nimi.

Ujednolicony język modelowania (UML)
Ujednolicony język modelowania (UML) UML to znormalizowany język modelowania ogólnego przeznaczenia. Zawiera zestaw technik notacji graficznej służących do tworzenia modeli wizualnych, które mogą opisywać bardzo złożone zachowania systemów.
UML ma takie notacje jak:
- Aktywności
- Aktorzy
- Proces biznesowy
- Komponenty
- Język programowania
Diagramy aktywności i maszyn stanów to diagramy najczęściej czytane przez generatorów testów, co ilustruje przykładowy model UML podany poniżej.

Narzędzia do testowania opartego na modelach
Model na papierze sam w sobie niczego nie generuje. Do poruszania się po modelu i generowania ścieżek testowych potrzebny jest generator, a rynek narzędzi dzieli się na generatory open source i komercyjne platformy do testowania i projektowania.
- GraphWalker — narzędzie typu open source, które odczytuje modele w kształcie grafów skierowanych i generuje na ich podstawie ścieżki testowe, z możliwością wyboru generatorów i warunków zatrzymania.
- fMBT — zestaw narzędzi do testowania opartych na modelach typu open source od firmy Intel, który obsługuje generowanie i wykonywanie testów na podstawie modeli stanów.
- Konformiq — komercyjny produkt do automatycznego projektowania testów, który tworzy przypadki testowe i skrypty na podstawie graficznych modeli zachowań.
- MaTeLo i MBTsuite — platformy komercyjne przeznaczone do statystycznych modeli użytkowania i generowania testów w istniejących ramach automatyzacji.
- Eksplorator specyfikacji Do MicrosoftRozszerzenie testowania opartego na modelu dla programu Visual Studio, często cytowane w literaturze poświęconej testowaniu protokołów.
Wybór zależy mniej od listy funkcji, a bardziej od dwóch pytań: jaką notację zespół może faktycznie narysować oraz czy narzędzie może emitować testy do już używanego frameworka automatyzacji. Generator, który generuje pakiety, których nikt nie może wykonać, dodaje krok do procesu, zamiast go usuwać.
Testowanie oparte na modelach a tradycyjne projektowanie testów
Warto podkreślić kontrast z testami pisanymi ręcznie, ponieważ oba podejścia zawodzą w różnych miejscach, a nie tylko dlatego, że jedno z nich jest lepsze.
| WYGLĄD | Testowanie oparte na modelu | Tradycyjny projekt testów |
|---|---|---|
| Źródło przypadków testowych | Wygenerowano automatycznie z modelu behawioralnego | Napisane indywidualnie przez testera na podstawie wymagań |
| Skutek zmiany wymogu | Zaktualizuj model, zregeneruj dotknięte testy | Znajdź i edytuj ręcznie każdy przypadek testowy, którego to dotyczy |
| Pokrycie | Pomiar według kryteriów modelu, takich jak wszystkie stany lub wszystkie przejścia | Zmierzone w stosunku do wymagań i zależne od osądu testera |
| Koszt z góry | Wysokie: umiejętność modelowania, konfiguracja narzędzi i warstwa adaptera | Niski: tester może zacząć pisać natychmiast |
| Najlepsze dopasowanie | Systemy stanowe o długim okresie istnienia i stabilnej specyfikacji | Krótkie projekty, pojedyncze produkcje i prace eksploracyjne |
| Główny tryb awarii | Błędny lub nieaktualny model po cichu generuje błędne testy | Luki i duplikaty kumulują się w dużym pakiecie |
Opisana poniżej ewolucja przedstawia tę technikę w odpowiednim kontekście: ręczne wykonywanie testów ustąpiło miejsca wykonywaniu automatycznemu, a podejścia oparte na modelach przenoszą automatyzację o jeden poziom wcześniej, do samego projektowania testów.

Wyzwania związane z testowaniem opartym na modelu
Wdrożenie MBT w organizacji wymaga znacznych nakładów finansowych i wysiłku. Poniżej przedstawiono wady MBT w Inżynieria oprogramowania:
- Testerzy muszą posiadać umiejętności modelowania, których tradycyjne projektowanie testów nie wymaga.
- Proces uczenia się jest długi, a koszty pierwszego projektu zwykle przekraczają oszczędności.
- Sam model może być trudny do zrozumienia i oceny, zwłaszcza gdy już się rozrośnie.
- Model, który odbiega od specyfikacji, skutkuje błędnymi, ale pewnymi wynikami testów.
- Warstwa adaptera, która obraca abstracWszystkie kroki prowadzące do rzeczywistych działań muszą być spisane i utrzymywane oddzielnie.
- Rozmiar modelu rośnie szybko, więc nieograniczony model stanu może wygenerować więcej ścieżek, niż jakikolwiek zespół jest w stanie wykonać.
Żaden z nich nie jest powodem, aby unikać tej techniki, ale razem wyjaśniają, dlaczego MBT jest zwykle wprowadzany najpierw w jednym stabilnym podsystemie, a nie w całym cykl życia testowania oprogramowania natychmiast.
Zalety testowania opartego na modelach
W zestawieniu z tymi kosztami korzyści płynące z MBT są następujące:
- Łatwa konserwacja przypadków testowych i zestawów testowych, ponieważ edytuje się model, a nie poszczególne testy.
- Obniżenie kosztów w trakcie trwania długoterminowego projektu.
- Lepsze pokrycie testu, ponieważ generator bada ścieżki, które użytkownik by pominął.
- Różne wygenerowane pakiety mogą działać równolegle na dowolnej liczbie maszyn.
- Wczesne wykrywanie błędów, ponieważ niejasności ujawniają się już w trakcie tworzenia modelu, jeszcze przed wykonaniem kodu.
- Wzrost liczby defektów wykrytych przy takim samym wysiłku testowym.
- Oszczędność czasu przy projektowaniu testów po opracowaniu modelu i adaptera.
- Większa satysfakcja testerów z pracy, ponieważ ich wysiłek przesunął się od powtarzalnego pisania skryptów do modelowania i analizy.
Testerzy i tak konstruują modele mentalne w trakcie pracy, a MBT po prostu przenosi te modele mentalne na papier, gdzie można je przeglądać, wersjonować i ponownie wykorzystywać. W jaki sposób ta technika wpisuje się w inne dostępne podejścia, opisano w rodzaje testowania oprogramowania.
