
Selektor CSS w Selenium
 Krishna Szczebel
⚡ Inteligentne podsumowanie
Selektor CSS w Selenium to potężna strategia lokalizatora, która identyfikuje elementy za pomocą znaczników HTML, identyfikatorów, klas, atrybutów i wzorców tekstu wewnętrznego. Ten zasób wyjaśnia każdy typ selektora CSS wraz z przykładami krok po kroku. Selenium SDI.
Czym jest selektor CSS w Selenium?
A Selektor CSS w Selenium to wzorzec ciągu znaków, który identyfikuje element sieciowy poprzez kombinację znacznika HTML, identyfikatora, klasy i atrybutów. Selektory CSS są nieco bardziej zaawansowane niż wyszukiwanie po identyfikatorze lub nazwie, ale są najpopularniejszą strategią wśród doświadczonych Selenium użytkownicy, ponieważ mogą dotrzeć do elementów, które nie mają żadnego atrybutu ID ani nazwy.
Selektory CSS w Selenium występują w wielu formach, ale ten przewodnik skupia się na pięciu najczęściej stosowanych wzorcach Selenium SDI:
- Etykieta i identyfikator
- Etykieta i klasa
- Etykieta i atrybut
- Tag, klasa i atrybut
- Tekst wewnętrzny
Podczas stosowania tej strategii w Selenium IDE, zawsze dodawaj prefiks Target pudełko z „css=„jak pokazano w każdym przykładzie poniżej.
Dlaczego warto używać selektorów CSS w Selenium?
Selektory CSS są preferowaną strategią lokalizacyjną dla wielu Selenium inżynierowie automatyki, ponieważ zapewniają równowagę między szybkością, elastycznością i czytelnością. Nowoczesne aplikacje internetowe często używają dynamicznie generowanych identyfikatorów lub całkowicie eliminują atrybuty nazw, pozostawiając selektory CSS jako jedyny niezawodny sposób na dotarcie do konkretnego elementu na stronie.
Główne zalety stosowania selektorów CSS obejmują:
- Wydajność: Selektory CSS są przetwarzane przez natywny silnik przeglądarki, dzięki czemu działają szybciej niż równoważne wyrażenia XPath, zwłaszcza w starszych przeglądarkach, takich jak Internet Explorer.
- Elastyczność: Łączą one w sobie logikę tagów, klas, atrybutów i częściowego dopasowania, umożliwiając testerom wybieranie elementów, którym brakuje stabilnego identyfikatora.
- Czytelność: Składnia odzwierciedla sposób, w jaki programiści piszą już reguły CSS, co skraca czas nauki zarówno dla inżynierów ds. zapewnienia jakości, jak i zespołów front-end.
- Stabilność między przeglądarkami: Selektory CSS zachowują się spójnie w całej przeglądarce Chrome, Firefox, Edge i Safari, redukując ryzyko wystąpienia niepewnych błędów podczas testów.
Tag i ID – Selektor CSS
W tym przykładzie użyto pola tekstowego „E-mail” na stronie logowania na Facebooku. Element ma identyfikator „E-mail„, a dostęp do niego był już możliwy w sekcji „Lokalizacja według ID”. Teraz ten sam element jest docelowy za pomocą Selenium Selektor CSS z atrybutem ID.
Składnia
css=tag#id
- tag = znacznik HTML elementu, do którego uzyskiwany jest dostęp
- # = znak hash, który zawsze musi być obecny podczas używania Selenium Selektor CSS z identyfikatorem
- id = identyfikator elementu, do którego uzyskiwany jest dostęp
Należy pamiętać, że identyfikator jest zawsze poprzedzony znakiem hash (#).
Krok 1) Nawigować do www.facebook.comKorzystając z narzędzi deweloperskich przeglądarki (lub starszego narzędzia, takiego jak Firebug), sprawdź pole tekstowe „E-mail lub telefon”.
Zwróć uwagę, że znacznik HTML to „wkład„a jego ID to „E-mail„Kompletny Selektor CSS staje się zatem „css=wejście#e-mail".

Krok 2) Wchodzić "css=wejście#e-mail”Do Target pudełko z Selenium IDE i kliknij przycisk Znajdź. Selenium IDE podświetla pasujący element na stronie.

Tag i klasa – selektor CSS
Selektor CSS w Selenium który używa znacznika HTML i nazwy klasy, działa w oparciu o tę samą ideę co znacznik i ID, ale kropka (.) zastępuje znak hash.
Składnia
css=tag.class
- tag = znacznik HTML elementu, do którego uzyskiwany jest dostęp
- . = znak kropki, który zawsze musi być obecny podczas używania selektora CSS z klasą
- class = klasa elementu, do którego uzyskuje się dostęp
Krok 1) Otwórz stronę demonstracyjną https://demo.guru99.com/test/facebook.html i sprawdź pole tekstowe „E-mail lub telefon”. Zwróć uwagę, że znacznik HTML to „wkład„a jego klasa to „tekst wejściowy".

Krok 2) In Selenium IDE, wpisz „css=wejście.tekst wejściowy"W Target pole i kliknij Znajdź. Selenium IDE rozpoznaje pola tekstowe E-mail i Telefon.
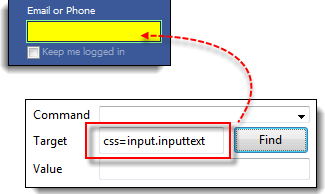
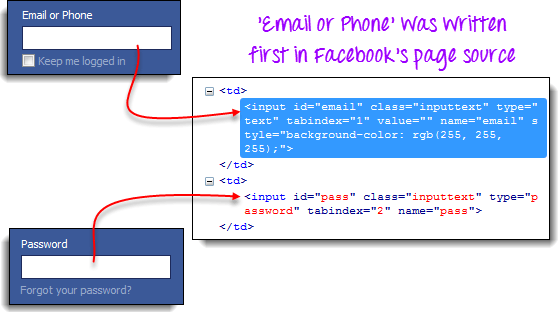
Należy pamiętać, że jeśli wiele elementów ma ten sam znacznik i klasę HTML, rozpoznawany jest tylko pierwszy pasujący element w kodzie źródłowym. Sprawdź pole tekstowe Hasło na tej samej stronie i zauważ, że jest ono tej samej klasy co pole tekstowe Adres e-mail lub Telefon.

Na poprzedniej ilustracji wyróżniono tylko pole tekstowe E-mail lub Telefon, ponieważ pojawia się ono jako pierwsze w kodzie źródłowym strony.
Tag i atrybut – selektor CSS
Strategia ta polega na połączeniu znacznika HTML ze specyficznym atrybutem elementu, do którego chcesz uzyskać dostęp.
Składnia
css=tag[attribute=value]
- tag = znacznik HTML elementu, do którego uzyskiwany jest dostęp
- [ i ] = nawiasy kwadratowe otaczające atrybut i odpowiadającą mu wartość
- atrybut = atrybut do użycia. Wybierz atrybut, który jest unikalny dla elementu, np. nazwa lub identyfikator.
- wartość = odpowiadająca wartość wybranego atrybutu.
Krok 1) Nawiguj do Mercury Strona rejestracji wycieczek https://demo.guru99.com/test/newtours/register.php i sprawdź pole tekstowe „Nazwisko”. Zwróć uwagę na jego znacznik HTML („input”) i atrybut „name” („lastName”).

Krok 2) In Selenium IDE, wpisz „css=input[imię=nazwisko]"W Target pole i kliknij Znajdź. Selenium IDE pomyślnie lokalizuje pole Nazwisko.

Jeśli wiele elementów ma ten sam znacznik HTML i atrybut, rozpoznawany jest tylko pierwszy z nich. To zachowanie jest identyczne, jak w przypadku lokalizowania elementów o tym samym znaczniku i klasie.
Tag, klasa i atrybut – selektor CSS
Składnia
css=tag.class[attribute=value]
- tag = znacznik HTML elementu, do którego uzyskiwany jest dostęp
- . = znak kropki, który zawsze musi być obecny podczas używania selektora CSS z klasą
- class = klasa elementu, do którego uzyskuje się dostęp
- [ i ] = nawiasy kwadratowe, które otaczają konkretny atrybut i odpowiadającą mu wartość
- atrybut = atrybut do użycia. Wybierz atrybut, który jest unikalny dla elementu, np. nazwa lub identyfikator.
- wartość = odpowiadająca wartość wybranego atrybutu.
Krok 1) Otwórz stronę demonstracyjną https://demo.guru99.com/test/facebook.html i sprawdź pola „E-mail lub telefon” i „Hasło”. Zwróć uwagę na ich znacznik HTML, klasę i atrybuty. W tym przykładzie użyto „indeks kart” atrybut.

Krok 2) Najpierw uzyskaj dostęp do pola tekstowego „E-mail lub telefon” używając wartości tabindex równej 1. Wprowadź „css=input.inputtext[tabindex=1]" w Selenium IDE Target i kliknij Znajdź. Pole Adres e-mail lub Telefon zostanie podświetlone.

Krok 3) Aby wybrać pole wprowadzania hasła, wystarczy zastąpić wartość tabindex. Wpisz „css=input.inputtext[tabindex=2]"W Target pole i kliknij Znajdź. Selenium IDE pomyślnie lokalizuje pole tekstowe Hasło.

Tekst wewnętrzny – selektor CSS
Etykiety HTML rzadko mają atrybuty id, name lub class. Jak więc uzyskać do nich dostęp w SeleniumOdpowiedź znajduje się w ich wewnętrznym tekście. Teksty wewnętrzne to faktyczne wzorce ciągów znaków, które etykieta HTML wyświetla na stronie.
Składnia
css=tag:contains("inner text")
- tag = znacznik HTML elementu, do którego uzyskiwany jest dostęp
- tekst wewnętrzny = widoczna zawartość tekstowa elementu
Krok 1) Nawiguj do Mercury Strona główna wycieczek https://demo.guru99.com/test/newtours/ i sprawdź etykietę „Hasło”. Zwróć uwagę na jej znacznik HTML (w tym przypadku „czcionka”) i sprawdź, czy element nie ma atrybutów „class”, „id” ani „name”.

Krok 2) Typ css=font:contains(“Hasło:”) najnowszych Selenium IDE Target pole i kliknij Znajdź. Selenium IDE lokalizuje etykietę hasła, jak pokazano poniżej.

Krok 3) Tym razem zastąp tekst wewnętrzny słowem „Boston”, aby Target staje się „css=font:contains(“Boston”)Kliknij „Znajdź”. Etykieta „Boston – San Francisco” jest podświetlona, co oznacza, że Selenium IDE potrafi zlokalizować długą etykietę, nawet gdy podane jest tylko pierwsze słowo jej wewnętrznego tekstu.

Selektor CSS kontra XPath w Selenium
Zarówno selektory CSS, jak i XPath służą do identyfikacji elementów sieciowych Selenium, ale mają różne mocne strony. Poniższa tabela porównuje dwie strategie lokalizacyjne pod kątem kluczowych wymiarów:
| kryteria | Selektor CSS | XPath |
|---|---|---|
| Prędkość | Szybciej, działa na natywnym silniku przeglądarki | Wolniej, zwłaszcza w starszych przeglądarkach |
| Kierunek | Tylko przekazywanie dalej (z rodzica do dziecka) | Do przodu i do tyłu (od dziecka do rodzica) |
| Składnia | Krótsze i podobne do reguł CSS | Dłuższe, hierarchiczne wyrażenia ścieżki |
| Dopasowanie tekstu | Ograniczone do pseudo-klasy :contains() | Funkcje Strong text() i contains() |
| Najlepszy dla | Statyczne układy i nowoczesne aplikacje internetowe | Złożone przemierzanie DOM i lokalizatory oparte na tekście |
Najlepsze praktyki pisania selektorów CSS w Selenium
Pisanie niezawodnych selektorów CSS to coś więcej niż tylko znajomość składni. Poniższe praktyki pomagają testerom tworzyć stabilne i łatwe w utrzymaniu Selenium skrypty, które przetrwają zmiany interfejsu użytkownika:
- Preferuj unikalne atrybuty: Zawsze wybieraj atrybuty id, data-test-id lub name, które są wyraźnie dodane do automatyzacji. Pozostają one stabilne nawet po zmianie układu wizualnego.
- Unikaj zbyt zagnieżdżonych selektorów: Długie łańcuchy, takie jak
div > div > ul > li > aŁatwo ulegają uszkodzeniu podczas refaktoryzacji kodu przez programistów. Selektory powinny być jak najkrótsze. - Używaj dopasowań częściowych mądrze: Wzory takie jak
[class*="btn-primary"]tolerują niewielkie zmiany nazw klas, ale mogą również pasować do niezamierzonych elementów. - Unikaj lokalizatorów opartych na indeksie: Selektorzy tacy jak
nth-child(3)są delikatne, ponieważ dodanie elementu rodzeństwa zmienia każdą pozycję. - Sprawdź poprawność selektorów w DevTools: Przed uruchomieniem Selenium skrypt, wklej selektor do konsoli Chrome DevTools za pomocą
document.querySelector()aby potwierdzić, że zwraca dokładnie jeden element. - Połącz atrybuty, aby uzyskać unikalność: Jeśli klasa jest współdzielona przez wiele elementów, dodaj filtr atrybutów, taki jak
input.form-control[name="email"]aby ujednoznacznić cel. - Dokumentowanie i ponowne wykorzystanie: Zcentralizuj selektory w obrębie klasy obiektu strony, tak aby pojedyncza aktualizacja naprawiała każdy test odwołujący się do tego samego elementu.
Przestrzeganie tych wytycznych zmniejsza niestabilność, poprawia szybkość wykonywania testów i ułatwia Selenium apartamenty są łatwiejsze w utrzymaniu w dłuższej perspektywie.
Podsumowanie: Krótki przewodnik po składni selektora CSS
Poniższa tabela konsoliduje wszystkie Selenium W tym przewodniku omówiono wzorzec selektora CSS:
| Metoda wykonania | Target Składnia | Przykład |
|---|---|---|
| Etykieta i identyfikator | css=tag#id | css=wejście#e-mail |
| Etykieta i klasa | css=tag.klasa | css=wejście.tekst wejściowy |
| Etykieta i atrybut | css=tag[atrybut=wartość] | css=input[imię=nazwisko] |
| Tag, klasa i atrybut | css=tag.class[atrybut=wartość] | css=input.inputtext[tabindex=1] |
| Tekst wewnętrzny | css=tag:contains(“tekst”) | css=font:contains(“Hasło:”) |
