
Jak zainstalować i skonfigurować HIVE Metastore z MYSQL
 Zespół redakcyjny
⚡ Inteligentne podsumowanie
Metamagazyn Hive przechowuje każdą definicję tabeli, nazwę kolumny i typ danych w środowisku Apache Hive, a przeniesienie tego repozytorium z domyślnej bazy danych Derby do MySQL pozwala na jednoczesne połączenie się wielu użytkowników.
Co to jest Metastore HIVE?
Hive metastore to repozytorium przechowujące metadane (nazwy kolumn, typy danych, komentarze itp.) związane z Ula Apache za pomocą MySQL or PostgreSQL. Ten magazyn metadanych Hive jest implementowany przy użyciu tabel w relacyjnej bazie danych.
Nic w metamagazynie nie przechowuje samych wierszy. Rekordy pozostają w systemie HDFS, a metamagazyn zapisuje jedynie lokalizację każdej tabeli i nazwy jej kolumn, dlatego jego utrata obciąża schemat, a nie dane.
Dlaczego używać MySQL w Hive jako Metastore
Zaplecze metastore jest kwestią wyboru, a nie stałym elementem Hive, a domyślne ustawienia są celowo minimalistyczne. Trzy ograniczenia odstraszają od niego niemal każdą instalację.
- Domyślnie Hive zawiera bazę danych Derby jako metamagazyn.
- Derby może obsługiwać tylko jednego aktywnego użytkownika w danym momencie.
- Derby nie jest zalecany do stosowania w środowisku produkcyjnym.
Rozwiązaniem jest więc tutaj
- Zastosowanie MySQL jako metadane w zapleczu, umożliwiające jednoczesne połączenie wielu użytkowników z Hive
- MySQL jest najlepszym wyborem dla samodzielnego metamagazynu
Jak zainstalować i skonfigurować Hive Metastore w MySQL Baza danych
Dziewięć poniższych kroków wykonuje się w podanej kolejności na komputerze z zainstalowanymi Hadoop i Hive. Każdy krok kończy się zrzutem ekranu z rzeczywistymi danymi z terminala lub powłoki.
Krok 1) Zainstaluj MySQL
Na tym etapie wykonamy dwa zadania
- Instalacja serwera MySQL
- Sprawdzanie serwera MySQL i jego procesów
Korzystanie z sudo apt-get install mysql-server polecenie, możemy pobrać MySQL serwer. Zainstaluj MySQL jak pokazano na zrzucie ekranu poniżej.

Po pomyślnej instalacji, MySQL będzie działać tak, jak pokazano na zrzucie ekranu poniżej, gdzie proces sprawdzania potwierdza, że usługa jest uruchomiona.

Krok 2) Zainstaluj MySQL Java Złącze
Instalowanie MySQL Java złącze. To jest dla Java zależności i cele połączeń, ponieważ Hive osiąga MySQL przez JDBC. Poniższy zrzut ekranu pokazuje instalację pakietu.

Krok 3) Utwórz miękkie łącze do złącza
Tworzenie miękkiego łącza dla konektora w katalogu biblioteki Hive. Jest to miękkie łącze między Java oraz MySQL, i to właśnie umieszcza plik JAR sterownika w ścieżce klas Hive. Polecenie i jego wynik znajdują się poniżej.

Krok 4) Konfiguracja MySQL przechowywanie w Hive
MySQL Przed utworzeniem jakiegokolwiek użytkownika Hive należy otworzyć powłokę na koncie root, jak pokazano poniżej.

- Wpisz mysql –u root –p, a następnie hasło
- Tutaj –u oznacza nazwę użytkownika root, a –p oznacza hasło
- Po wpisaniu powyższego polecenia użytkownik musi wpisać prawidłowe hasło i nacisnąć enter
- Następnie wejdzie do MySQL tryb powłoki
Krok 5) Utwórz nazwę użytkownika i hasło
Tworzenie nazwy użytkownika i hasła dla MySQLi przyznawanie uprawnień. Poniższy zrzut ekranu pokazuje trzy polecenia uruchomione w MySQL muszla.

Musimy wykonać polecenia, jak pokazano poniżej,
mysql> CREATE USER 'hiveuser'@'%' IDENTIFIED BY 'hivepassword';
mysql> GRANT all on *.* to 'hiveuser'@localhost identified by 'hivepassword';
mysql>  flush privileges;
On MySQL 8 Połączona forma drugiego polecenia nie jest już parsowana, ponieważ IDENTIFIED BY zostało usunięte z GRANT. Najpierw utwórz konto, a następnie nadaj mu uprawnienia, a następnie powtórz wiersz CREATE USER dla hosta lokalnego oraz dla hosta wieloznacznego.
Krok 6) Konfigurowanie pliku hive-site.xml
- Po kroku 5 przypisuje nazwę użytkownika i hasło MySQL bazę danych i przyznaje uprawnienia.
- Tutaj skonfigurujemy niektóre właściwości w Hive, aby uzyskać połączenie z MySQL Baza danych.
Plik konfiguracyjny otwierany jest z katalogu Hive conf, jak pokazano na kolejnym zrzucie ekranu.

Poniższy zrzut ekranu przedstawia ukończony plik ze wszystkimi czterema właściwościami.

Z powyższego zrzutu ekranu wynika, że definiujemy tutaj 4 właściwości niezbędne do utworzenia MySQL jako metamagazyn w Hive.
Są to:
- Ta nieruchomość jest przeznaczona do połączenia URLTutaj definiujemy połączenieURL w tej nieruchomości. Działa jako ciąg połączenia JDBC i reprezentuje również lokalizację metamagazynu.
- Ta właściwość określa nazwę sterownika połączenia. W tym przypadku com.mysql.jdbc.Driver to wartość, którą należy podać w znaczniku wartości.
- Ta właściwość służy do definiowania nazwy użytkownika połączenia. W tym przypadku zdefiniowaliśmy „hiveuser” jako nazwę użytkownika.
- Ta właściwość służy do podania hasła połączenia. W tym przypadku zdefiniowaliśmy „hivepassword” jako hasło użytkownika.
Po umieszczeniu właściwości w pliku hive-site.xml musimy ręcznie zapisać plik (Ctrl+S) i zamknąć go. Po zamknięciu pliku musimy utworzyć tabelę Hive i sprawdzić jej szczegóły w… MySQL przechowywanie.
Umieść ten kod w pliku hive-site.xml
Hive-site.xml
<configuration>
	<property>
		<name>javax.jdo.option.ConnectionURL</name>
		<value>jdbc:mysql://localhost/metastore?createDatabaseIfNotExist=true</value>
		<description>metadata is stored in a MySQL server</description>
	</property>
	<property>
		<name>javax.jdo.option.ConnectionDriverName</name>
		<value>com.mysql.jdbc.Driver</value>
		<description>MySQL JDBC driver class</description>
	</property>
	<property>
		<name>javax.jdo.option.ConnectionUserName</name>
		<value>hiveuser</value>
		<description>user name for connecting to mysql server</description>
	</property>
	<property>
		<name>javax.jdo.option.ConnectionPassword</name>
		<value>hivepassword</value>
		<description>password for connecting to mysql server</description>
	</property>
</configuration>
Dwie powyższe wartości zależą od używanej wersji złącza. MySQL Connector/J 8 zmienił nazwę klasy sterownika na com.mysql.cj.jdbc.Driver i oczekuje również jawnego ustawienia portu i protokołu SSL, więc nowoczesne URL Zwykle jest to jdbc:mysql://localhost:3306/metastore?createDatabaseIfNotExist=true&useSSL=false. Ponieważ hasło jest zapisane w postaci zwykłego tekstu, plik powinien być czytelny tylko dla konta usługi Hive.
Krok 7) Utwórz tabelę
Utwórz tabelę „guru99” w Hive, tak jak pokazano poniżej w powłoce Hive.

Na powyższym zrzucie ekranu możemy zaobserwować następujące rzeczy
- Utworzenie tabeli o nazwie „guru99” z dwiema nazwami kolumn
- Nazwy kolumn są wymienione wraz z ich typami danych, jeden jest liczbą całkowitą, a drugi ciągiem znaków
W następnym kroku sprawdzimy, czy jest on zapisany w MySQL lub nie.
Krok 8) Wejdź do MySQL tryb powłoki
Najpierw wybierana jest baza danych metastore, a następnie wyświetlana jest tabela.

Na powyższym zrzucie ekranu możemy zaobserwować następujące rzeczy
- Najpierw musimy wybrać bazę danych za pomocą opcji „użyj metastore”
- Po wybraniu metamagazynu możemy sprawdzić znajdujące się w nim tabele, korzystając z polecenia „show tables”, jak pokazano na zrzucie ekranu
- Bez względu na to, jakie tabele zostaną utworzone w Hive, metadane odpowiadające tym tabelom są przechowywane w TBLS w MySQL baza danych
- Tabela „guru99” jest tworzona w Hive, więc odpowiednie metadane są przechowywane w MySQL pod TBLS
Krok 9) Wprowadź wybierz * z TBLS
Sprawdzanie, czy utworzona tabela jest obecna w MySQL lub nie. Zapytanie i jego wynik są widoczne na poniższym zrzucie ekranu.
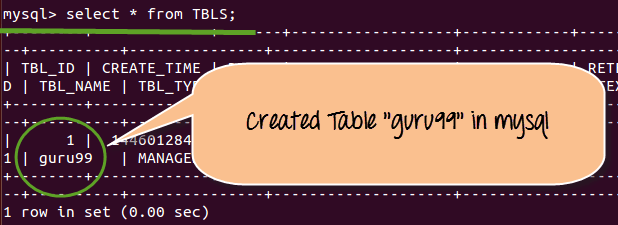
Wpisując wybierz * z TBLS, wyświetli tabele, które utworzyliśmy w trybie powłoki Hive
Na powyższym zrzucie ekranu możemy zaobserwować następujące rzeczy:
- Nazwę tabeli „guru99” utworzoną w Hive można wyświetlić w MySQL tryb powłoki
- Oprócz tego będzie również dostarczać informacji, takich jak czas utworzenia tabeli, czas dostępu i inne właściwości, jak pokazano na zrzucie ekranu powyżej
Jak zainicjować schemat metadanych Hive za pomocą schematool
Flaga createDatabaseIfNotExist w połączeniu URL Tworzy pustą bazę danych metamagazynu, ale nie tworzy około siedemdziesięciu tabel, których oczekuje Hive. W Hive 1.x i nowszych to zadanie należy do narzędzia schematool i pomijaping jest to najczęstsza przyczyna, dla której świeżo skonfigurowany metamagazyn odmawia uruchomienia.
$HIVE_HOME/bin/schematool -dbType mysql -initSchema
Polecenie odczytuje te same cztery właściwości z pliku hive-site.xml, łączy się z kontem hiveuser i uruchamia dołączony skrypt SQL, który odpowiada wersji Hive. Pomyślne uruchomienie kończy się komunikatem o zakończeniu, po którym stan można potwierdzić w dowolnym momencie.
$HIVE_HOME/bin/schematool -dbType mysql -info
Poniższe flagi obejmują cały cykl życia schematu metamagazynu.
| Option | Co to robi |
|---|---|
| -typ_bazy_danych | Nazwy zaplecza, takie jak mysql, derby, postgres, oracle lub mssql |
| -initSchema | Tworzy tabele metamagazynu dla bieżącej wersji Hive |
| -informacje | Raportuje wersję schematu zarejestrowaną w bazie danych |
| -upgradeSchema | Migruje istniejący schemat po aktualizacji Hive |
| -uprawomocnić | Sprawdza schemat pod kątem brakujących tabel i niezgodności wersji |
Warto poznać jedną powiązaną właściwość przed pierwszym uruchomieniem. Gdy hive.metastore.schema.verification ma wartość true, Hive porównuje wersję schematu w MySQL przeciwko sobie i odmawia uruchomienia w przypadku niezgodności. To sprawdzenie jest zabezpieczeniem, więc prawidłową reakcją jest uruchomienie aktualizacji, a nie jej wyłączenie. To samo MySQL backend jest używany przez instalację Hive, o której mowa zainstaluj Hive na Ubuntu.
Typowe błędy Hive Metastore i jak je naprawić
Większość błędów na tym etapie powoduje wyświetlenie jednego z kilku komunikatów, z których każdy wskazuje na konkretny krok powyżej, a nie na sam Hive.
| Objaw | Przyczyna i naprawa |
|---|---|
| Informacje o wersji nie zostały znalezione w metamagazynie | Schemat nigdy nie został utworzony. Uruchom schematool z opcją -initSchema dla tej samej bazy danych, o której mowa w połączeniu. URL |
| Wyjątek ClassNotFoundException dla sterownika JDBC | Brak pliku JAR złącza w katalogu biblioteki Hive lub używany jest Connector/J 8, a klasa to teraz com.mysql.cj.jdbc.Driver. Sprawdź ponownie dowiązanie programowe z kroku 3. |
| Dostęp zabroniony dla użytkownika hiveuser | Uprawnienia zostały przyznane tylko jednemu hostowi. Utwórz konto zarówno dla hosta lokalnego, jak i hosta z symbolem wieloznacznym, a następnie uruchom polecenie „flush privileges”. |
| Błąd składni w pobliżu IDENTYFIKOWANEGO PRZEZ | MySQL 8 usunięto IDENTIFIED BY z polecenia GRANT. Najpierw wydaj polecenie CREATE USER, a następnie GRANT |
| Pobieranie klucza publicznego jest niedozwolone | Connector/J 8 domyślnie odrzuca niezaszyfrowane uzgadnianie. Dodaj useSSL=false i allowPublicKeyRetrieval=true do JDBC. URL w zaufanej sieci |
| Brak tabel po aktualizacji Hive | Schemat nadal pasuje do starej wersji. Uruchom schematool z opcją -upgradeSchema zamiast wyłączać weryfikację schematu. |
Gdy metamagazyn odpowie niezawodnie, tworzone są definicje tabel, które rejestruje, przy użyciu instrukcji opisanych w Hive tworzy, zmienia i usuwa tabele.
