
Samouczek dotyczący łączenia i podkwerend Hive z przykładami
 David Carter
⚡ Inteligentne podsumowanie
Połączenia Hive łączą wiersze z dwóch lub więcej tabel w ramach pasującej kolumny, a podzapytania zagnieżdżają jedno zapytanie w drugim. Dlatego oba te procesy są tutaj zaprezentowane na dwóch przykładowych tabelach załadowanych z plików tekstowych.

Dołącz do zapytań
Zapytania łączące można wykonywać na dwóch tabelach obecnych w UlAby lepiej zrozumieć koncepcje łączenia, tworzymy tutaj dwie tabele:
- sample_joins (związane ze szczegółami klienta)
- sample_joins1 (związane ze szczegółami zamówień złożonych przez pracowników)
Krok 1) Utworzenie tabeli „sample_joins” z nazwami kolumn: ID, Imię, Wiek, Adres i Wynagrodzenie pracowników. Poniższy zrzut ekranu przedstawia polecenie CREATE TABLE i jego potwierdzenie.

Krok 2) Ładowanie i wyświetlanie danych. Poniższy zrzut ekranu pokazuje polecenie ładowania, a następnie zawartość tabeli.
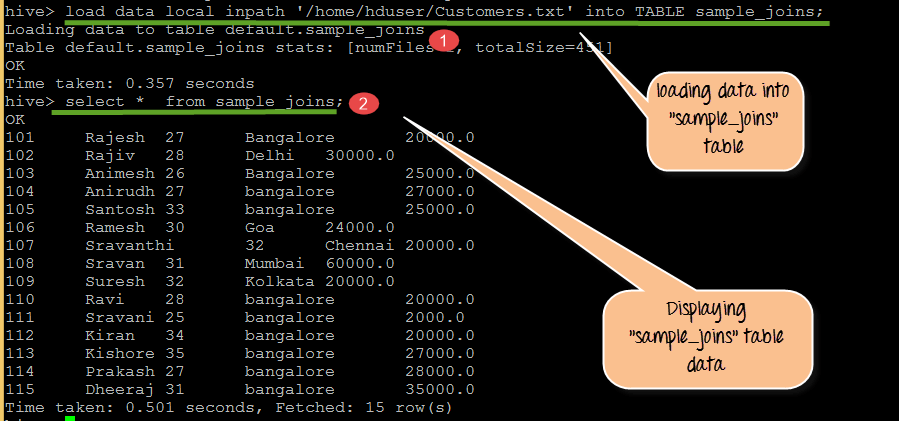
Ze zrzutu ekranu powyżej:
- Ładowanie danych do sample_joins z pliku Customers.txt
- Wyświetlanie zawartości tabeli sample_joins
Krok 3) Utworzenie tabeli sample_joins1, a następnie załadowanie i wyświetlenie jej danych, jak pokazano na zrzucie ekranu poniżej.

Na powyższym zrzucie ekranu możemy zaobserwować następujące rzeczy:
- Utworzenie tabeli sample_joins1 z kolumnami Orderid, Date1, Id i Amount
- Ładowanie danych do sample_joins1 z pliku Orders.txt
- Wyświetlanie rekordów obecnych w sample_joins1
Następnie przyjrzymy się różnym typom połączeń, które można wykonać w utworzonych przez nas tabelach. Zanim to nastąpi, należy omówić poniższe kwestie dotyczące połączeń.
Kilka punktów, na które należy zwrócić uwagę przy łączeniu:
- W połączeniach dozwolone są tylko połączenia równościowe
- W tym samym zapytaniu można połączyć więcej niż dwie tabele
- Połączenia LEFT, RIGHT i FULL OUTER są dostępne w celu zapewnienia większej kontroli nad klauzulą ON, dla której nie ma dopasowania
- Połączenia nie są przemienne
- Złączenia są lewostronnie skojarzone niezależnie od tego, czy są to połączenia LEWE czy PRAWE
Ograniczenie równości odzwierciedla Hive w formie, w jakiej istniał przez wiele lat. Od wersji Hive 2.2.0, złożone wyrażenia są obsługiwane w klauzuli ON (HIVE-15211), więc warunek nierówności jest akceptowany w bieżącej wersji. W starszych wersjach warunek musi być testem równości, a wszystkie inne elementy muszą być przeniesione do klauzuli WHERE.
Różne typy złączeń
Istnieją cztery typy połączeń. Są to:
- Wewnętrzne dołączenie
- Lewe sprzężenie zewnętrzne
- Prawe połączenie zewnętrzne
- Pełne połączenie zewnętrzne
Każdy typ zaprezentowano poniżej na przykładzie tych samych dwóch tabel, więc jedyną różnicą pomiędzy przykładami jest to, które niedopasowane wiersze przetrwają.
Połączenie wewnętrzne
Rekordy wspólne dla obu tabel zostaną pobrane za pomocą tego łączenia wewnętrznego. Wynik na poniższym zrzucie ekranu zawiera tylko klientów, którzy mają zgodne zamówienie.

Na powyższym zrzucie ekranu możemy zaobserwować następujące rzeczy:
- Tutaj wykonujemy zapytanie łączące przy użyciu słowa kluczowego JOIN między tabelami sample_joins i sample_joins1, z warunkiem dopasowania (c.Id = o.Id).
- Na wyjściu wyświetlane są wspólne rekordy obecne w obu tabelach, wybrane poprzez sprawdzenie warunku określonego w zapytaniu.
zapytanie:
SELECT c.Id, c.Name, c.Age, o.Amount FROM sample_joins c JOIN sample_joins1 o ON(c.Id=o.Id);
Lewe połączenie zewnętrzne
- HiveQL LEFT OUTER JOIN zwraca wszystkie wiersze z lewej tabeli, nawet jeśli nie ma żadnych dopasowań w prawej tabeli
- Jeśli klauzula ON nie pasuje do żadnych rekordów w prawej tabeli, połączenie nadal zwraca rekord w wyniku z wartością NULL w każdej kolumnie z prawej tabeli
Na poniższym zrzucie ekranu widać, że są obecni wszyscy klienci, także ci, którzy nie złożyli zamówienia.

Na powyższym zrzucie ekranu możemy zaobserwować następujące rzeczy:
- Tutaj wykonujemy zapytanie łączące za pomocą słowa kluczowego „LEFT OUTER JOIN” między tabelami sample_joins i sample_joins1, z warunkiem dopasowania (c.Id = o.Id). Na przykład, tutaj używamy identyfikatora pracownika jako odniesienia; sprawdza on, czy identyfikator jest wspólny zarówno dla tabeli prawej, jak i lewej. Działa on jako warunek dopasowania.
- Wynik wyświetla rekordy wybrane zgodnie z warunkiem określonym w zapytaniu. Wartości NULL w powyższym wyniku to kolumny bez wartości z prawej tabeli, czyli sample_joins1.
zapytanie:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c LEFT OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
Prawe połączenie zewnętrzne
- Funkcja HiveQL RIGHT OUTER JOIN zwraca wszystkie wiersze z prawej tabeli, nawet jeśli nie ma żadnych dopasowań w lewej tabeli
- Jeśli klauzula ON nie pasuje do żadnych rekordów w lewej tabeli, połączenie nadal zwraca rekord w wyniku z wartością NULL w każdej kolumnie z lewej tabeli
- Łączenia RIGHT zawsze zwracają rekordy z prawej tabeli i dopasowane rekordy z lewej tabeli. Jeśli lewa tabela nie zawiera wartości odpowiadającej kolumnie, zwróci w tym miejscu wartości NULL.
Zrzut ekranu poniżej pokazuje lustrzane odbicie poprzedniego wyniku: pojawia się każde zamówienie, niezależnie od tego, czy zostało zrealizowane, czy nie.

Na powyższym zrzucie ekranu możemy zaobserwować następujące rzeczy:
- Tutaj wykonujemy zapytanie łączące przy użyciu słowa kluczowego „RIGHT OUTER JOIN” między tabelami sample_joins i sample_joins1, z warunkiem dopasowania (c.Id = o.Id).
- Na wyjściu wyświetlane są rekordy wybrane poprzez sprawdzenie warunku podanego w zapytaniu.
zapytanie:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c RIGHT OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
Pełne połączenie zewnętrzne
Łączy rekordy obu tabel sample_joins i sample_joins1 na podstawie warunku JOIN podanego w zapytaniu.
Zwraca wszystkie rekordy z obu tabel i wypełnia wartości NULL w kolumnach, których odpowiadających wartości brakuje po obu stronach, jak pokazano na poniższym zrzucie ekranu.

Na powyższym zrzucie ekranu możemy zaobserwować następujące rzeczy:
- Tutaj wykonujemy zapytanie łączące przy użyciu słowa kluczowego „FULL OUTER JOIN” między tabelami sample_joins i sample_joins1, z warunkiem dopasowania (c.Id = o.Id).
- Wynik wyświetla wszystkie rekordy obecne w obu tabelach, wybrane poprzez sprawdzenie warunku określonego w zapytaniu. Wartości NULL w tym wyniku oznaczają brakujące wartości w kolumnach obu tabel.
zapytanie:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c FULL OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
Zapytania podrzędne
Połączenia umieszczają tabele obok siebie. Podzapytanie działa inaczej: zagnieżdża jedno zapytanie w drugim, dzięki czemu zapytanie zewnętrzne może działać na podstawie wyniku, który został już obliczony.
Zapytanie zawarte w zapytaniu nazywane jest podzapytaniem. Zapytanie główne będzie zależało od wartości zwróconych przez podzapytanie.
Podzapytania można podzielić na dwa typy:
- Podzapytania w klauzuli FROM
- Podzapytania w klauzuli WHERE
Kiedy użyć:
- Aby uzyskać określoną wartość, połączoną z wartości dwóch kolumn z różnych tabel
- Zależność wartości jednej tabeli od wartości innych tabel
- Porównawcze sprawdzenie wartości jednej kolumny z wartościami innych tabel
Składnia:
Subquery in FROM clause
SELECT <column names 1, 2…n>From (SubQuery) <TableName_Main >
Subquery in WHERE clause
SELECT <column names 1, 2…n> From<TableName_Main>WHERE col1 IN (SubQuery);
Przykład:
SELECT col1 FROM (SELECT a+b AS col1 FROM t1) t2
Tutaj t1 i t2 to nazwy tabel. Wewnętrzne polecenie to podzapytanie wykonane na tabeli t1. Tutaj a i b to kolumny dodane w podzapytaniu i przypisane do kolumny col1. Col1 to wartość kolumny obecna w tabeli głównej. Kolumna „col1” obecna w podzapytaniu jest równoważna zapytaniu tabeli głównej w kolumnie col1.
Osadzanie niestandardowych skryptów
Podczas gdy podzapytanie przekształca dane wyłącznie za pomocą języka HiveQL, osadzony skrypt przekazuje wiersze do kodu napisanego poza środowiskiem Hive.
Hive umożliwia pisanie skryptów dostosowanych do potrzeb klienta. Użytkownicy mogą tworzyć własne mapy i redukować skrypty, aby spełnić te wymagania. Są to tak zwane wbudowane skrypty niestandardowe. Logika kodowania jest zdefiniowana w skrypcie niestandardowym, z którego możemy korzystać w procesie ETL.
Kiedy wybrać skrypty osadzone:
- W przypadku gdy wymagania specyficzne dla klienta oznaczają, że deweloperzy muszą pisać i wdrażać skrypty w Hive
- W przypadku wymagań konkretnej domeny wbudowane funkcje Hive nie będą działać
W tym celu Hive używa klauzuli TRANSFORM, aby osadzić zarówno skrypty mapy, jak i reduktora.
W przypadku tych osadzonych skryptów niestandardowych musimy zwrócić uwagę na następujące kwestie:
- Kolumny zostaną przekształcone w ciągi znaków i ograniczone tabulatorem przed przekazaniem do skryptu użytkownika
- Standardowe dane wyjściowe skryptu użytkownika będą traktowane jako kolumny ciągów znaków rozdzielone tabulatorami
Przykładowy osadzony skrypt:
FROM (
	FROM pv_users
	MAP pv_users.userid, pv_users.date
	USING 'map_script'
	AS dt, uid
	CLUSTER BY dt) map_output

INSERT OVERWRITE TABLE pv_users_reduced
	REDUCE map_output.dt, map_output.uid
	USING 'reduce_script'
	AS date, count;
Z powyższego skryptu możemy wywnioskować, co następuje. To tylko przykładowy skrypt, służący zrozumieniu.
- pv_users to tabela użytkowników zawierająca pola takie jak identyfikator użytkownika i data, jak wspomniano w map_script
- Skrypt reduktora jest zdefiniowany na podstawie daty i liczby w tabeli pv_users
