
Jak przesłać plik płaski do SAP HANA: CSV, XLS i XLSX
 Masona Garcii
⚡ Inteligentne podsumowanie
Prześlij plik płaski do SAP HANA ładuje dane CSV, XLS i XLSX bezpośrednio z komputera klienckiego bez użycia narzędzi ETL. HANA Studio proponuje nazwy kolumn i typy danych, a następnie mapuje kolumny źródłowe na nową lub istniejącą tabelę.
SAP HANA obsługuje przesyłanie danych z pliku bez narzędzi ETL (SLT, BODS i DXC). Jest to nowa funkcja HANA Studio Revizja 28 (SPS04).
SAP Obsługa HANA następujących typów plików, które będą dostępne na systemie klienta, przedstawia się następująco:
- .CSV (pliki z wartościami rozdzielanymi przecinkami)
- . XLS
- .XLSX
Przed skorzystaniem z tej opcji użytkownik musi utworzyć plik kontrolny (plik .CTL). Aby przesłać dane do SAP HANA, tabela musi istnieć SAP HANA. Jeśli tabela istnieje, rekordy zostaną dodane na końcu tabeli. Jeśli tabela nie istnieje, należy ją utworzyć.
Ta aplikacja sugeruje nazwę kolumny i typ danych dla nowych tabel.
Przed przesłaniem: lista kontrolna przygotowania pliku
Większość nieudanych prób przesłania pliku wynika z jego problemów, a nie z działania HANA. Ponadto taniej jest rozwiązać każdy z tych problemów przed rozpoczęciem przesyłania niż po częściowym załadowaniu.
- Jeden wiersz nagłówka, brak scalonych komórek. Kreator proponuje nazwy kolumn z nagłówka. Połączone komórki, wiersz tytułu nad nagłówkiem lub pusty pierwszy wiersz – wszystkie te przypadki powodują powstanie bezsensownych nazw kolumn.
- Nazwy kolumn bez spacji i znaków specjalnych. Proponowane kolumny tabeli dziedziczą tekst nagłówka. Nazwy takie jak „Sprzedaż – Organizacja” stają się niewygodnymi identyfikatorami, które później wymagają użycia cudzysłowów w każdym zapytaniu.
- Spójne typy danych w każdej kolumnie. Kolumna zawierająca liczby z jednym wpisem tekstowym jest proponowana jako znak, a każde dalsze obliczenie wymaga konwersji.
- Daty w jednoznacznym formacie. YYYY-MM-DD usuwa niejednoznaczności dotyczące dnia i miesiąca, które dyskretnie psują ładowanie.
- Brak separatorów tysięcy w kolumnach numerycznych. Wartość 1,000 jest odczytywana jako tekst, a nie jako liczba.
- Prawidłowe kodowanie w pliku CSV. Kodowanie UTF-8 zachowuje znaki spoza zestawu ASCII, podczas gdy inne kodowania zamieniają je na znaki zamienne, które później trudno poprawić.
- Tylko jeden arkusz z danymi. W przypadku formatu XLSX dodatkowe arkusze i ukryte wiersze często powodują zamieszanie w liczbie wierszy.
Poświęcenie kilku minut na plik sprawia również, że propozycje typów są lepsze, ponieważ HANA wnioskuje o każdej kolumnie na podstawie widocznych wartości. Zachowanie typów jest omówione w SAP Typy danych HANA.
Jak przesłać dane z pliku płaskiego do SAP HANA
Kroki przesyłania danych z pliku płaskiego do SAP HANA jest jak poniżej-
- Utwórz tabelę w SAP HANA
- Utwórz plik z danymi w naszym systemie lokalnym
- Wybierz plik
- Zarządzaj mapąpings
- Załaduj dane
Utwórz tabelę w SAP HANA
Jeśli tabela nie jest obecna w SAP HANA, wtedy możemy stworzyć tabelę wg SQL Skrypt lub w ten sposób, wybierając "NOWY" opcja.
Do utworzenia nowej tabeli użyjemy opcji „NOWY”.
Utwórz plik z danymi w naszym lokalnym systemie
Zamierzamy przesłać dane podstawowe organizacji sprzedaży. Utwórz więc dla niego plik .csv i .xls w systemie lokalnym.
Zamierzamy wgrać plik SalesOrg.xlsx do SAP HANA, dlatego w systemie lokalnym utworzyliśmy plik SalesOrg.xlsx.
| Organizacja sprzedaży | Imię i nazwisko | Waluta | CoCode | Adres | Kraj | Ref_Sorg |
|---|---|---|---|---|---|---|
| 1000 | Firma ABC Sp. Sp. z o.o. | USD | 1000 | NEW YORK | USA | 1000 |
| 2000 | ABC Przedsiębiorstwa | INR | 2000 | INDIE | INDIE | 2000 |
Wybierz plik
Krok 1) Otwórz perspektywę modelarza -> „Menu główne” -> „Pomoc” -> „Szybki podgląd”, jak pokazano poniżej.

Pojawi się ekran szybkiego podglądu, jak poniżej:
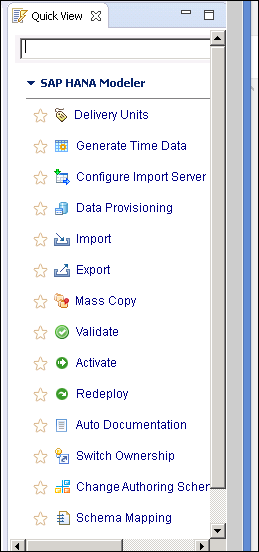
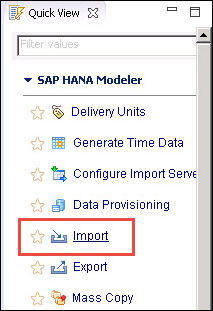
Wybierz opcję „Importuj” z Szybkiego podglądu. Wyświetli się okno dialogowe z opcją importu.
Wyświetla się okno dialogowe do importu. Przejdź do SAP Zawartość HANA -> 'Dane z pliku lokalnego'.

Kliknij Dalej. Wyświetli się okno wyboru pliku. Aby wybrać plik, wykonaj poniższe kroki.
- Wybierz plik SalesOrg.xls.
- Kliknij przycisk „Otwórz”.
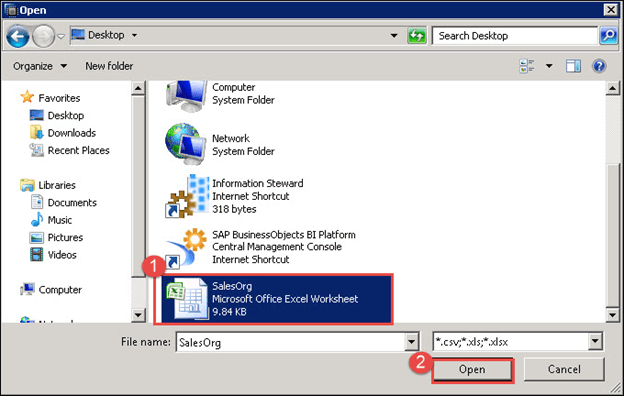
Wyświetli się ekran wyboru pliku do importu, w którym możemy wybrać plik, do którego zostaną załadowane dane z systemu lokalnego. SAP baza danych HANA.
Dostępne opcje można podzielić na trzy główne obszary
- Sekcja pliku źródłowego
- Sekcja szczegółów pliku
- Target Stół
Krok 2) W tym kroku musimy wprowadzić następujące szczegóły –
- Wybierz Plik – Wybrana ścieżka pliku zostanie wyświetlona w tym miejscu.
- Wiersz nagłówka istnieje – Jeśli plik SalesOrg.xls posiada nagłówek (nazwa kolumny). Zatem zaznaczyliśmy to.
- Importuj wszystkie dane – Zaznacz tę opcję, jeśli chcesz zaimportować wszystkie dane z pliku, w przeciwnym razie podaj linię początkową i linię końcową, aby załadować określone dane z pliku.
- Ignoruj początkowe i końcowe białe znaki – Zaznacz tę opcję, aby zignorować początkowe i końcowe spacje w pliku.
- Target Stół – Nowy:Jeśli tabela nie jest obecna w SAP HANA, a następnie wybierz tę opcję i podaj nazwę istniejącego schematu oraz nazwę tabeli, która ma zostać utworzona.
- Target Tabela – Istniejąca:Jeśli tabela istnieje w SAP HANA, a następnie wybierz tę opcję. Wybierz nazwę schematu i tabelę. Dane zostaną dodane na końcu tabeli.
- Kliknij przycisk „Dalej”.

Zarządzaj mapąpings
Mapaping ekran będzie używany do wykonania mapyping między kolumną źródłową i docelową.
Istnieją dwa różne typy mapping dostępne. Kiedy klikniemy  otrzymujemy dwie opcje jak poniżej –
- One to One: Korzystając z tej opcji, możemy mapować kolumny do kolumn na podstawie sekwencji. Opcji tej można użyć, jeśli wiemy, że wszystkie kolumny są po kolei.
- Mapa według nazwy: Korzystając z tej opcji, możemy zmapować kolumny źródłowe i docelowe na podstawie nazwy. Można tego użyć, jeśli wiemy, że nazwy kolumn są takie same.
Mapaping Źródła do Target - Zamapujemy tutaj kolumnę Plik źródłowy na Target Tabela, a także możemy zmienić definicję tabeli docelowej.
- Proponowana struktura tabeli z pliku źródłowego Nazwa kolumny tabeli ma pochodzić z pliku Excel. Nazwa kolumny (nagłówek).
- Target Struktura tabeli: Target Typ magazynu tabel jest domyślnie wybrany jako magazyn kolumnowy.
- Kliknij nazwę pliku i przeciągnij ją do pola docelowego. Plik zostanie zmapowany. Pole można zmapować automatycznie (jeden do jednego) lub według nazwy. Mapowanie można wykonać ręcznie.ping używając opcji „przeciągnij i upuść”, jeśli nazwa naszej kolumny nie może zostać zmapowana przy użyciu powyższych opcji.

- W sekcji „Dane pliku” na tym samym ekranie możemy również zobaczyć, jak wyglądają dane w pliku źródłowym dla wszystkich kolumn. Sekcja „Dane pliku” wyświetla dane z pliku SalesOrg.
- Kliknij przycisk „Dalej”.


Pojawi się okno umożliwiające import danych z pliku lokalnego.
Załaduj dane
To ostatni ekran przed rozpoczęciem procesu ładowania. Na tym ekranie wyświetlone zostaną dane, które już istnieją w tabeli, a także informacje o schemacie i tabeli, do której dane zostaną załadowane.
- Sekcje szczegółowe:W tej sekcji Wybrana nazwa pliku źródłowego, Target Nazwa tabeli i Target Zostaną wyświetlone szczegóły nazwy schematu.
- Dane z pliku: Wyświetli dane np.tracted z pliku.
- Jeżeli dane wyświetlone w sekcji Dane z pliku zostały zweryfikowane, kliknij „Zakończ”, aby rozpocząć ładowanie danych do tabeli.

Po pomyślnym zakończeniu importu powinniśmy zobaczyć wpis w widoku dziennika zadań ze statusem „Zakończono pomyślnie”.

Gdy zadanie importowania danych zakończy się pomyślnie,
- Możemy zobaczyć dane w tabeli, wybierając tabelę odpowiedniego schematu i klikając prawym przyciskiem myszy na Tabelę -> „Podgląd danych”, jak pokazano poniżej.
- Dane tabeli zostaną wyświetlone na ekranie podglądu danych, jak poniżej:

Typowe błędy przesyłania plików płaskich
Czarodziej jest wyrozumiały, co jest przejawem przewagi i błogosławieństwa: niektóre problemy generują oczywisty błąd, a inne ładują się po cichu, dając błędny wynik. Oba rodzaje problemów są tutaj wymienione.
| Objaw | Spowodować | Fix |
|---|---|---|
| Nazwy kolumn pojawiają się jako COL1, COL2 | Opcja „Nagłówek wiersza istnieje” nie została zaznaczona | Wróć do ekranu ze szczegółami pliku i zaznacz to |
| Ładowanie kończy się niepowodzeniem z powodu błędu długości | Proponowana długość kolumny jest krótsza niż wartość znajdująca się dalej w pliku | Poszerz kolumnę na mapieping ekran przed załadowaniem |
| Numbers przybyć jako tekst | Separatory tysięcy lub przypadkowa wartość tekstowa w kolumnie | Wyczyść kolumnę źródłową i załaduj ponownie |
| Daty są błędne lub odrzucone | Niejednoznaczny lub specyficzny dla danego regionu format daty | Zmień format pliku na RRRR-MM-DD |
| Wiersze są duplikowane | Wybrano istniejący i powtórzono obciążenie; dane są dodawane, nie zastępują | Przed ponownym załadowaniem skróć tabelę |
| Znaki akcentowane są uszkodzone | Plik CSV zapisany w kodowaniu innym niż UTF-8 | Zapisz ponownie jako UTF-8 i załaduj ponownie |
| Załadowano mniej wierszy niż oczekiwano | Zamiast opcji Importuj wszystkie dane ustawiono linię początkową i końcową | Zaznacz opcję Importuj wszystkie dane |
Należy zwrócić uwagę na przypadek duplikacji. Wybranie istniejącej tabeli zawsze powoduje dodanie danych, więc ponowne uruchomienie nieudanego ładowania bez czyszczenia tabeli powoduje ciche podwojenie danych.
Przesyłanie plików płaskich a inne metody udostępniania
Przesyłanie plików płaskich to najprostsza dostępna opcja, ale też najbardziej ograniczona. Wiedza o miejscu, w którym plik się zatrzymuje, zapobiega jego użyciu w miejscu, w którym powinna być zaplanowana metoda.
| Parametr | Przesyłanie pliku płaskiego | SLT | Usługi danych |
|---|---|---|---|
| Automatyzacja | Tylko ręczne | Zaplanowane lub w czasie rzeczywistym | Planowy |
| Powtarzalny | Nie, każdy bieg jest wykonywany ręcznie | Tak | Tak |
| Transformacja | Mapa kolumnowaping tylko | Proste zasady | Bogate transformacje |
| objętość | Małe pliki | Duże stoły | Duże i niejednorodne |
| Wysiłek konfiguracji | żaden | Serwer SLT | Krajobraz usług danych |
| Najlepszy dla | Prototyping, małe dane referencyjne | Dane operacyjne na żywo | Konsolidacja wielu źródeł |
Zasada jest prosta: jeśli ten sam plik będzie ładowany ponownie w przyszłym miesiącu, ładowanie należy do Usługi danych or SLT Zamiast w kreatorze, ktoś musi pamiętać o uruchomieniu. Pełny zestaw opcji jest porównywany w dostarczanie danych samouczek, a odpowiednia opcja w menu Plik jest opisana w SAP Import i eksport HANA.
