
Hive ETL: Ładowanie przykładów JSON, XML i danych tekstowych
 David Carter
⚡ Inteligentne podsumowanie
Hive ETL przekształca pliki tekstowe, XML i JSON w tabele z możliwością zapytania, ładując je do Hive itracwartości za pomocą xpath() i get_json_object(), co zapewnia analitykom interfejs SQL dla półustrukturyzowanych danych Hadoop.
Hive jako narzędzie ETL i magazynowania danych na platformie Hadoop Ekosystem zapewnia funkcjonalności takie jak modelowanie danych, manipulacja danymi, przetwarzanie danych i wyszukiwanie danych. Dane extracW Hive oznacza to tworzenie tabel w Hive i ładowanie ustrukturyzowanych i półustrukturyzowanych danych, a także wykonywanie zapytań dotyczących danych na podstawie wymagań.
W przypadku przetwarzania wsadowego napiszemy niestandardowe skrypty, używając niestandardowych skryptów map i redukcji w języku skryptowym. Zapewnia to SQL jak środowisko i obsługa łatwego wysyłania zapytań.
Praca z danymi strukturalnymi przy użyciu Hive
Ustrukturyzowane dane oznaczają, że dane mają odpowiedni format wierszy i kolumn. To jest bardziej jak RDBMS dane z odpowiednimi wierszami i kolumnami.
Tutaj załadujemy ustrukturyzowane dane zawarte w plikach tekstowych w Hive.
Krok 1) Na tym etapie tworzymy tabelę „employees_guru” z nazwami kolumn, takimi jak Id, Imię, Wiek, Adres, Wynagrodzenie i Dział pracowników z typami danych.

Na powyższym zrzucie ekranu możemy zaobserwować następujące rzeczy:
- Utworzenie tabeli „employees_guru”
- Ładowanie danych z pliku Employees.txt do tabeli „employees_guru”
Krok 2) W tym kroku wyświetlamy zawartość zapisaną w tej tabeli za pomocą polecenia „Select”. Zawartość tabeli można zobaczyć na poniższym zrzucie ekranu.

Przykładowy fragment kodu
Zapytania do wykonania
1) Create table employees_guru(Id INT, Name STRING, Age INT, Address STRING, Salary FLOAT, Department STRING)
> Row format delimited
> Fields terminated by ',';
2) load data local inpath '/home/hduser/Employees.txt' into TABLE employees_guru;
3) select * from employees_guru;
Praca z danymi półustrukturyzowanymi przy użyciu Hive (XML, JSON)
Hive wykonuje funkcjonalności ETL w ekosystemie Hadoop, działając jako Narzędzie ETLW niektórych typach aplikacji wdrożenie MapReduce może być trudne; Hive może zredukować tę złożoność i zapewnić najlepsze rozwiązanie dla aplikacji IT w sektorze magazynowania danych.
Dane półstrukturalne, takie jak XML i JSON, można przetwarzać z mniejszą złożonością za pomocą Hive. Najpierw zobaczymy, jak możemy wykorzystać Hive do… XML.
XML do tabeli Hive
W tym przypadku załadujemy dane XML do tabel Hive i pobierzemy wartości przechowywane w tagach XML.
Krok 1) Utworzenie tabeli „xmlsample_guru” z kolumną str o typie danych string.

Na powyższym zrzucie ekranu możemy zaobserwować następujące rzeczy:
- Utworzenie tabeli „xmlsample_guru”
- Ładowanie danych z pliku test.xml do tabeli „xmlsample_guru”
Krok 2) Korzystanie z XPath Metodą xpath() będziemy mogli pobrać dane zapisane w znacznikach XML.
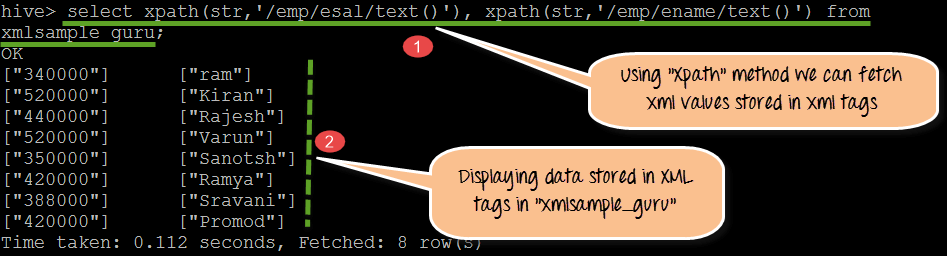
Na powyższym zrzucie ekranu możemy zaobserwować następujące rzeczy:
- Używając metody xpath() pobieramy wartości przechowywane w /emp/esal/ i /emp/ename/
- Wartości obecne w znacznikach XML. W tym kroku wyświetlamy rzeczywiste wartości zapisane w znacznikach XML w tabeli „xmlsample_guru”.
Należy pamiętać, że xpath() zwraca tablicę ciągów znaków; xpath_string(), xpath_int() i xpath_double() zwracają pojedynczą wartość typu.
Krok 3) W tym kroku pobierzemy i wyświetlimy surowy kod XML tabeli „xmlsample_guru”.

Na powyższym zrzucie ekranu możemy zaobserwować następujące rzeczy:
- Rzeczywiste dane XML wyświetlane ze znacznikami
- Jeśli zaobserwujemy pojedynczy znacznik, to będzie on miał znacznik nadrzędny „emp” oraz znaczniki podrzędne „ename” i „esal”.
Code skrawek:
Zapytania do wykonania
1) create table xmlsample_guru(str string);                                                                                                   2) load data local inpath '/home/hduser/test.xml' overwrite  into table xmlsample_guru;
3) select xpath(str,'emp/ename/text()'), xpath(str,'emp/esal/text()') from xmlsample_guru;
JSON (JavaNotacja obiektu skryptu)
Dane z mediów społecznościowych i stron internetowych są powszechnie przechowywane w formacie JSON. Za każdym razem, gdy próbujemy pobrać dane z serwerów online, zwracane są pliki JSON. Używając Hive jako magazynu danych, możemy ładować dane JSON do tabel Hive, tworząc schematy.
JSON do tabeli Hive
W tym artykule załadujemy dane JSON do tabel Hive i pobierzemy wartości przechowywane w schemacie JSON.
Krok 1) W tym kroku utworzymy tabelę JSON o nazwie „json_guru”. Po jej utworzeniu ładujemy i wyświetlamy zawartość właściwego schematu.

Na powyższym zrzucie ekranu możemy zaobserwować następujące rzeczy:
- Utworzenie tabeli „json_guru”
- Ładowanie danych z pliku test.json do tabeli „json_guru”
- Wyświetlanie rzeczywistego schematu pliku JSON zapisanego w tabeli json_guru
Krok 2) Za pomocą metody get_json_object() możemy pobrać wartości danych przechowywane w hierarchii JSON.

Na powyższym zrzucie ekranu możemy zaobserwować następujące rzeczy:
- Używając get_json_object(str,'$.ecode'), można pobrać wartości ecode z tabeli json_guru. Analogicznie, używając get_json_object(str,'$.ename') i get_json_object(str,'$.sal'), można pobrać wartości ename i sal z tabeli json_guru.
- Wartości przechowywane w hierarchii JSON w json_guru
Ponieważ get_json_object() analizuje dokument raz na wywołanie, json_tuple() jest tańsze, gdy potrzebnych jest kilka kluczy, a JSON SerDe mapuje dokument na kolumny o określonym typie w momencie ładowania.
Code skrawek
Zapytania do wykonania
1) create table json_guru(str string);
2) load data inpath 'home/hduser/test.json' into table json_guru;
3) select * from json_guru;
4) select get_json_object(str,'$.ecode') as ecode, get_json_object(str,'$.ename') as ename ,get_json_object(str,'$.sal') as salary from json_guru;
Złożona tabela JSON do Hive
W tym artykule załadujemy złożone dane JSON do tabel Hive i pobierzemy wartości przechowywane w schemacie JSON.
Krok 1) Tworzenie complexjson_guru z polem jednokolumnowym.

Na powyższym zrzucie ekranu możemy zaobserwować następujące rzeczy:
- Utworzenie tabeli complexjson_guru z pojedynczym polem kolumny jako typem danych ciągu
- Ładowanie danych do complexjson_guru z pliku JSON emp.json
Krok 2) Używając get_json_object możemy pobrać faktyczną zawartość przechowywaną w hierarchii plików JSON.
Na poniższym zrzucie ekranu możemy zobaczyć dane wyjściowe zapisane w complexjson_guru.
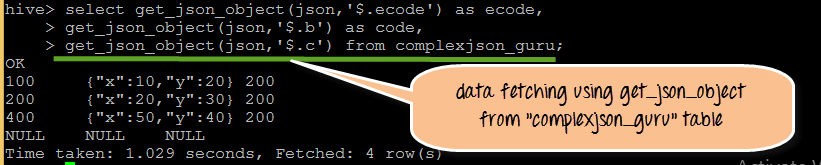
Krok 3) W tym kroku, używając polecenia „Select”, możemy zobaczyć złożone dane JSON zapisane w tabeli „complexjson_guru”.

Przykładowy fragment kodu
Zapytania do wykonania
1) create table complexjson_guru(json string);
2) load data inpath 'home/hduser/emp.json' into table complexjson_guru;
3) select get_json_object(json,'$.ecode') as ecode ,get_json_object(json,'$.b') as code, get_json_object(json,'$.c') from complexjson_guru;
4) select * from complexjson_guru;
Projekty Hive w czasie rzeczywistym – kiedy i gdzie używać
Kiedy i gdzie używać Hive w ekosystemie Hadoop:
Kiedy
- Podczas pracy z silnymi i wydajnymi funkcjami statystycznymi w ekosystemie Hadoop
- Podczas pracy z przetwarzaniem danych ustrukturyzowanych i półustrukturyzowanych
- Jako narzędzie magazynu danych z Hadoop
- Pobieranie danych w czasie rzeczywistym za pomocą HBase, gdzie można używać Hive
Gdzie
- Dla łatwości użytkowania jako narzędzie ETL i magazynowania danych
- Aby zapewnić środowisko typu SQL i wykonywać zapytania podobne do SQL przy użyciu HiveQL
- Aby używać i wdrażać niestandardowe skrypty map i reduktorów dla określonych wymagań klienta
