
Samouczek Apache Solr: Co to jest Solr? Architektura
 David Carter
⚡ Inteligentne podsumowanie
Apache Solr jest oprogramowaniem typu open source, JavaSerwer wyszukiwania oparty na Apache Lucene. Indeksuje duże wolumeny danych tekstowych i zwraca trafne wyniki za pośrednictwem interfejsów API REST, oferując wyszukiwanie pełnotekstowe, fasetowanie, skalowalność oraz tryby wdrożenia autonomicznego i w SolrCloud.
Co to jest Apache Solr?
Apache Solr jest napisaną platformą serwera wyszukiwania typu open source Java język Apache Software Foundation. Jest wysoce skalowalny i gotowy do wdrożenia wyszukiwarki do obsługi dużej ilości danych tekstowych. Celem korzystania z Apache Solr jest indeksowanie i przeszukiwanie dużej ilości treści internetowych oraz dostarczanie odpowiednich treści na podstawie zapytania wyszukiwania.
Apache Solr to oparty na REST-API wrapper HTTP wokół wyszukiwarki pełnotekstowej o nazwie Apache Lucene. Odwrócony indeks to lista słów, w której każde słowo-wpis odsyła do dokumentów, w których jest przechowywane. W ten sposób można uzyskać wszystkie dokumenty dla zapytania wyszukiwania „guru99” za pomocą prostej operacji „get”.
Historia Apache Solr
- 1999: Doug Cutting opublikował Lucene
- 2004: Solr został opracowany w CNET przez Yonika Seeleya jako część wewnętrznego projektu firmy
- 2006: CNET publikuje kod źródłowy, przekazując go firmie Apache Software Foundation
- 2008: Wydano Solr 1.3 z ulepszonymi możliwościami wyszukiwania i ulepszeniami wydajności
- 2010: Fuzja Lucene i Solr
- 2012: Wydano wersję Solr 4.0 z nową funkcją Solr Cloud
- 2016: Wydano Solr 6.0, który oferuje obsługę wykonywania równoległych zapytań SQL
- 2017: wydano Solr 7.0, dodający strukturę automatycznego skalowania i interfejs API JSON Facet
- 2019: wydano Solr 8.0 z obsługą zagnieżdżonych dokumentów i ulepszonymi wyrażeniami strumieniowymi
- 2021: Lucene i Solr ponownie się rozdzieliły, a Solr stał się niezależnym projektem najwyższego poziomu Apache
- 2022: wydano Solr 9.0 jako pierwszą wersję niezależną od Lucene, dodającą wyszukiwanie wektorowe i obsługę Kubernetes
- 2026: Solr 10.0 został wydany jako najnowsza główna wersja
Funkcje Apache Solr
Oto ważne funkcje Apache Solr:
- Automatyczne równoważenie obciążenia
- Otwarte interfejsy oparte na standardach – XML, JSON i HTTP
- Obsługiwane są rekomendacje i sugestie dotyczące pisowni
- Obsługa automatycznego uzupełniania i wyszukiwania geoprzestrzennego
- Wbudowane zabezpieczenia uwierzytelniania i autoryzacji
- Umożliwia wykonanie wielojęzycznego wyszukiwania słów kluczowych
- Autouzupełnianie/wpisywanie z wyprzedzeniem
- Przetwarzanie wsadowe i strumieniowe
- Tworzenie modeli uczenia maszynowego jest łatwe
- Specjalnie zoptymalizowany pod kątem dużego ruchu internetowego
- Kompleksowe interfejsy HTML do podziwiania
- Obsługuje konfigurację schematu i bez schematu
- Wyszukiwanie fasetowe i filtrowanie
- Centralna konfiguracja całości Cluster
Kluczowe terminy używane w Apache Solr
Teraz, w tym samouczku dotyczącym wyszukiwarki Solr, poznamy kluczowe terminy używane w Apache Solr:
| Kluczowe pojęcie | OPIS |
|---|---|
| Solr rdzeń | Rdzeń Solr można zdefiniować jako indeks tekstów i pól pochodzących ze wszystkich dokumentów. Jedna instancja Solr może mieć jeden lub wiele rdzeni Solr. Rdzeń = instancja indeksu Lucene + konfiguracja Solr. |
| Instancja Solra | Instancja Solr to instancja Solr działająca w środowisku Java Maszyna wirtualna (FMV). W trybie autonomicznym oferuje tylko jedną instancję, podczas gdy w trybie chmury możesz mieć jedną lub więcej instancji. |
| Indeksowanie | Indeksowanie to metoda dodawania zawartości dokumentu do Solr Index. Apache Solr wykorzystuje technikę odwróconego indeksu Apache Lucene. |
| dokument | Jest to grupa pól i ich wartości. Dokument to podstawowa jednostka danych przechowywanych w Apache Core. Jeden rdzeń Apache może zawierać jeden lub więcej Dokumentów. |
| Pole | Pole to para klucz-wartość, która przechowuje rzeczywiste dane w dokumencie. Klucz określa nazwę pola, a wartość zawiera dane tego pola. Dokument może zawierać jedno lub wiele pól. Jest ono używane przez Apache Solr do indeksowania zawartości dokumentu. |
| Spokojne interfejsy API | Aby komunikować się z Solr, nie jest konieczne używanie Java programowanie. Zamiast tego zapewnia Apache Solr spokojne usługi komunikować się z nim. Możesz wysyłać dokumenty i odbierać wyniki w różnych formatach plików, takich jak JSON, XML i CSV. |
| Wyszukiwanie pełnotekstowe | Solr oferuje funkcje wyszukiwania pełnotekstowego, takie jak tokeny, frazy, sprawdzanie pisowni, automatyczne uzupełnianie, symbole wieloznaczne itp. |
| Interfejs administratora | Solr oferuje łatwy w użyciu, przyjazny dla użytkownika, wyposażony w funkcje interfejs użytkownika. Za pomocą interfejsu możesz wykonywać zadania takie jak zarządzanie logami, dodawanie, usuwanie, aktualizacja i wyszukiwanie dokumentów. |
| Tekstocentryczny i posortowany według trafności | Apache Solr służy do wyszukiwania dokumentów tekstowych, a wyniki dostarczane są zgodnie z zapytaniem użytkownika. |
| Node | W chmurze Solr każda pojedyncza instancja nazywana jest węzłem. |
| Cluster | Klaster jest zbiorem węzłów. |
| | Klaster ma indeks logiczny, który nazywany jest również zbiorem. |
| Czerep | Jest to niewielki obszar zbioru, w którym znajdują się pojedyncze lub wielokrotne repliki indeksu. |
| Replika | Replika to kopia fragmentu działająca w węźle. |
| Lider | Jest to replika sharda, która wysyła żądania Chmury Solr dla pozostałych replik. |
Apache Solr Architektura
Teraz, w tym samouczku dotyczącym wyszukiwania Solr, dowiedzmy się o Apache Solr Archistruktura:

Apache Solr kompromituje następujące komponenty
Pytanie
Analizator zapytań analizuje zapytania, które należy przekazać do Solr. Weryfikuje zapytanie pod kątem błędów składniowych. Po przeanalizowaniu zapytania jest ono tłumaczone na format znany Lucene.
Osoba zajmująca się prośbami
Żądanie wysyłane do Apache Solr jest przetwarzane przez moduł obsługi żądań. Żądanie może być zapytaniem lub żądaniem aktualizacji indeksu. Należy wybrać moduł obsługi żądań zgodnie ze swoimi wymaganiami. Aby przekazać żądanie do Solr, należy zmapować moduł obsługi do konkretnego URL punkt końcowy.
Odpowiedź Writer
Moduł zapisujący odpowiedzi wygeneruje sformatowane dane wyjściowe dla zapytań wejściowych. Obsługuje różne formaty, takie jak XML, JSON, CSV.etc. Możesz mieć różnych autorów odpowiedzi dla różnych typów żądań.
Program obsługi aktualizacji
Gdy wysyłasz żądanie aktualizacji do Apache Solr, przechodzi ono przez zestaw wtyczek, sygnaturę, logowanie i indeksowanie. Ten proces nazywany jest procesorem żądania aktualizacji. Obsługa aktualizacji odpowiada również za modyfikacje, takie jak dodawanie lub usuwanie.ping złożony itp.
Aplikacje Apache Solr
| Zastosowanie | Stosowanie |
|---|---|
| Portalu Intranetowego |
|
| Klient federacyjny |
|
| Zestawy danych instrumentów |
|
| Dokumenty prawne |
|
| Osadzone w aplikacji PLM |
|
Jak zainstalować Apache Solr?
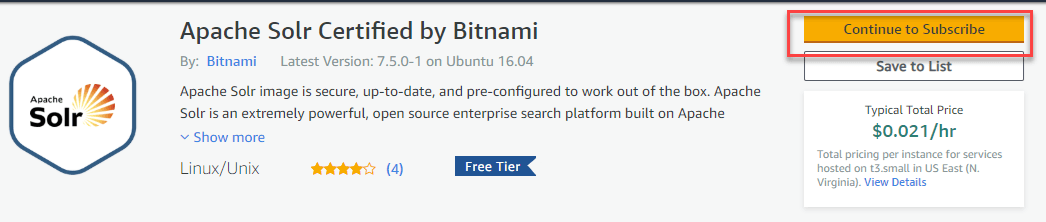
Krok 1) Otwórz stronę internetową i kontynuuj subskrypcję
Idź do tego link, Kliknij „Kontynuuj subskrypcję”.
Krok 2) Kliknij Zaakceptuj warunki
Na następnej stronie kliknij Zaakceptuj warunki.

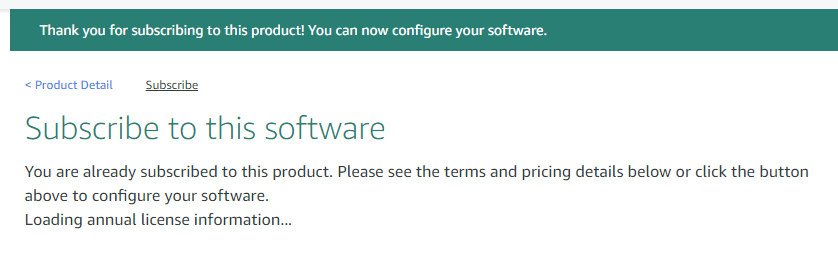
Krok 3) Poczekaj jakiś czas
Następnie poczekaj chwilę, a następnie Żądanie zostanie zaakceptowane po pewnym czasie.
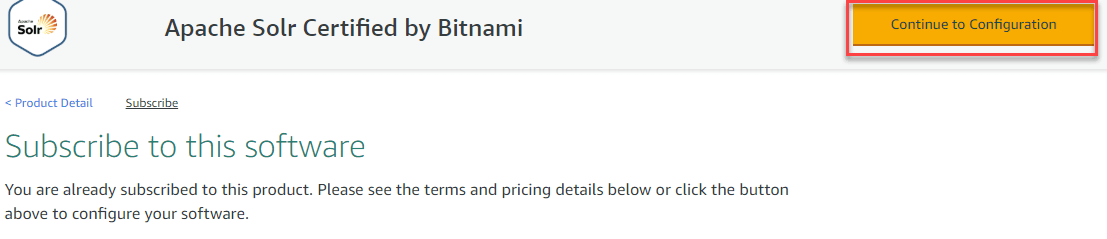
Krok 4) Przejdź do konfiguracji
Odśwież stronę i kliknij „Kontynuuj konfigurację”
Krok 5) Przejdź do uruchomienia
Zachowaj ustawienia domyślne i kliknij „Kontynuuj uruchamianie”.

Krok 6) Zachowaj ustawienia domyślne
Na następnej stronie Zachowaj ustawienia domyślne
- Upewnij się, że masz plik pem klucza
- Kliknij „Uruchom”

Zobaczysz ten komunikat o powodzeniu

Krok 7) Zwróć uwagę na publiczny DNS
W konsoli EC2 zanotuj publiczny DNS swojej instancji

Krok 8) Otwórz poniżej URL
Aby uzyskać dostęp do Solr, wystarczy użyć URL
http://publicdns:8983
w naszym przypadku tak się dzieje
http://ec2-18-221-175-53.us-east-2.compute.amazonaws.com:8983
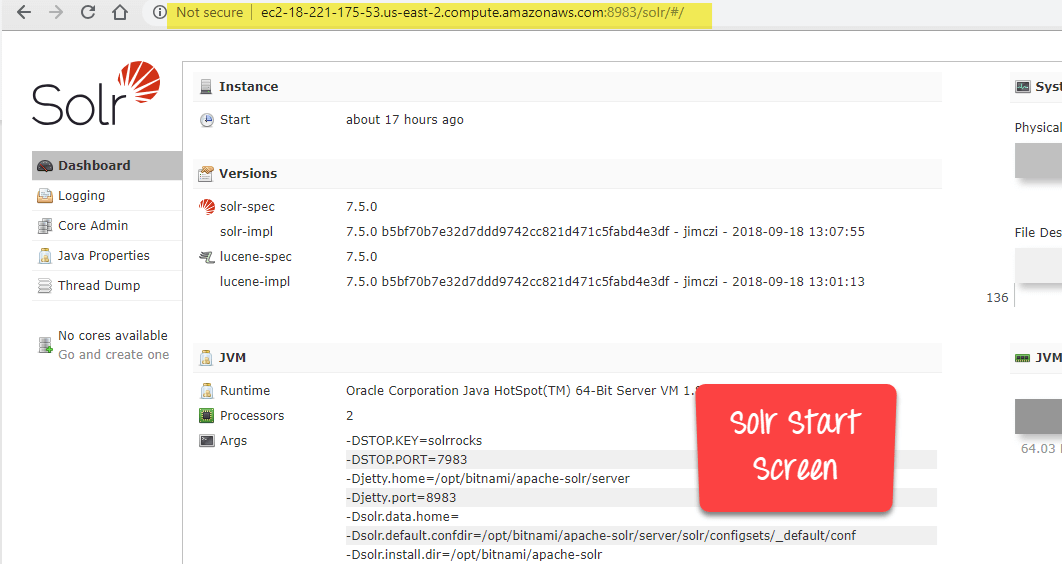
Uwaga: Jeśli masz problemy z dostępem do instancji, zmień reguły ruchu przychodzącego i wychodzącego w swojej instancji, aby zezwolić na cały ruch, jak pokazano w poniższym przykładzie zapytania Solr:

Elasticsearch kontra. Apache Solr
| Parametry | Apache Solr | Elastyczne wyszukiwanie |
|---|---|---|
| Nature | Jest to projekt open source. | Nie jest to projekt typu open source. |
| Stan statyczny | Statyczny w pliku shema.xml | Statyczne w Elasticsearch.yml |
| Format: | XML, CSV, JSON | Tylko JSON |
| wskaźnik | Można go ponownie załadować w czasie działania za pomocą przeładowania kolekcji/rdzenia | Zdefiniowane podczas tworzenia indeksu/typu za pomocą wywołania REST |
| Dokumenty | Jest to dobrze udokumentowane. | Jest źle udokumentowane. |
| Dzielenie odłamków | Możliwy | Niemożliwe |
Zalety Apache Solr
- Pomaga skrócić czas potrzebny na zlokalizowanie informacji
- To szybka, prosta, wydajna i elastyczna wyszukiwarka
- Pomaga zwiększyć dostępność produktów i usług
- Zwiększ wydatki klientów na aplikację internetową
- Pomaga poprawić komfort użytkowania aplikacji internetowej, aby zwiększyć przychody i zyski
- Kompleksowy interfejs administracyjny oparty na HTML
- Elastyczny i adaptowalny dzięki konfiguracji XML
- Rozszerzalna wtyczka Architektura
- Wysoce skalowalna, solidna i odporna na błędy wyszukiwarka
- Obsługuje rozproszone, cieniowanie, replikację, Clusteri wielowęzłowe Architektura
Wady Apache Solr
- Nie jest to magazyn danych zgodny z ACID
- Nie nadaje się jako główny magazyn danych. Przydatny tylko jako dodatkowy magazyn danych
- Nie oferuje obsługi transakcji i transakcji rozproszonych
- Brak obsługi połączeń i złożonych zapytań
- Nieoptymalne dla znormalizowanych danych
