
Hva er Star Schema i datavarehusmodellering?
 David Carter
⚡ Smart oppsummering
Stjerneskjema i datavarehusmodellering plasserer en sentral faktatabell i kjernen av omkringliggende dimensjonstabeller, og skaper en denormalisert, stjerneformet design som forenkler analytiske spørringer, fremskynder rapportering og driver OLAP-kuber på tvers av forretningsintelligensplattformer.
Hva er et stjerneskjema?
A stjerneskjema I et datavarehus er en modelleringsstruktur der én sentral faktatabell kobles til en rekke tilknyttede dimensjonstabeller. Det kalles et stjerneskjema fordi oppsettet ligner en stjerne, med faktatabellen i midten og dimensjonstabellene som stråler utover som punkter.
Stjerneskjemaet er den enkleste typen datavarehusskjema, og det er også kjent som stjernesammenkoblingsskjema. Fordi dimensjonstabellene er denormaliserte, er modellen optimalisert for spørring av svært store datasett, noe som gjør den til et vanlig valg for dimensjonal modellering og rapportering.
Hva er et flerdimensjonalt skjema?
A flerdimensjonalt skjema er spesielt utviklet for å modellere datavarehussystemer. Disse skjemaene dekker de unike behovene til svært store databaser som er bygget for analytiske formål OLAP snarere enn for rutinemessig transaksjonsbehandling.
Typer datavarehusskjemaer: Det finnes tre hovedtyper av flerdimensjonale skjemaer, og hver av dem har sine egne fordeler.
- Stjerneskjema – en sentral faktatabell koblet direkte til denormaliserte dimensjonstabeller.
- Snøfnuggskjema – en utvidelse av stjerneskjemaet der dimensjonene normaliseres til ytterligere underdimensjonstabeller.
- Galaxy-skjema – også kalt en faktakonstellasjon, den bruker flere faktatabeller som deler felles dimensjonstabeller.
Fordi snøfnuggskjemaet bygger direkte på stjerneskjemaet, er det nyttig å sammenligne de to modellene før man arbeider gjennom et detaljert eksempel på et stjerneskjema.
Stjerneskjema vs. snøfnuggskjema
Stjerneskjemaet og snøfnuggskjema Begge organiserer data rundt fakta- og dimensjonstabeller, men de lagrer dimensjonene på forskjellige måter. Et stjerneskjema holder hver dimensjon i en enkelt denormalisert tabell, mens et snøfnuggskjema normaliserer disse dimensjonene til flere relaterte tabeller.
- Struktur: Stjerneskjemaet er flatt og enkelt; snøfnuggskjemaet forgrener dimensjoner i underdimensjoner.
- Spørrehastighet: Stjerneskjemaer trenger færre koblinger, så spørringer kjører vanligvis raskere og SQL-en forblir enklere.
- Lagring: Snøfnuggskjemaer fjerner redundans, slik at de bruker mindre plass, men øker designkompleksiteten.
- Dataintegritet: Normaliserte snøfnuggdimensjoner fremhever integritet bedre, mens denormaliserte stjernedimensjoner favoriserer ytelse.
- Brukervennlighet: Et stjerneskjema er enklere for analytikere å forstå og raskere å vedlikeholde, mens et snøfnuggskjema krever mer nøye design.
I praksis velger team ofte et stjerneskjema for datamarts og dashbord som krever rask og enkel rapportering, og et snøfnuggskjema når lagringsbesparelser og streng konsistens er viktigere.
Eksempel på stjerneskjema
I det følgende stjerneskjemaeksemplet ligger faktatabellen i midten og inneholder nøklene til hver dimensjonstabell, for eksempel Dealer_ID, Model_ID, Date_ID, Product_ID og Branch_ID, sammen med målbare attributter som solgte enheter og omsetning.
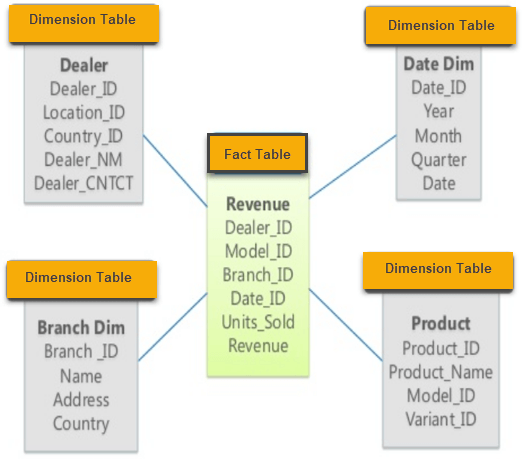
Hver omkringliggende dimensjonstabell legger til beskrivende kontekst til disse målingene, slik at en enkelt spørring kan gruppere eller filtrere salgsfakta etter forhandler, modell, dato, produkt eller filial uten å bli med i noen andre tabeller.
Faktatabeller
En faktatabell i et stjerneskjema inneholder fakta og er koblet til dimensjonene. En faktatabell inneholder to typer kolonner:
- En kolonne som lagrer fakta eller målinger.
- Fremmednøkler som lenker til hver dimensjonstabell.
Vanligvis er primærnøkkelen til en faktatabell en sammensatt nøkkel som består av alle fremmednøklene som utgjør tabellen.
Faktatabeller kan inneholde fakta på detaljnivå eller aggregerte fakta. Faktatabeller som inkluderer aggregerte fakta kalles ofte sammendragstabeller, og de inneholder vanligvis fakta som allerede er aggregert til et visst nivå.
Dimensjonstabeller
En dimensjon er en struktur som kategoriserer data i et hierarki. En dimensjon uten hierarkier og nivåer kalles en flat dimensjon eller liste. Primærnøkkelen til hver dimensjonstabell er en del av den sammensatte primærnøkkelen til faktatabellen.
Et dimensjonsattributt er et beskrivende, tekstlig attributt som bidrar til å beskrive en dimensjonsverdi, for eksempel et produktnavn eller en by. Fordi dimensjonstabeller lagrer denne beskrivende konteksten i stedet for transaksjonshendelser, er faktatabeller vanligvis mye større enn dimensjonstabeller.
Hvordan designe et stjerneskjema
Utforming av et stjerneskjema følger den dimensjonale modelleringsmetoden som ble popularisert av Ralph Kimball. Målet er å organisere forretningsmål rundt klare, gjenbrukbare dimensjoner, slik at den ferdige modellen er enkel å spørre om og rask å rapportere om. De fem trinnene nedenfor skisserer prosessen som de fleste dimensjonale modelleringsprosjekter følger, og går fra forretningsspørsmålet på høyeste nivå ned til de fysiske fakta- og dimensjonstabellene.
- Identifiser forretningsprosessen: Velg aktiviteten du vil analysere, for eksempel salg, forsendelseping, eller inventar. Denne avgjørelsen definerer hva faktatabellen skal måle.
- Deklarer kornet: Bestem detaljnivået som hver faktarad representerer, for eksempel én rad per linjeelement, per transaksjon eller per dag. En tydelig struktur holder modellen konsistent.
- Identifiser dimensjonene: List opp den beskrivende konteksten som er nødvendig for å dele opp fakta, for eksempel produkt, kunde, forhandler, filial og dato. Hver av dem blir en dimensjonstabell med attributter.
- Identifiser faktaene: Bestem de numeriske målene bedriften ønsker å track, for eksempel solgte enheter, inntekter eller kostnader, og plasser dem i den sentrale faktatabellen.
- Bygg stjernen: Koble faktatabellen til hver dimensjon ved hjelp av fremmednøkler, keeping Dimensjonene denormaliseres slik at diagrammet danner en enkelt sentral faktatabell omgitt av dimensjonene.
Etter at stjernen er bygget, legg til en surrogatnøkkel til hver dimensjon, sørg for at hver faktatabell har en tilknyttet datodimensjon, og bekreft at alle fakta er på samme nivå. Det er også god praksis å laste inn atomære data på laveste nivå først, fordi sammendragstabeller alltid kan utledes senere. Ved å følge disse reglene holdes skjemaet optimalisert for høy ytelse og enkelhet. datalager rapportering.
Kjennetegn ved stjerneskjema
- Hver dimensjon i et stjerneskjema er representert av bare én dimensjonstabell.
- Hver dimensjonstabell inneholder sitt eget sett med attributter.
- Dimensjonstabellen kobles til faktatabellen ved hjelp av en fremmednøkkel.
- Dimensjonstabellene er ikke koblet sammen.
- Faktatabellen inneholder nøkler og målinger.
- Stjerneskjemaet er lett å forstå og gir optimal diskutnyttelse.
- Dimensjonstabellene er ikke normalisert. I eksemplet ovenfor har for eksempel ikke Country_ID en separat oppslagstabell for land slik en OLTP designet ville.
- Skjemaet støttes i stor grad av BI-verktøy.
Fordeler med Star Schema
Stjerneskjemaet tilbyr flere fordeler som gjør det til et populært utgangspunkt for datavarehusdesign:
- Stjerneskjemaer bruker enklere sammenføyningslogikk enn andre skjemaer når de henter data fra svært normaliserte transaksjonskilder.
- Stjerneskjemaet forenkler vanlig forretningsrapporteringslogikk, for eksempel periode-over-periode- og per-per-periode-rapportering.
- Stjerneskjemaer brukes mye av OLAP-systemer for å bygge kuber effektivt, og et stjerneskjema kan tjene som en kilde uten å designe en kubestruktur i de fleste større OLAP-systemer.
- Ved å aktivere spesifikk ytelsesjustering som kan brukes på spørringer, kan spørreprosessoren tilby bedre utførelsesplaner.
Ulemper med stjerneskjema
- Fordi skjemaet er svært denormalisert, håndheves ikke dataintegriteten på en streng måte.
- Den er ikke fleksibel med tanke på avanserte analytiske behov.
- Stjerneskjemaer forsterker ikke mange-til-mange-relasjoner mellom forretningsenheter.
Når skal man bruke et stjerneskjema
Et stjerneskjema er det riktige valget når rask og forutsigbar spørreytelse er viktigere enn å spare lagringsplass. Fordi modellen holder dimensjonstabellene denormaliserte og antallet koblinger lavt, passer den til analytiske arbeidsbelastninger der forretningsbrukere gjentatte ganger kjører lignende rapporter, dashbord og aggregeringer over store mengder historiske data.
Typiske situasjoner der et stjerneskjema passer godt inn inkluderer:
- Datamarkeder: Avdeling datamarts med enkle, godt forståtte sammenhenger drar nytte av den lesbare strukturen.
- BI-dashbord: Business intelligence Verktøy kartlegges tydelig på stjerneskjemaer, slik at rapporter og visuelle elementer er raske å bygge.
- OLAP-kuber: Stjerneskjemaer er en naturlig kilde for OLAP-kuber, aggregering og del-og-terning-analyse.
Hvis prioriteten i stedet skifter mot minimal lagring, streng dataintegritet eller dype, skiftende hierarkier, kan et snøfnuggskjema eller et mer normalisert design fungere bedre. Mange team kombinerer til og med de to, og starter med et stjerneskjema og normaliserer bare dimensjonene som virkelig krever det.
