
T-test i R-programmering: Ett eksempel og paret eksempel
 Evelyn Clarke
⚡ Smart oppsummering
T-testen i R sammenligner gjennomsnitt ved hjelp av t.test()-funksjonen, som dekker ett utvalg mot et fast mål, to uavhengige grupper og parvise gjentatte målinger. Denne gjennomgangen kjører hver variant, leser p-verdien riktig og verifiserer de underliggende antagelsene.
Hva er statistisk slutning?
Statistisk inferens er kunsten å generere konklusjoner om fordelingen av data. En dataforsker står ofte overfor spørsmål som bare kan besvares vitenskapelig. Derfor er statistisk inferens en strategi for å teste om en hypotese er sann, dvs. validert av dataene.
En vanlig strategi for å vurdere en hypotese er t-testen, som forteller deg om to gjennomsnitt er like. Den er også kjent som StudenttestEn t-test kan beregnes for:
- En enkelt vektor mot en fast verdi (t-test med ett utvalg)
- To vektorer fra to separate grupper (uavhengig t-test med to utvalg)
- To vektorer målt på de samme forsøkspersonene (paret t-test)
Hver t-test antar at dataene er tilfeldig utvalgt og at verdiene (eller, for en paret test, forskjellene) kommer fra en tilnærmet normalfordelt populasjon. Den uavhengige versjonen med to utvalg antar i tillegg at de to gruppene er uavhengige av hverandre, og den klassiske formen antar at variansen deres er like.
Hva er T-Test i R-programmering?
Den grunnleggende ideen bak en T-Test er å bruke statistikk for å evaluere to motsatte hypoteser:
- H0nullhypotesen, at populasjonsgjennomsnittet er lik verdien som testes
- H1: den alternative hypotesen, at populasjonsgjennomsnittet er forskjellig fra den verdien
T-testen er utformet for små utvalgsstørrelser, der normaltilnærmingen er upålitelig. Den krever at dataene er tilnærmet normalfordelte.
T-testsyntaks i R
Den grunnleggende syntaksen for t.test() i R er:
t.test(x, y = NULL,
       mu = 0, var.equal = FALSE)
arguments:
- x : A vector to compute the one-sample t-test
- y: A second vector to compute the two sample t-test
- mu: Mean of the population under the null hypothesis
- var.equal: Specify whether the variances of the two vectors are equal. By default, set to `FALSE`
- paired: Set to `TRUE` when the two vectors are repeated measures on the same subjects
Før du kjører noe som helst, må du matche dataoppsettet med riktig variant av testen.
Typer T-test i R
Å velge feil variant er den vanligste t-testfeilen, så begynn med å matche dataoppsettet ditt med riktig kall.
| typen | Bruk den når | R-samtale |
|---|---|---|
| Én prøve | Én gruppe sammenlignet med en kjent målverdi | t.test(x, mu = verdi) |
| Uavhengig to-utvalg (Welch) | To separate grupper, varianser muligens ulik | t.test(x, y) |
| Uavhengig to-utvalg (samlet) | To separate grupper med lik varians | t.test(x, y, var.equal = TRUE) |
| Sammenkoblet | De samme forsøkspersonene ble målt to ganger | t.test(x, y, paret = SANN) |
| Ensidig | Du bryr deg bare om en forskjell i én retning | t.test(x, mu = verdi, alternativ = "større") |
Utover tre grupper er en t-test ikke lenger passende. Bytt til ANOVA test, som holder den totale feilraten på 5 prosent i stedet for å blåse den opp på tvers av gjentatte parvise sammenligninger.
Én prøve T-test i R
One Sample t-testen, eller elevens test, sammenligner gjennomsnittet av en vektor mot et teoretisk gjennomsnitt,  . Formelen som brukes for å beregne t-testen er:

Her
 refererer til gjennomsnittet
 til det teoretiske middelet
- s er standardavviket
- n antall observasjoner.
 refererer til gjennomsnittet
For å evaluere den statistiske signifikansen til t-testen, må du beregne p-verdien. De p-verdien varierer fra 0 til 1, og tolkes som følger:
- En p-verdi lavere enn 0.05 betyr at du kan forkaste nullhypotesen. Merk at det å forkaste H0 ikke er det samme som å bevise at H1 er sann, det betyr bare at dataene er usannsynlige under H0.
- En p-verdi høyere enn 0.05 indikerer at du ikke har nok bevis til å forkaste nullhypotesen.
Du kan konstruere p-verdien ved å se på den tilsvarende absolutte verdien til t-testen i Studentfordelingen med en frihetsgrader lik 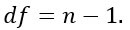
For eksempel, med 5 observasjoner sammenligner du t-verdien din mot Student-fordelingen med 4 frihetsgrader ved et konfidensnivå på 95 prosent. For å forkaste nullhypotesen i en tosidig test, må den absolutte t-verdien overstige 2.776.
Se tabellen nedenfor:

Ett eksempel på T-test i R
Anta at du er et selskap som produserer informasjonskapsler. Hver informasjonskapsel skal inneholde 10 gram sukker. Kakene produseres av en maskin som tilsetter sukkeret i en bolle før alt blandes. Du mener at maskinen ikke tilsetter 10 gram sukker for hver informasjonskapsel. Hvis antagelsen din er sann, må maskinen fikses. Du lagret sukkernivået til tretti informasjonskapsler.
Merknader: Du kan lage en randomisert vektor med funksjonen rnorm(). Denne funksjonen genererer normalfordelte verdier. Den grunnleggende syntaksen er:
rnorm(n, mean, sd)
arguments
- n: Number of observations to generate
- mean: The mean of the distribution. Optional
- sd: The standard deviation of the distribution. Optional
Du kan lage en fordeling med 30 observasjoner med et gjennomsnitt på 9.99 og et standardavvik på 0.04.
set.seed(123)
sugar_cookie <- rnorm(30, mean = 9.99, sd = 0.04)
head(sugar_cookie)
Utgang:
## [1] 9.967581 9.980793 10.052348 9.992820 9.995172 10.058603
Du kan bruke en en-prøve t-test for å sjekke om nivået av sukker er annerledes enn oppskriften. Du kan tegne en hypotesetest:
- H0: Gjennomsnittlig sukkernivå er lik 10
- H1: Gjennomsnittlig sukkernivå er annerledes enn 10
Du bruker et signifikansnivå på 0.05.
# H0 : mu = 10
t.test(sugar_cookie, mu = 10)
Her er utgangen:

P-verdien til t-testen med ett utvalg er 0.1079, over terskelen på 0.05. 95-prosents konfidensintervallet for gjennomsnittet går fra 9.973 til 10.002 gram, og det inneholder målverdien på 10. Du kan derfor ikke forkaste H0: det er ikke nok bevis for at maskinen avviker fra oppskriften.
Uavhengig to-utvalgs T-test i R
Den uavhengige t-testen med to utvalg er den mest brukte varianten, og den gjelder når de to settene med målinger kommer fra forskjellige forsøkspersoner: to verksteder, to maskiner, to behandlingsarmer.
Anta at en fabrikk kjører to produksjonslinjer, og du vil vite om de fyller glass med samme vekt.
set.seed(123)
line_a <- rnorm(25, mean = 500, sd = 8)
line_b <- rnorm(25, mean = 505, sd = 8)

# Welch test, the safe default
t.test(line_a, line_b)

# Pooled test, only when the variances are equal
t.test(line_a, line_b, var.equal = TRUE)
Les resultatet i fire trinn.
- t er den standardiserte størrelsen på gapet mellom de to gjennomsnittene. Fortegnet gjenspeiler bare rekkefølgen du sendte vektorene i.
- df er frihetsgradene. Welch produserer en brøkverdi; den samlede testen gir et helt tall lik n1 + n2 – 2.
- p-verdien er sannsynligheten for å se et så stort gap hvis de sanne gjennomsnittene var identiske.
- Konfidensintervall begrenser den sanne differansen. Når den inneholder null, er ikke differansen signifikant på det nivået.
Hvis dataene dine ligger i en enkelt dataramme med én kolonne med verdier og én faktorkolonne, bruk formelgrensesnittet i stedet, som er enklere å lese og unngår å dele dataene manuelt:
t.test(weight ~ line, data = jars)
Hvilken versjon som skal brukes. La var.equal stå på standardverdien FALSE med mindre du har testet og bekreftet like varianser. Welchs korreksjon koster nesten ingenting i kraft når variansene tilfeldigvis samsvarer, og den beskytter deg når de ikke gjør det.
Paret T-test i R
Den parede t-testen, også kalt den avhengige utvalgs-t-testen, gjelder når den samme gruppen måles to ganger. Typiske bruksområder er:
- A / B-testing: Sammenlign to varianter
- Case-kontrollstudierfør og etter en behandling av de samme forsøkspersonene
Paret T-testeksempel i R
Et drikkevareselskap er interessert i å vite ytelsen til et rabattprogram på salget. Selskapet bestemte seg for å følge det daglige salget til en av butikkene der programmet promoteres. På slutten av programmet ønsker bedriften å vite om det er en statistisk forskjell mellom gjennomsnittlig salg av butikken før og etter programmet.
- Selskapet tracsjekket salget hver dag før programmet startet. Dette er vår første vektor.
- Programmet promoteres i en uke og salget registreres hver dag. Dette er vår andre vektor.
- Du vil utføre t-testen for å bedømme effektiviteten til programmet. Dette kalles en paret t-test fordi verdiene til begge vektorene kommer fra samme fordeling (dvs. samme butikk).
Hypotesetestingen er:
- H0: Ingen forskjell i gjennomsnitt
- H1: De to virkemidlene er forskjellige
Husk at den klassiske t-testen antar en ukjent, men lik varians i begge gruppene. Reelle data tilfredsstiller sjelden dette nøyaktig, og å ignorere forskjellen kan forvrenge resultatet.
Løsningen er Welchs t-test, som løsner opp forutsetningen om lik varians. R bruker den som standard fordi var.equal er USANN med mindre du spesifiserer noe annet. I dette datasettet ble begge vektorene generert med samme standardavvik, så du kan trygt sette var.equal = SANN.
Du lager to tilfeldige vektorer fra en gaussisk fordeling med et høyere gjennomsnitt for salget etter programmet.
set.seed(123)
# sales before the program
sales_before <- rnorm(7, mean = 50000, sd = 50)
# sales after the program.This has higher mean
sales_after <- rnorm(7, mean = 50075, sd = 50)
# draw the distribution
t.test(sales_before, sales_after,var.equal = TRUE)

P-verdien er 0.04606, rett under terskelen på 0.05, så du forkaster H0 og konkluderer med at de to gjennomsnittene er betydelig forskjellige. Rabattprogrammet ser ut til å ha økt salget.
⚠️ Viktig: kallet ovenfor sammenligner de to vektorene som uavhengig prøver. Fordi begge seriene er målinger på samme verksted, legger det statistisk korrekte kallet til paret = SANN:
t.test(sales_before, sales_after, paired = TRUE)
Den parede formen tester gjennomsnittet av dag-for-dag-forskjellene i stedet for forskjellen mellom to gjennomsnitt. Den fjerner variasjonen på verkstednivå som deles av begge vektorene og har derfor mer statistisk styrke.
Slik sjekker du T-testforutsetninger i R
En t-test p-verdi er bare meningsfull når forutsetningene holder. Hver av dem har en direkte kontroll.
1. Normalitet. En-utvalgs- og to-utvalgstestene antar at verdiene er tilnærmet normale; den parede testen antar at forskjeller er. Inspiser et QQ-plott og bekreft med Shapiro-Wilk-testen:
qqnorm(sugar_cookie); qqline(sugar_cookie)
shapiro.test(sugar_cookie)

# for a paired design, test the differences
shapiro.test(sales_after - sales_before)
En Shapiro-Wilk p-verdi over 0.05 betyr at normaliteten ikke kan forkastes. Med mer enn omtrent 30 observasjoner per gruppe gjør den sentrale grensesetningen t-testen robust til moderat skjevhet uansett.
2. Lik varians. Bare den samlede testen med to utvalg trenger dette. Test den med en F-test:
var.test(line_a, line_b)
En p-verdi over 0.05 støtter like varianser, noe som rettferdiggjør at var.equal = TRUE.
3. Uavhengighet. Dette følger av studiedesignet og kan ikke testes i etterkant. Hvis samme forsøksperson bidrar til begge vektorene, er den uavhengige testen rett og slett feil verktøy, og du trenger paret = SANN.
Når en antagelse slår feil. For tydelig ikke-normale data med små utvalg, bruk de rangbaserte alternativene: wilcox.test(x, y) erstatter t-testen med to utvalg og wilcox.test(x, y, paret = TRUE) erstatter den parede versjonen. Ingen av dem krever normalitet, selv om begge utveksler litt kraft når dataene faktisk er normale.
T-test i R: Viktige poenger og testreferanser
- Statistisk slutning er kunsten å generere konklusjoner om fordelingen av dataene.
- T-testen tilhører familien av konklusjonsstatistikk. Det brukes ofte for å finne ut om det er en statistisk forskjell mellom gjennomsnittene for to grupper.
- En-utvalgs t-testen, eller Students test, sammenligner gjennomsnittet av en vektor med et teoretisk gjennomsnitt.
- Den parede t-testen, eller avhengige utvalgs-t-testen, gjelder når den samme gruppen måles to ganger.
Tabellen nedenfor oppsummerer hver test som er dekket ovenfor:
| Test | Hypotese å teste | p-verdien | Code | Valgfritt argument |
|---|---|---|---|---|
| en-prøve t-test | Gjennomsnittet av en vektor er forskjellig fra det teoretiske gjennomsnittet | 0.05 |
t.test(x, mu = mean)
|
|
| paret prøve t-test | Gjennomsnitt A er forskjellig fra gjennomsnitt B for de samme forsøkspersonene | 0.05 |
t.test(A, B, paired = TRUE) |
var.equal = TRUE
|
Hvis du er villig til å anta like varianser i en uavhengig test med to utvalg, sett var.equal = TRUE. La den stå på standardverdien FALSE for å kjøre den sikrere Welch-korreksjonen.
