
Hash-tabell i datastruktur: Python Eksempel
 Sarah Chen
⚡ Smart oppsummering
Hash-tabellen i datastrukturen lagrer verdier som nøkkel-verdi-par, og bruker en hash-funksjon til å tilordne hver nøkkel til en indeks for raskt oppslag. Denne ressursen forklarer hash-funksjoner, kollisjoner, kjedekobling, probing, operasjoner og Python eksempler, inkludert den innebygde ordboken.
Hva er Hashing?
En hash er en verdi som har en fast lengde, og den genereres ved hjelp av en matematisk formel. Hash-verdier brukes i datakomprimering, kryptologi osv. Ved dataindeksering brukes hash-verdier fordi de har fast lengde, uavhengig av verdiene som ble brukt til å generere dem. Det gjør at hashverdier opptar minimal plass sammenlignet med andre verdier av varierende lengde.
En hash-funksjon bruker en matematisk algoritme for å konvertere nøkkelen til en hash. En kollisjon oppstår når en hash-funksjon produserer samme hash-verdi for mer enn én nøkkel.
Hva er en Hash-tabell?
A HASH TABELL er en datastruktur som lagrer verdier ved hjelp av et par nøkler og verdier. Hver verdi er tildelt en unik nøkkel som genereres ved hjelp av en hash-funksjon.
Navnet på nøkkelen brukes for å få tilgang til den tilhørende verdien. Dette gjør det svært raskt å søke etter verdier i en hashtabell, uavhengig av antall elementer i hashtabellen.
Hash-funksjoner
For eksempel hvis vi ønsker å lagre ansattes poster, og hver ansatt er unikt identifisert ved hjelp av et ansattnummer.
Vi kan bruke ansattnummeret som nøkkel og tilordne ansattdataene som verdi.
Tilnærmingen ovenfor vil kreve ekstra ledig plass i størrelsesorden (m * n2) hvor variabelen m er størrelsen på matrise, og variabelen n er antall sifre for ansattnummeret. Denne tilnærmingen introduserer et problem med lagringsplass.
En hash-funksjon løser problemet ovenfor ved å hente ansattnummeret og bruke det til å generere en hash-heltallsverdi, faste sifre og optimalisere lagringsplass. Formålet med en hash-funksjon er å opprette en nøkkel som skal brukes til å referere til verdien vi ønsker å lagre. Funksjonen godtar verdien som skal lagres og bruker deretter en algoritme til å beregne verdien av nøkkelen.
Følgende er et eksempel på en enkel hash-funksjon
h(k) = k1 % m
HER,
- h(k) er hash-funksjonen som godtar en parameter k. Parameteren k er verdien vi ønsker å beregne nøkkelen for.
- k1 % m er algoritmen for hash-funksjonen vår der k1 er verdien vi ønsker å lagre, og m er størrelsen på listen. Vi bruker modulusoperatoren for å beregne nøkkelen.
Eksempel
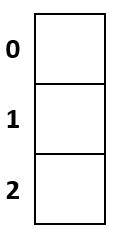
La oss anta at vi har en liste med en fast størrelse på 3 og følgende verdier
[1,2,3]
Vi kan bruke formelen ovenfor for å beregne posisjonene som hver verdi skal oppta.
Følgende bilde viser de tilgjengelige indeksene i hashtabellen vår.
Trinn 1) Beregn posisjonen som vil bli okkupert av den første verdien slik
h(1) = 1 % 3
= 1
Verdien 1 vil okkupere plassen på indeks 1
Trinn 2) Beregn posisjonen som vil bli okkupert av den andre verdien
h(2) = 2 % 3
= 2
Verdien 2 vil okkupere plassen på indeks 2
Trinn 3) Beregn posisjonen som vil bli okkupert av den tredje verdien.
h(3) = 3 % 3
= 0
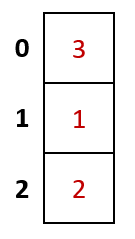
Verdien 3 vil okkupere plassen på indeks 0
Endelig resultat
Vår utfylte hash-tabell vil nå være som følger.
Kvaliteter ved en god hash-funksjon
En god hash-funksjon bør ha følgende egenskaper.
- Formelen for å generere hashen bør bruke dataverdien som skal lagres i algoritmen.
- Hash-funksjonen skal generere unike hash-verdier selv for inndata som har samme mengde.
- Funksjonen skal minimere antall kollisjoner. Kollisjoner oppstår når samme verdi genereres for mer enn én verdi.
- Verdiene må fordeles konsistent over alle mulige hashes.
kollisjon
En kollisjon oppstår når algoritmen genererer samme hash for mer enn én verdi.
La oss se på et eksempel.
Anta at vi har følgende liste over verdier
[3,2,9,11,7]
La oss anta at størrelsen på hash-tabellen er 7, og vi vil bruke formelen (k1 % m) hvor m er størrelsen på hashtabellen.
Tabellen nedenfor viser hash-verdiene som vil bli generert.
| nøkkel | Hash-algoritme (k1 % m) | Hash-verdi |
|---|---|---|
| 3 | 3% 7 | 3 |
| 2 | 2% 7 | 2 |
| 9 | 9% 7 | 2 |
| 11 | 11% 7 | 4 |
| 7 | 7% 7 | 0 |
Som vi kan se av resultatene ovenfor, har verdiene 2 og 9 samme hash-verdi, og vi kan ikke lagre mer enn én verdi ved hver posisjon.
Det gitte problemet kan løses ved enten å bruke kjetting eller sondering. De følgende avsnittene diskuterer kjetting og sondering i detalj.
Kjetting
Kjetting er en teknikk som brukes til å løse kollisjonsproblemet ved å bruke koblede lister som hver har unike indekser.
Følgende bilde visualiserer hvordan en lenket liste ser ut
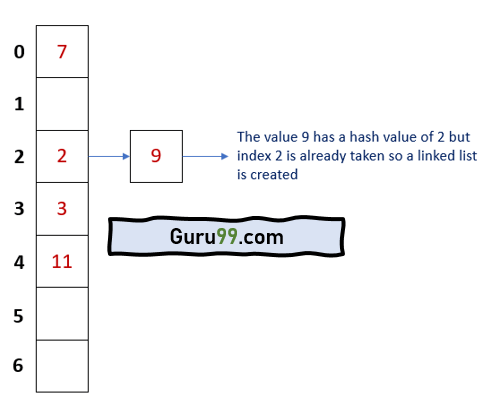
Både 2 og 9 opptar samme indeks, men de lagres som koblede lister. Hver liste har en unik identifikator.
Fordeler med lenkede lister
Følgende er fordelene med lenkede lister:
- Kjede lister har bedre ytelse når du setter inn data fordi rekkefølgen på innsetting er O(1).
- Det er ikke nødvendig å endre størrelse på en hashtabell som bruker en lenket liste.
- Den kan enkelt romme et stort antall verdier så lenge ledig plass er tilgjengelig.
Sonder
Den andre teknikken som brukes for å løse kollisjon er sondering. Når du bruker sonderingsmetoden, hvis en kollisjon oppstår, kan vi ganske enkelt gå videre og finne et tomt spor for å lagre verdien vår.
Følgende er metodene for sondering:
| Metode | Tekniske beskrivelser |
|---|---|
| Lineær sondering | Akkurat som navnet antyder, søker denne metoden etter tomme spor lineært fra posisjonen der kollisjonen skjedde og beveger seg fremover. Hvis slutten av listen er nådd og ingen tom plass blir funnet. Sonderingen starter ved begynnelsen av listen. |
| Kvadratisk sondering | Denne metoden bruker kvadratiske polynomuttrykk for å finne neste ledige ledige spor. |
| Double hashing | Denne teknikken bruker en sekundær hash-funksjonsalgoritme for å finne den neste ledige tilgjengelige spilleautomaten. |
Ved å bruke eksemplet ovenfor vil hashtabellen etter bruk av sondering se ut som følger:

Hash-tabelloperasjoner
Her er Operasjoner støttet av Hash-tabeller:
- Innsetting - dette Operation brukes til å legge til et element i hash-tabellen
- Søker - dette Operation brukes til å søke etter elementer i hashtabellen ved hjelp av nøkkelen
- slette - dette Operation brukes til å slette elementer fra hash-tabellen
Innsetting av dataoperasjon
Insert-operasjonen brukes til å lagre verdier i hash-tabellen. Når en ny verdi er lagret i hash-tabellen, blir den tildelt et indeksnummer. Indeksnummeret beregnes ved hjelp av hash-funksjonen. Hash-funksjonen løser eventuelle kollisjoner som oppstår ved beregning av indeksnummeret.
Søk etter datadrift
Søkeoperasjonen brukes til å slå opp verdier i hash-tabellen ved å bruke indeksnummeret. Søkeoperasjonen returnerer verdien som er knyttet til søkeindeksnummeret. For eksempel, hvis vi lagrer verdien 6 ved indeks 2, vil søkeoperasjonen med indeksnummer 2 returnere verdien 6.
Slett dataoperasjon
Sletteoperasjonen brukes til å fjerne en verdi fra en hash-tabell. For å slette Operasjonen gjøres ved å bruke indeksnummeret. Når en verdi er slettet, gjøres indeksnummeret gratis. Den kan brukes til å lagre andre verdier ved å bruke innsettingsoperasjonen.
Hash-tabellimplementering med Python Eksempel
La oss se på et enkelt eksempel som beregner hashverdien til en nøkkel
def hash_key( key, m):
    return key % m


m = 7

print(f'The hash value for 3 is {hash_key(3,m)}')
print(f'The hash value for 2 is {hash_key(2,m)}')
print(f'The hash value for 9 is {hash_key(9,m)}')
print(f'The hash value for 11 is {hash_key(11,m)}')
print(f'The hash value for 7 is {hash_key(7,m)}')
Hash-bord Code Forklaring
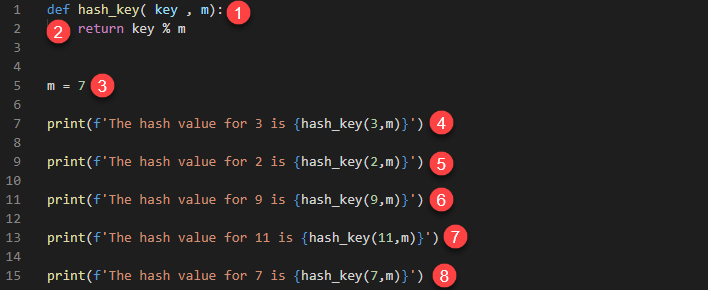
HER,
- Definerer en funksjon hash_key som aksepterer parameterne key og m.
- Bruker en enkel moduloperasjon for å bestemme hash-verdien
- Definerer en variabel m som initialiseres til verdien 7. Dette er størrelsen på hashtabellen vår
- Beregner og skriver ut hash-verdien til 3
- Beregner og skriver ut hash-verdien til 2
- Beregner og skriver ut hash-verdien til 9
- Beregner og skriver ut hash-verdien til 11
- Beregner og skriver ut hash-verdien til 7
Utførelse av koden ovenfor gir følgende resultater.
The hash value for 3 is 3
The hash value for 2 is 2
The hash value for 9 is 2
The hash value for 11 is 4
The hash value for 7 is 0
Python Ordbok eksempel
Python leveres med en innebygd datatype kalt Dictionary. En ordbok er et eksempel på en hashtabell. Den lagrer verdier ved hjelp av et par nøkler og verdier. Hash-verdiene genereres automatisk for oss, og eventuelle kollisjoner løses for oss i bakgrunnen.
Følgende eksempel viser hvordan du kan bruke en ordbokdatatype i python 3
employee = {
    'name': 'John Doe',
    'age': 36,
    'position': 'Business Manager.'
}

print (f"The name of the employee is {employee['name']}")
employee['position'] = 'Software Engineer'
print (f"The position of {employee['name']} is {employee['position']}")
employee.clear()

print (employee)
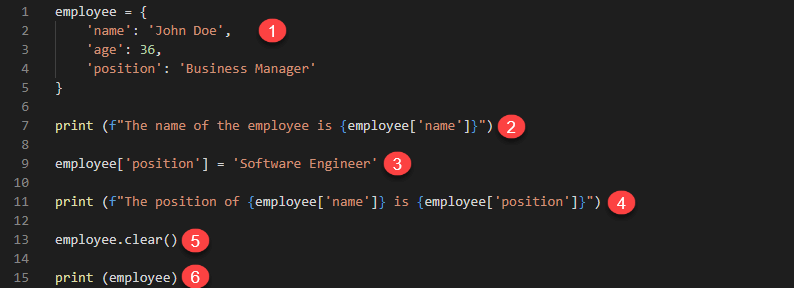
HER,
- Definerer en ansatt med ordbokvariabel. Nøkkelnavnet brukes til å lagre verdien John Doe, alder lagrer 36, og posisjon lagrer verdien Business Manager.
- Henter verdien av nøkkelnavnet og skriver det ut i terminalen
- Oppdaterer verdien av nøkkelposisjonen til verdien Software Engineer
- Skriver ut verdiene til nøklenes navn og posisjon
- Sletter alle verdiene som er lagret i vår ordbok variabel ansatt
- Skriver ut verdien av ansatt
Å kjøre koden ovenfor gir følgende resultater.
The name of the employee is John Doe.
The position of John Doe is a Software Engineer.
{}
Kompleksitetsanalyse
Hash-tabeller har en gjennomsnittlig tidskompleksitet på O (1) i beste tilfelle. Den verste tidskompleksiteten er O(n). Det verste tilfellet oppstår når mange verdier genererer samme hash-nøkkel, og vi må løse kollisjonen ved å sondere.
Virkelige applikasjoner
I den virkelige verden brukes hashtabeller til å lagre data for
- databaser
- Assosiative matriser
- sett
- Minnebuffer
Fordeler med hash-tabeller
Her er fordeler/fordeler med å bruke hashtabeller:
- Hash-tabeller har høy ytelse når du slår opp data, setter inn og sletter eksisterende verdier.
- Tidskompleksiteten for hashtabeller er konstant uavhengig av antall elementer i tabellen.
- De yter veldig bra selv når de jobber med store datasett.
Ulemper med hashtabeller
Her er ulempene ved å bruke hashtabeller:
- Du kan ikke bruke en nullverdi som nøkkel.
- Kollisjoner kan ikke unngås når du genererer nøkler ved hjelp av. hash-funksjoner. Kollisjoner oppstår når en nøkkel som allerede er i bruk genereres.
- Hvis hashing-funksjonen har mange kollisjoner, kan dette føre til at ytelsen reduseres.
