
Apache Solr Tutorial: Hva er Solr? Architecture
 David Carter
⚡ Smart oppsummering
Apache Solr er en åpen kildekode, Java-basert søkeserver bygget på Apache Lucene. Den indekserer store mengder tekstsentriske data og returnerer relevante resultater via REST API-er, og tilbyr fulltekstsøk, fasettering, skalerbarhet og både frittstående og SolrCloud-distribusjonsmoduser.
Hva er Apache Solr?
Apache Solr er en åpen kildekode søkeserverplattform skrevet i Java språk av Apache-programvarestiftelsen. Den er svært skalerbar og klar til å distribuere søkemotor for å håndtere et stort volum tekstsentriske data. Hensikten med å bruke Apache Solr er å indeksere og søke i store mengder nettinnhold og gi relevant innhold basert på søk.
Apache Solr er en REST-API-basert HTTP-innpakning rundt fulltekstsøkemotoren kalt Apache Lucene. En invertert indeks er en liste over ord der hver ordoppføring lenker til dokumentene den er lagret i. På den måten får du alle dokumenter for søket "guru99" med enkel 'get'-operasjon.
Historien om Apache Solr
- 1999: Doug Cutting publiserte Lucene
- 2004: Solr ble utviklet på CNET av Yonik Seeley som et delbedrifts internt prosjekt
- 2006: CNET publiserer kildekoden ved å donere den til Apache-programvaren Foundation
- 2008: Solr 1.3 ble utgitt med forbedrede søkefunksjoner og ytelsesforbedringer
- 2010: Sammenslåing av Lucene og Solr
- 2012: Solr versjon 4.0 ble utgitt, med ny Solr Cloud-funksjon
- 2016: Solr 6.0, ble utgitt som tilbyr støtte for utførelse av parallelle SQL-spørringer
- 2017: Solr 7.0 ble utgitt, med et autoskaleringsrammeverk og JSON Facet API.
- 2019: Solr 8.0 ble utgitt med støtte for nestede dokumenter og forbedrede strømmeuttrykk
- 2021: Lucene og Solr skilte seg igjen, og Solr ble et uavhengig Apache-toppprosjekt
- 2022: Solr 9.0 ble utgitt som den første versjonen uavhengig av Lucene, med støtte for vektorsøk og Kubernetes.
- 2026: Solr 10.0 ble utgitt som den nyeste hovedversjonen
Funksjoner i Apache Solr
Her er viktige funksjoner i Apache Solr:
- Automatisk lastbalansering
- Standardbaserte åpne grensesnitt – XML, JSON og HTTP
- Anbefalinger og staveforslag støttes
- Støtte for automatisk fullføring og geo-romlig søk
- Innebygd sikkerhet for autentisering og autorisasjon
- Lar deg utføre et flerspråklig nøkkelordsøk
- Autofullføring/Type-ahead Prediction
- Batch- og streaming-behandling
- Det er enkelt å bygge maskinlæringsmodeller
- Spesielt optimalisert for høyvolum netttrafikk
- Omfattende HTML-beundringsgrensesnitt
- Støtter både Schema og Schemaless konfigurasjon
- Fasettsøk og filtrering
- Sentral konfigurasjon for hele Cluster
Nøkkeltermer brukt i Apache Solr
Nå i denne Solr-søkemotoropplæringen vil vi lære om nøkkelbegreper som brukes i Apache Solr:
| Nøkkelbegrep | Tekniske beskrivelser |
|---|---|
| Solr Core | Solr Core kan defineres som en indeks av tekster og felt utledet fra alle dokumentene. Én Solr-instans kan ha én eller flere Solr-kjerner. Core = en instans av Lucene Index + Solr-konfigurasjon |
| Solr-forekomst | Solr Instance er en instans en Solr som kjører i Java Virtuell maskin (JVM). I frittstående modus tilbyr den bare én forekomst, mens du i skymodus kan ha én eller flere forekomster. |
| Indeksering | Indeksering er en metode for å legge dokumentets innhold til Solr Index. Apache Solr bruker Apache Lucene Inverted Index-teknikk. |
| Document | Det er en gruppe av felt og deres verdier. Et dokument er en grunnleggende enhet av data som er lagret i Apache Core. En Apache-kjerne kan inneholde ett eller flere dokumenter. |
| Felt | Feltet er et nøkkel-verdi-par som lagrer de faktiske dataene i et dokument. Nøkkel angir feltnavnet, og verdien som inneholder disse feltdataene. Et dokument kan ha ett eller flere felt. Det brukes av Apache Solr til å indeksere dokumentinnholdet. |
| Avslappende APIer | For å kommunisere med Solr er det ikke nødvendig å ha brukt Java programmering. I stedet tilbyr Apache Solr avslappende tjenester å kommunisere med det. Du kan sende dokumenter og motta resultater i ulike filformater som JSON, XML og CSV. |
| Fulltekstsøk | Solr tilbyr funksjoner for fulltekstsøk som tokens, setninger, stavekontroll, autofullføring, jokertegn, etc. |
| Administrasjonsgrensesnitt | Solr tilbyr et brukervennlig, brukervennlig, funksjonsdrevet brukergrensesnitt. Ved å bruke grensesnittet kan du utføre oppgaver som å administrere logger, legge til, slette, oppdatere og søke i dokumenter. |
| Tekstsentrisk og sortert etter relevans | Apache Solr brukes til å søke i tekstdokumenter, og resultatene leveres i henhold til brukerens forespørsel. |
| Node | I Solr-skyen er hver enkelt forekomst kjent som en node. |
| Cluster | En klynge er en samling av noder. |
| Samling | En klynge har en logisk indeks som også kalles en samling. |
| Shard | Det er et lite område av samlingen som tilbyr enkle eller flere kopier av indeksen. |
| Replica | En replika er en kopi av shard som kjører i en node. |
| Leder | Det er en kopi av shard, som sender forespørslene fra Solr Cloud for resten av replikaene. |
Apache Solr Architecture
Nå i denne Solr-søkeveiledningen, la oss lære om Apache Solr Archilære:

Apache Solr kompromitterer følgende komponenter
Query
Spørreparseren analyserer spørringene du må sende til Solr. Den verifiserer spørringen din for å sjekke syntaktiske feil. Etter at spørringene er analysert, oversettes de til et format som er kjent av Lucene.
Forespørselsbehandler
Forespørsler som sendes til Apache Solr behandles av forespørselsbehandleren. Forespørselen kan være en spørreforespørsel eller forespørsler om indeksoppdatering. Du må velge forespørselsbehandler i henhold til dine krav. For å sende en forespørsel til Solr må du tilordne behandleren til en spesifikk [enhet/prosess/etc.]. URL sluttpunkt.
Respons Writer
En svarskriver vil generere formaterte utdata for inndataspørringer. Den støtter ulike formater som XML, JSON, CSV.etc. Du kan ha forskjellige svarskrivere for forskjellige typer forespørsler.
Oppdateringsbehandler
Når du sender en oppdateringsforespørsel til Apache Solr, kjøres den gjennom et sett med plugins, signaturer, logging og indeksering. Denne prosessen er kjent som en oppdateringsforespørselsprosessor. Oppdateringsbehandleren er også ansvarlig for endringer som å legge til eller fjerneping innlevert, osv.
Apache Solr-applikasjoner
| Søknad | bruk |
|---|---|
| Intranettportal |
|
| Forent klient |
|
| Instrumentdatasett |
|
| Reguleringsdokumenter |
|
| Innebygd i PLM-applikasjonen |
|
Hvordan installerer jeg Apache Solr?
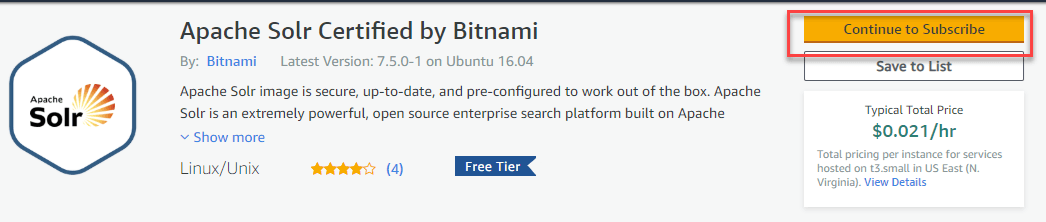
Trinn 1) Åpne nettsiden og fortsett å abonnere
Gå til dette link, Klikk "Fortsett å abonnere."
Trinn 2) Klikk på Godta vilkår
På neste side klikker du på Godta vilkår.

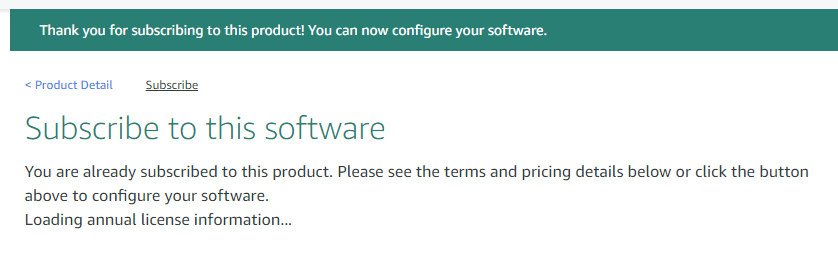
Trinn 3) Vent en stund
Deretter, vent en stund, og deretter blir forespørselen akseptert etter en stund.
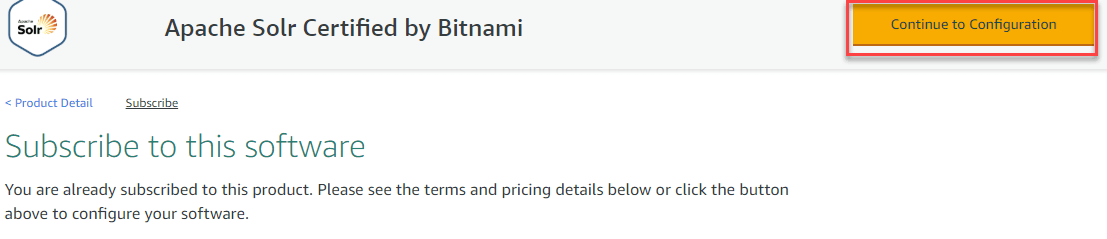
Trinn 4) Fortsett til konfigurasjon
Oppdater siden og klikk "Fortsett til konfigurasjon"
Trinn 5) Fortsett til Launch
Behold innstillingene som standard og klikk "Fortsett til lansering."

Trinn 6) Behold standardinnstillingene
På neste side, Behold standardinnstillingene
- Sørg for at du har nøkkelens pem-fil
- Klikk "Start"

Du vil se denne suksessmeldingen

Trinn 7) Legg merke til den offentlige DNS
I EC2-konsollen, legg merke til den offentlige DNS-en til forekomsten din

Trinn 8) Åpne nedenfor URL
For å få tilgang til Solr, bruk ganske enkelt URL
http://publicdns:8983
i vårt tilfelle blir det
http://ec2-18-221-175-53.us-east-2.compute.amazonaws.com:8983
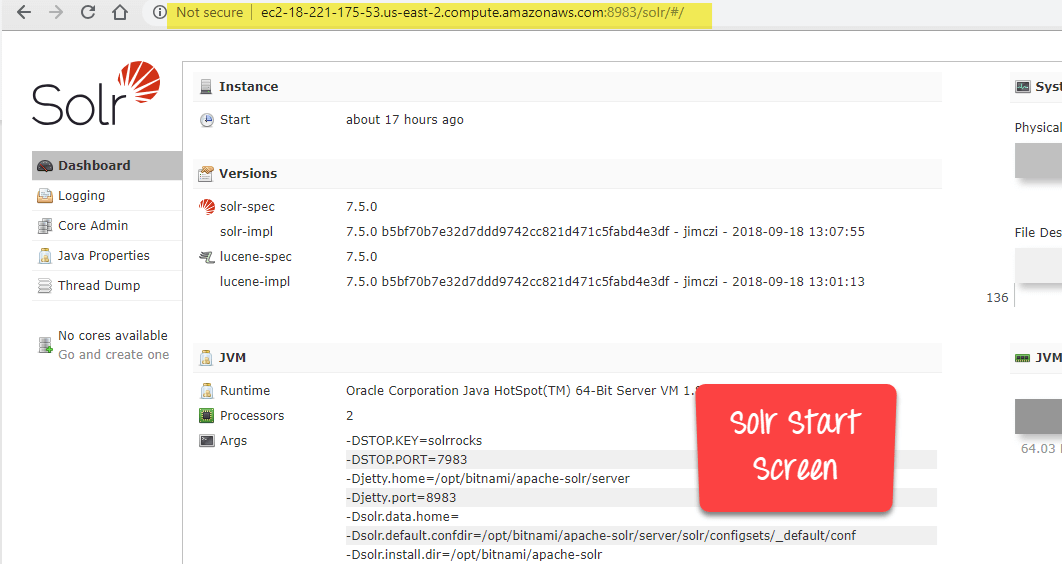
Merk: Hvis du har problemer med å få tilgang til forekomsten, endre inngående og utgående regler i forekomsten din for å tillate all trafikk som vist i eksempelet på Solr-spørringen nedenfor:

Elasticsearch vs. Apache Solr
| Parametre | Apache Solr | Elastisk søk |
|---|---|---|
| Natur | Det er et åpen kildekode-prosjekt. | Ikke et åpen kildekodeprosjekt. |
| Statisk status | Statisk i shema.xml | Statisk i elasticsearch.yml |
| dannet | XML, CSV, JSON | Bare JSON |
| Index | Kan lastes på nytt under kjøretid med samling/kjerneinnlasting | Definert under opprettelse av indeks/type med et REST-kall |
| Teknisk dokumentasjon | Det er godt dokumentert. | Det er dårlig dokumentert. |
| Splitting av skår | Mulig | Ikke mulig |
Fordeler med Apache Solr
- Hjelper deg med å redusere tiden det tar å finne informasjon
- Det er en rask, enkel, kraftig og fleksibel søkemotor
- Hjelper deg med å gjøre produktene og tjenestene dine mer tilgjengelige
- Øk kundenes forbruk på en nettapplikasjon
- Hjelper deg med å forbedre brukeropplevelsen på nettapplikasjonen for å øke inntekter og fortjeneste
- Omfattende HTML-basert administrasjonsgrensesnitt
- Fleksibel og tilpasningsdyktig med XML-konfigurasjon
- Utvidbar plugin Architecture
- Svært skalerbar, robust, feiltolerant søkemotor
- Støtter distribuert, skyggelegging, replikering, Clustering og Multi-Node Architecture
Ulemper med Apache Solr
- Det er ikke et ACID-kompatibelt datalager
- Det er ikke nyttig som et primært datalager. Kun nyttig som sekundær datalager
- Tilbyr ikke støtte for transaksjoner og distribuerte transaksjoner
- Støtter ikke sammenføyninger og komplekse søk
- Ikke optimalt for normaliserte data
