
Wat is Star Schema in Data Warehouse-modellering?
 David Carter
⚡ Slimme samenvatting
Bij het modelleren van datawarehouses met een sterschema wordt een centrale feitentabel in het hart van de omringende dimensietabellen geplaatst. Dit creëert een gedenormaliseerd, stervormig ontwerp dat analytische query's vereenvoudigt, rapportage versnelt en OLAP-kubussen in business intelligence-platforms ondersteunt.
Wat is een sterrenschema?
A ster schema Een sterschema is een modelleringsstructuur in een datawarehouse, waarbij één centrale feitentabel is gekoppeld aan een aantal bijbehorende dimensietabellen. Het wordt een sterschema genoemd omdat de lay-out op een ster lijkt, met de feitentabel in het midden en de dimensietabellen die als punten naar buiten uitstralen.
Het sterschema is het eenvoudigste type datawarehouse-schema en staat ook bekend als het ster-join-schema. Omdat de dimensietabellen gedenormaliseerd zijn, is het model geoptimaliseerd voor het opvragen van zeer grote datasets, waardoor het een veelgebruikte keuze is voor dimensionale modellering en rapportage.
Wat is een multidimensionaal schema?
A multidimensionaal schema is specifiek ontworpen om datawarehouse-systemen te modelleren. Deze schema's spelen in op de unieke behoeften van zeer grote databases die zijn gebouwd voor analytische doeleinden. OLAP in plaats van voor de routinematige verwerking van transacties.
Soorten datawarehouse-schema's: Er bestaan drie hoofdtypen multidimensionale schema's, en elk type biedt zijn eigen voordelen.
- Sterrenschema – een centrale feitentabel die direct is gekoppeld aan gedenormaliseerde dimensietabellen.
- Sneeuwvlokschema – een uitbreiding van het sterschema waarbij de dimensies worden genormaliseerd in extra subdimensietabellen.
- Melkwegschema – ook wel een feitenconstellatie genoemd, maakt gebruik van meerdere feitentabellen die gemeenschappelijke dimensietabellen delen.
Omdat het sneeuwvlokschema direct voortbouwt op het sterschema, is het nuttig om de twee modellen te vergelijken voordat je een gedetailleerd voorbeeld van een sterschema uitwerkt.
Sterrenschema versus sneeuwvlokschema
Het sterrenschema en de sneeuwvlok schema Beide schema's organiseren gegevens rond feiten- en dimensietabellen, maar ze verschillen in de manier waarop de dimensies worden opgeslagen. Een sterschema bewaart elke dimensie in een enkele gedenormaliseerde tabel, terwijl een sneeuwvlokschema die dimensies normaliseert in meerdere gerelateerde tabellen.
- Structuur: Het sterschema is plat en eenvoudig; het sneeuwvlokschema vertakt dimensies in subdimensies.
- Querysnelheid: Sterschema's vereisen minder joins, waardoor query's doorgaans sneller worden uitgevoerd en de SQL-code eenvoudiger blijft.
- Opslag: Snowflake-schema's elimineren redundantie, waardoor ze minder ruimte innemen, maar de ontwerpcomplexiteit vergroten.
- Data-integriteit: Genormaliseerde sneeuwvlokafmetingen zorgen voor een betere integriteit, terwijl gedenormaliseerde sterafmetingen de prestaties bevorderen.
- Gebruiksgemak: Een sterschema is eenvoudiger te begrijpen voor analisten en sneller te onderhouden, terwijl een sneeuwvlokschema een zorgvuldiger ontwerp vereist.
In de praktijk kiezen teams vaak voor een sterschema voor data marts en dashboards die snelle, eenvoudige rapportage vereisen, en een sneeuwvlokschema wanneer opslagbesparing en strikte consistentie belangrijker zijn.
Voorbeeld van een sterschema
In het volgende voorbeeld van een sterschema bevindt de feitentabel zich in het midden en bevat deze de sleutels tot elke dimensietabel, zoals Dealer_ID, Model_ID, Date_ID, Product_ID en Branch_ID, samen met meetbare kenmerken zoals verkochte eenheden en omzet.
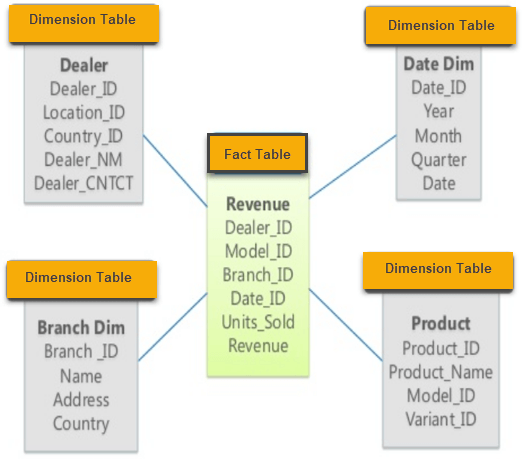
Elke omringende dimensietabel voegt beschrijvende context toe aan die meetwaarden, zodat een enkele query de verkoopgegevens kan groeperen of filteren op dealer, model, datum, product of vestiging zonder dat er andere tabellen hoeven te worden gekoppeld.
Feitentabellen
Een feitentabel in een sterschema bevat feiten en is verbonden met de dimensies. Een feitentabel bevat twee soorten kolommen:
- Een kolom waarin de feiten of meetwaarden worden opgeslagen.
- Vreemde sleutels die naar elke dimensietabel verwijzen.
Over het algemeen is de primaire sleutel van een feitentabel een samengestelde sleutel die bestaat uit alle externe sleutels waaruit de tabel is opgebouwd.
Feitentabellen kunnen gedetailleerde feiten of geaggregeerde feiten bevatten. Feitentabellen met geaggregeerde feiten worden vaak samenvattingstabellen genoemd en bevatten meestal feiten die al tot een bepaald niveau zijn geaggregeerd.
Dimensietabellen
Een dimensie is een structuur die gegevens in een hiërarchie categoriseert. Een dimensie zonder hiërarchieën en niveaus wordt een platte dimensie of lijst genoemd. De primaire sleutel van elke dimensietabel maakt deel uit van de samengestelde primaire sleutel van de feitentabel.
Een dimensiekenmerk is een beschrijvend, tekstueel kenmerk dat helpt bij het beschrijven van een dimensiewaarde, zoals een productnaam of een stad. Omdat dimensietabellen deze beschrijvende context opslaan in plaats van transactionele gebeurtenissen, zijn feitentabellen doorgaans veel groter dan dimensietabellen.
Hoe ontwerp je een sterschema?
Het ontwerpen van een sterschema volgt de dimensionale modelleringsaanpak die populair is gemaakt door Ralph Kimball. Het doel is om bedrijfsgegevens te organiseren rond duidelijke, herbruikbare dimensies, zodat het uiteindelijke model gemakkelijk te doorzoeken is en snel kan worden gerapporteerd. De vijf onderstaande stappen beschrijven het proces dat de meeste dimensionale modelleringsprojecten volgen, van de hoogste bedrijfsvraag tot de fysieke feiten- en dimensietabellen.
- Identificeer het bedrijfsproces: Kies de activiteit die u wilt analyseren, zoals verkoop of verzending.ping, ofwel inventaris. Deze beslissing bepaalt wat de feitentabel zal meten.
- Declareer het graan: Bepaal de mate van detail die elke rij met gegevens vertegenwoordigt, bijvoorbeeld één rij per regelitem, per transactie of per dag. Een duidelijke granulariteit zorgt voor consistentie in het model.
- Identificeer de afmetingen: Geef de beschrijvende context aan die nodig is om de feiten te segmenteren, zoals product, klant, dealer, vestiging en datum. Elk van deze elementen wordt een dimensietabel met attributen.
- Identificeer de feiten: Bepaal de numerieke meetwaarden die het bedrijf wil gebruiken. track, zoals verkochte eenheden, omzet of kosten, en plaats deze in de centrale feitentabel.
- Bouw de ster: Verbind de feitentabel met elke dimensie via externe sleutels.ping De dimensies zijn gedenormaliseerd, zodat het diagram een enkele centrale feitentabel vormt, omgeven door de dimensies.
Nadat de ster is opgebouwd, voegt u een surrogaatsleutel toe aan elke dimensie, zorgt u ervoor dat elke feitentabel een bijbehorende datumdimensie heeft en bevestigt u dat alle feiten zich op hetzelfde granulariteitsniveau bevinden. Het is ook een goede gewoonte om eerst atomaire gegevens op het laagste niveau te laden, omdat samenvattingstabellen later altijd kunnen worden afgeleid. Door deze regels te volgen, blijft het schema geoptimaliseerd voor hoge prestaties en eenvoud. datawarehouse rapportage.
Kenmerken van Star Schema
- Elke dimensie in een sterschema wordt weergegeven door slechts één dimensietabel.
- Elke dimensietabel bevat een eigen set attributen.
- De dimensietabel is via een externe sleutel aan de feitentabel gekoppeld.
- De dimensietabellen zijn niet aan elkaar gekoppeld.
- De feitentabel bevat sleutels en meetwaarden.
- Het sterschema is gemakkelijk te begrijpen en zorgt voor optimaal schijfgebruik.
- De dimensietabellen zijn niet genormaliseerd. In het bovenstaande voorbeeld heeft Country_ID bijvoorbeeld geen aparte opzoektabel voor landen, zoals een OLTP ontwerp zou.
- Het schema wordt breed ondersteund door BI-tools.
Voordelen van Star Schema
Het sterschema biedt diverse voordelen waardoor het een populair uitgangspunt is voor het ontwerp van datawarehouses:
- Sterschema's gebruiken een eenvoudigere join-logica dan andere schema's bij het ophalen van gegevens uit sterk genormaliseerde transactionele bronnen.
- Het sterschema vereenvoudigt de gangbare logica van bedrijfsrapportage, zoals rapportage over meerdere perioden en rapportage per datum.
- Sterschema's worden veelvuldig gebruikt door OLAP-systemen om kubussen efficiënt te bouwen, en in de meeste belangrijke OLAP-systemen kan een sterschema als bron dienen zonder dat er een kubusstructuur hoeft te worden ontworpen.
- Door specifieke prestatieoptimalisatie toe te passen op query's, kan de queryprocessor betere uitvoeringsplannen aanbieden.
Nadelen van het sterschema
- Omdat het schema sterk gedenormaliseerd is, wordt de data-integriteit niet streng afgedwongen.
- Het is niet flexibel als het gaat om geavanceerde analytische behoeften.
- Sterrenschema's versterken geen veel-op-veel-relaties tussen zakelijke entiteiten.
Wanneer een sterschema te gebruiken?
Een sterschema is de juiste keuze wanneer snelle, voorspelbare queryprestaties belangrijker zijn dan het besparen van opslagruimte. Omdat het model de dimensietabellen gedenormaliseerd houdt en het aantal joins laag, is het geschikt voor analytische workloads waarbij zakelijke gebruikers herhaaldelijk vergelijkbare rapporten, dashboards en aggregaties uitvoeren op grote hoeveelheden historische data.
Typische situaties waarin een sterschema goed van pas komt, zijn onder andere:
- Data marts: departementale datamarts Mensen met eenvoudige, goed begrepen relaties profiteren van de leesbare structuur.
- BI-dashboards: Business intelligence De tools kunnen netjes worden ingetekend op sterschema's, waardoor rapporten en visualisaties snel kunnen worden gemaakt.
- OLAP-kubussen: Sterschema's vormen een natuurlijke bron voor OLAP-kubussen, aggregatie en slice-and-dice-analyse.
Als de prioriteit verschuift naar minimale opslag, strikte gegevensintegriteit of diepe, veranderende hiërarchieën, dan is een sneeuwvlokschema of een meer genormaliseerd ontwerp wellicht geschikter. Veel teams combineren de twee zelfs, beginnend met een sterschema en normaliseren alleen de dimensies die dat echt nodig hebben.
