
Sneeuwvlokschema in datawarehouse-model
 David Carter
⚡ Slimme samenvatting
Het sneeuwvlokschema in datawarehouse-modellering rangschikt genormaliseerde dimensietabellen die vanuit een centrale feitentabel vertakken, als een sneeuwvlok. Het is een uitbreiding van het sterschema, vermindert gegevensredundantie en organiseert hiërarchieën over meerdere gerelateerde opzoektabellen.
Wat is een sneeuwvlokschema?
A Sneeuwvlokschema Een datawarehouse is een logische ordening van tabellen in een multidimensionale database waarvan de entiteit-relatiediagram (ER-diagram) Het lijkt op de vorm van een sneeuwvlok. Het is een dimensionaal model waarbij een centrale feitentabel gekoppeld is aan dimensietabellen, en die dimensietabellen verder zijn onderverdeeld in gerelateerde subdimensietabellen.
Het sneeuwvlokschema is een uitbreiding van het sterschema. Waar een sterschema elke dimensie in één platte tabel bewaart, normaliseert het sneeuwvlokschema die dimensies door herhalende groepen gegevens op te splitsen in extra opzoektabellen. Deze normalisatie verwijdert redundantie en creëert de vertakkende, hiërarchische structuur waaraan het schema zijn naam dankt.
Voorbeeld van een sneeuwvlokschema
In het volgende voorbeeld van een snowflake-schema staat een feitentabel met verkoopgegevens centraal, omringd door dimensies zoals Product, Datum en Winkel. In plaats van elk attribuut in één dimensietabel op te slaan, is de geografische informatie genormaliseerd, waardoor Land in een aparte tabel is geplaatst.

Hier verwijst de dimensie Winkel naar een tabel Stad, de tabel Stad verwijst naar een tabel Staat, en de tabel Staat verwijst naar een tabel Land. Elke waarde wordt slechts één keer opgeslagen en gekoppeld door een externe sleutel, zodat een landnaam nooit wordt herhaald in miljoenen rijen. Deze gelaagde normalisatie is wat een snowflake-schema onderscheidt van een plat ster-schema.
Kenmerken van Snowflake Schema
Het sneeuwvlokschema heeft een aantal bepalende kenmerken:
- Het neemt minder schijfruimte in beslag, omdat genormaliseerde dimensietabellen voorkomen dat herhaalde waarden worden opgeslagen.
- Met relatief weinig moeite kunnen nieuwe dimensies aan het schema worden toegevoegd.
- De queryprestaties kunnen afnemen, omdat het ophalen van gegevens het samenvoegen van veel tabellen vereist.
- Het vergt meer onderhoud, omdat er een groter aantal opzoektabellen beheerd moet worden.
Hoe ontwerp je een sneeuwvlokschema?
Het ontwerpen van een snowflake-schema begint op dezelfde manier als elk ander dimensionaal model, waarna een normalisatiestap wordt toegevoegd. Het doel is om het bedrijfsproces dat u wilt analyseren te identificeren, dit eerst te modelleren als een sterschema en vervolgens de dimensies met diepe hiërarchieën te normaliseren. Doorloop de volgende stappen:
- Identificeer het bedrijfsproces en de bijbehorende granulariteit. Bepaal wat een enkele rij in de feitentabel vertegenwoordigt, bijvoorbeeld één verkooptransactie, en definieer de numerieke meetwaarden, oftewel de feiten, waarover u wilt rapporteren.
- Stel de centrale feitentabel samen. Tel de numerieke waarden op bij de externe sleutels die naar elke dimensie verwijzen; samen vormen deze externe sleutels meestal de samengestelde primaire sleutel.
- Definieer de dimensietabellen. Maak voor elke beschrijvende dimensie, zoals Product, Klant, Datum en Winkel, een aparte tabel aan en wijs aan elke tabel een surrogaat primaire sleutel toe.
- Normaliseer de hiërarchieën. Splits elke dimensie met herhalende kenmerken op in subdimensietabellen, bijvoorbeeld door Categorie uit de Productdimensie te halen, of Stad, Provincie en Land uit de Winkeldimensie.
- Verbind de tabellen met behulp van externe sleutels. Koppel elke subdimensie terug aan de bijbehorende bovenliggende tabel, zodat de vertakkingen duidelijke één-op-veel-hiërarchieën vormen die op een sneeuwvlok lijken.
- Valideer en test met behulp van query's. Voer representatieve rapportagequery's uit om te bevestigen dat de joins de juiste resultaten opleveren en dat de algehele prestaties acceptabel blijven.
Omdat het ontwerp de gegevens normaliseert naar de derde normale vorm, is het belangrijk de verbindingspaden duidelijk te documenteren, zodat analisten begrijpen hoe ze door elke tak moeten navigeren. Nadat de structuur is gedefinieerd, is het de moeite waard om de voordelen van het schema af te wegen tegen de kosten.
Voordelen van het Snowflake-schema
Het sneeuwvlokschema biedt een aantal voordelen:
- Het voornaamste voordeel is de verminderde schijfruimte, omdat het samenvoegen van kleinere, genormaliseerde opzoektabelen voorkomt dat dimensiegegevens worden gedupliceerd.
- Het biedt een grotere schaalbaarheid in de relaties tussen componenten en dimensieniveaus.
- Het verwijdert redundantie, wat de data-integriteit verbetert en het model gemakkelijker te onderhouden maakt.
- Een beschrijvend attribuut wordt slechts op één plek bijgewerkt, waardoor het risico op inconsistente gegevens kleiner wordt.
Nadelen van het Snowflake-schema
Het ontwerp brengt echter ook compromissen met zich mee waar rekening mee moet worden gehouden:
- De genormaliseerde structuur verhoogt de onderhoudsbehoefte voor het beheren van veel gerelateerde tabellen.
- Complexe query's die meerdere joins omvatten, kunnen lastig te schrijven en te begrijpen zijn.
- Een groter aantal tabellen betekent meer joins, wat de uitvoeringstijd van de query verlengt.
- Zakelijke gebruikers vinden het vertakkingsmodel vaak lastiger te navigeren dan een eenvoudig sterschema.
Sneeuwvlokschema versus sterrenschema
Het sneeuwvlokschema en de ster schema Dit zijn de twee meest voorkomende multidimensionale ontwerpen in datawarehousing, en het belangrijkste verschil ertussen is normalisatie. Een sterschema houdt elke dimensie in één platte, gedenormaliseerde tabel voor maximale querysnelheid, terwijl een sneeuwvlokschema die dimensies normaliseert in verschillende gerelateerde tabellen om opslagruimte te besparen en de data-integriteit te beschermen. Hierdoor passen de twee schema's bij verschillende prioriteiten.
| Aspect | Sterrenschema | Sneeuwvlokschema |
|---|---|---|
| Dimensietabellen | Gedenormaliseerd, één tabel per dimensie | Genormaliseerd in subdimensietabellen |
| Opslag | Vereist meer ruimte vanwege redundantie. | Neemt minder ruimte in beslag, geen redundantie. |
| Prestaties opvragen | Sneller, minder verbindingen | Langzamer, meer verbindingen |
| Querycomplexiteit | Eenvoudig te schrijven | Complexer |
| Meest geschikt voor | Snelle rapportage en BI | Grote, hiërarchische dimensies |
Kortom, kies een sterschema wanneer querysnelheid en eenvoudige rapportage het belangrijkst zijn, en kies een sneeuwvlokschema wanneer opslagefficiëntie, overzichtelijke hiërarchieën en lage dataredundantie prioriteit hebben. Veel datawarehouses combineren beide patronen, afhankelijk van de grootte en diepte van elke dimensie.
Wanneer een Snowflake-schema te gebruiken?
Een snowflake-schema is niet altijd de juiste keuze, dus het is nuttig om het ontwerp af te stemmen op de werklast en de rapportagebehoeften. Het werkt doorgaans het beste in de volgende situaties:
- De dimensies zijn erg groot en bevatten veel herhalende attributen, waardoor er opslagruimte verloren gaat wanneer ze worden gedenormaliseerd.
- Dimensies hebben diepe, goed gedefinieerde hiërarchieën, zoals Regio naar Land naar Staat naar Stad, die op natuurlijke wijze worden weergegeven in afzonderlijke tabellen.
- De integriteit en consistentie van de gegevens zijn belangrijker voor het project dan de pure querysnelheid.
- Opslagkosten zijn een reële zorg en de besparing op schijfruimte bij zeer grote dimensietabellen is aanzienlijk.
- Het model voedt OLAP tools die efficiënt door genormaliseerde hiërarchieën kunnen navigeren.
Omgekeerd, wanneer snelle en eenvoudige rapportage voor bedrijfsanalisten prioriteit heeft, is een sterschema of een hybride sterclusterontwerp meestal de betere keuze. Veel datawarehouse-architecturen Bewust beide benaderingen combineren om een balans te vinden tussen snelheid en opslagcapaciteit.
Wat is een Galaxy-schema?
A Melkwegschema Het bevat twee of meer feitentabellen die dimensietabellen met elkaar delen. Het wordt ook wel een feitenconstellatieschema genoemd, en omdat het kan worden gezien als een verzameling sterren, heeft het de naam melkwegstelselschema gekregen.
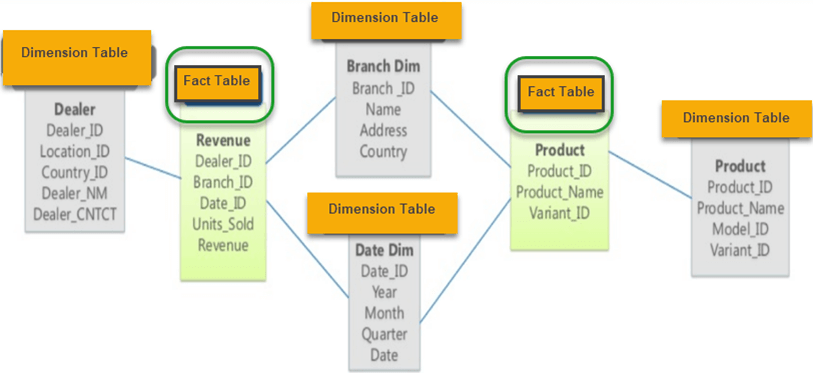
Zoals je in het bovenstaande voorbeeld kunt zien, zijn er twee feitentabellen:
- Revgevolg
- Product
In een galaxy-schema worden de dimensies die door de feitentabellen worden gedeeld, geharmoniseerde dimensies genoemd.
Kenmerken van Galaxy Schema
Het melkwegstelselschema heeft de volgende kenmerken:
- De dimensies worden op basis van de verschillende niveaus van de hiërarchie onderverdeeld in afzonderlijke categorieën.
- Als geografie bijvoorbeeld vier hiërarchische niveaus kent — regio, land, staat en stad — dan zou het galaxyschema vier dimensies moeten hebben.
- Het is mogelijk om dit type schema te construeren door een enkel sterschema op te splitsen in meerdere sterschema's.
- De dimensies in dit schema zijn groot en moeten worden opgebouwd volgens de niveaus van de hiërarchie.
- Het schema is handig voor het samenvoegen van feitentabellen, wat een betere analyse en een beter begrip mogelijk maakt.
Wat is ster Cluster Schema?
Een sneeuwvlokschema bevat volledig uitgevouwen hiërarchieën, wat de complexiteit kan verhogen en extra joins kan vereisen. Een sterschema daarentegen bevat volledig ingeklapte hiërarchieën, wat tot redundantie kan leiden. De beste oplossing is vaak een evenwicht tussen deze twee ontwerpen, bekend als een sterschema. Cluster Schema.
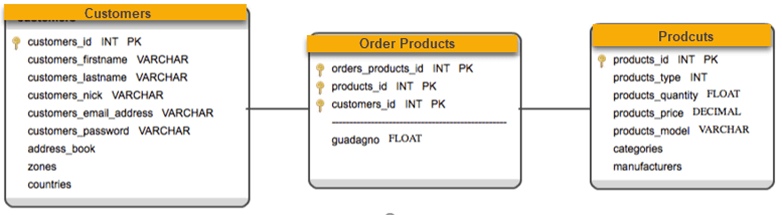
overlapping Dimensies verschijnen als vertakkingen in de hiërarchieën. Een vertakking ontstaat wanneer een entiteit als ouder fungeert in twee verschillende dimensionale hiërarchieën. Deze vertakkingsentiteiten worden vervolgens geïdentificeerd als classificaties met een één-op-veel-relatie, wat het aantal extra tabellen dat het ontwerp creëert, beperkt.
