
Wat is reinforcement learning? Soorten, Algorithms & Voorbeeld
 Evelien Clarke
⚡ Slimme samenvatting
Reinforcement learning is een machine learning-methode waarbij een softwareagent leert door te handelen binnen een omgeving, beloningen of straffen te verzamelen en zijn gedrag aan te passen om de cumulatieve beloning over vele stappen te maximaliseren.
Wat is versterkend leren?
Versterking leren is een Machine leren Een methode die zich bezighoudt met hoe softwareagenten acties moeten uitvoeren in een omgeving. De agent krijgt geen correcte antwoorden te zien; hij leert van de beloning die hij ontvangt en past zijn gedrag aan om de cumulatieve beloning te maximaliseren.
Reinforcement learning is een zelfstandige tak van machine learning, net als andere disciplines. toezicht en ongecontroleerd leren. Wanneer het beleid of de waardefunctie van de agent wordt weergegeven door een neuraal netwerk, wordt de combinatie genoemd diep versterkend leren — die combinatie is wat een agent in staat stelt een complex doel te bereiken of een specifieke dimensie te maximaliseren over meerdere stappen.
Belangrijke onderdelen van de versterkingsleermethode
Voordat de algoritmes begrijpelijk worden, is het handig om de onderdelen te benoemen. Het onderstaande diagram laat zien hoe de agent, de omgeving, de actie en het beloningssignaal in één lus samenkomen.
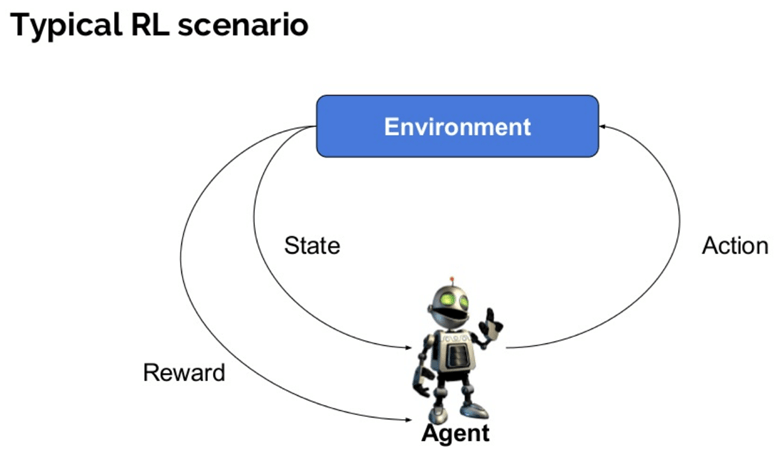
Hieronder volgen enkele belangrijke termen die gebruikt worden in reinforcement learning:
- Tussenpersoon: De entiteit die acties uitvoert in een omgeving om een bepaalde beloning te verkrijgen.
- Omgeving (e): Een scenario waarmee een agent te maken krijgt.
- Beloning (R): Een onmiddellijke beloning die een agent ontvangt wanneer deze een specifieke actie of taak uitvoert.
- Staat(en): Staat verwijst naar de huidige situatie die door de omgeving wordt geretourneerd.
- Beleid (π): De strategie die de agent toepast om de volgende actie te bepalen op basis van de huidige toestand.
- Waarde (V): Het verwachte rendement op lange termijn, inclusief korting, in vergelijking met de opbrengst op korte termijn.
- Waardefunctie: Het specificeert de waarde van een toestand, dat wil zeggen de totale hoeveelheid beloning die een agent kan verwachten te accumuleren vanaf die toestand.
- Model van de omgeving: Dit bootst het gedrag van de omgeving na. Het stelt je in staat conclusies te trekken en ook te bepalen hoe de omgeving zich zal gedragen.
- Modelgebaseerde methoden: Methoden die problemen met versterkingsleren oplossen door eerst een model van de omgeving te leren of te gebruiken, en vervolgens daarop te anticiperen.
- Q-waarde of actiewaarde (Q): De Q-waarde is vrijwel gelijk aan de waarde. Het enige verschil is dat er een extra parameter bij zit: de huidige actie.
Hoe werkt versterkend leren?
Een alledaagse analogie maakt het mechanisme duidelijk voordat er ook maar enige notatie verschijnt.
Stel je voor dat je je kat nieuwe trucjes wilt leren.
- Omdat de kat geen Engels of andere mensentaal begrijpt, kunnen we haar niet rechtstreeks vertellen wat ze moet doen. In plaats daarvan volgen we een andere strategie.
- We simuleren een situatie, en de kat probeert op verschillende manieren te reageren. Als de reactie van de kat de gewenste is, geven we haar vis.
- Wanneer de kat nu aan dezelfde situatie wordt blootgesteld, voert ze een soortgelijke actie nog enthousiaster uit, in de verwachting meer beloning (voedsel) te krijgen.
- Dat is hoe de kat leert "wat te doen" door middel van positieve ervaringen.
- Tegelijkertijd leert de kat ook wat hij niet moet doen als hij met negatieve ervaringen wordt geconfronteerd.
Voorbeeld van versterkend leren
De onderstaande afbeelding projecteert dat kattenverhaal op de formele lus, met het huishouden als omgeving en de vis als beloning.
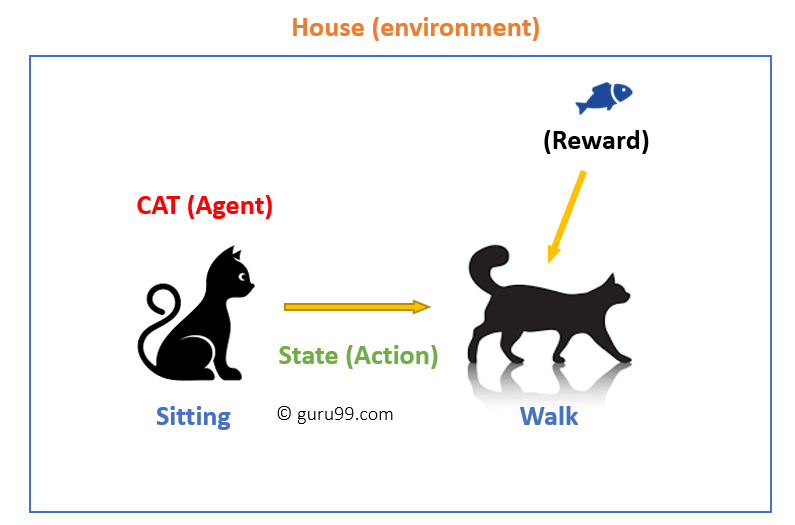
In dit geval,
- Je kat is een agent die blootgesteld is aan de omgeving. In dit geval is dat je huis. Een voorbeeld van een situatie zou kunnen zijn dat je kat zit en jij een specifiek woord gebruikt om de kat te laten lopen.
- Onze agent reageert door een actieovergang uit te voeren van de ene ‘staat’ naar de andere ‘staat’.
- Uw kat gaat bijvoorbeeld van zitten naar lopen.
- De reactie van een agent is een actie, en het beleid is een methode om een actie te selecteren in een bepaalde situatie, in afwachting van betere resultaten.
- Na de overgang kan de agent een beloning of een straf ontvangen.
Versterking leren Algorithms
Er zijn drie benaderingen voor het implementeren van een reinforcement learning-algoritme, die voornamelijk verschillen in wat de agent opslaat en leert.
Op waarde gebaseerd
Bij een waardegebaseerde versterkingsleermethode probeer je een waardefunctie V(s) te maximaliseren. In deze methode verwacht de agent een langetermijnrendement van de huidige toestanden onder beleid π.
Beleidsmatig
Bij een op beleid gebaseerde RL-methode probeer je een beleid te bedenken waarbij de actie die in elke toestand wordt uitgevoerd, je helpt om in de toekomst de maximale beloning te behalen.
Twee soorten beleidsgebaseerde methoden zijn:
- Deterministisch: Voor elke staat wordt dezelfde actie teweeggebracht door het beleid π.
- Stochastisch: Elke actie heeft een bepaalde waarschijnlijkheid, die wordt gegeven door de volgende vergelijking.
Stochastisch beleid:
π(a|s) = P[At = a | St = s]
Modelgebaseerd
Bij deze versterkingsleermethode creëer je een virtueel model voor elke omgeving. De agent leert hoe hij in die specifieke omgeving moet presteren.
Kenmerken van versterkend leren
Hieronder volgen belangrijke kenmerken van reinforcement learning:
- Er is geen toezichthouder, alleen een reëel nummer of beloningssignaal
- Sequentiële besluitvorming
- Tijd speelt een cruciale rol bij versterkingsproblemen
- Feedback is vaak vertraagd in plaats van direct.
- De acties van de agent bepalen de daaropvolgende gegevens die hij ontvangt
Soorten Reinforcement Learning
Het woord 'versterking' is afkomstig uit de gedragspsychologie en komt in twee vormen voor:
Positief:
Het wordt gedefinieerd als een gebeurtenis die plaatsvindt als gevolg van specifiek gedrag. Het versterkt en verhoogt de frequentie van het gedrag en heeft een positieve invloed op de actie die de persoon onderneemt.
Dit type bekrachtiging helpt je om de prestaties te maximaliseren en veranderingen langer vol te houden. Te veel bekrachtiging kan echter leiden tot overoptimalisatie van de toestand, wat de resultaten kan beïnvloeden.
Negatief:
Negatieve bekrachtiging wordt gedefinieerd als het versterken van gedrag dat optreedt als gevolg van een negatieve situatie die had moeten worden gestopt of vermeden. Het helpt bij het vaststellen van de minimale prestatienorm. Het nadeel van deze methode is echter dat het slechts voldoende bekrachtiging biedt om aan het minimale gedragspatroon te voldoen.
Leermodellen van versterking
Er zijn twee belangrijke leermodellen bij versterkend leren:
- Markov-beslissingsproces
- Q leren
Markov-beslissingsproces
Om een oplossing te verkrijgen, worden de volgende parameters gebruikt:
- Reeks acties – A
- Verzameling van toestanden – S
- Beloning – R
- Beleid – π
- Waarde – V
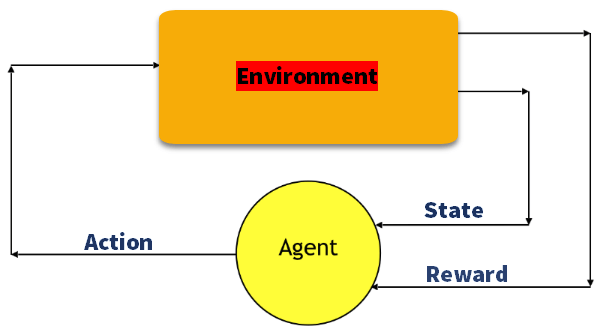
De wiskundige benadering voor de kaartping Een oplossing in reinforcement learning wordt geformaliseerd als een Markov Decision Process, ofwel MDP. Het onderstaande schema toont de vijf parameters die in dezelfde agent-omgeving-cyclus zijn verweven.
Q-leren
Q-learning is een waardegerichte methode om informatie te verstrekken die een agent vertelt welke actie hij moet ondernemen.
Laten we deze methode aan de hand van het volgende voorbeeld verduidelijken:
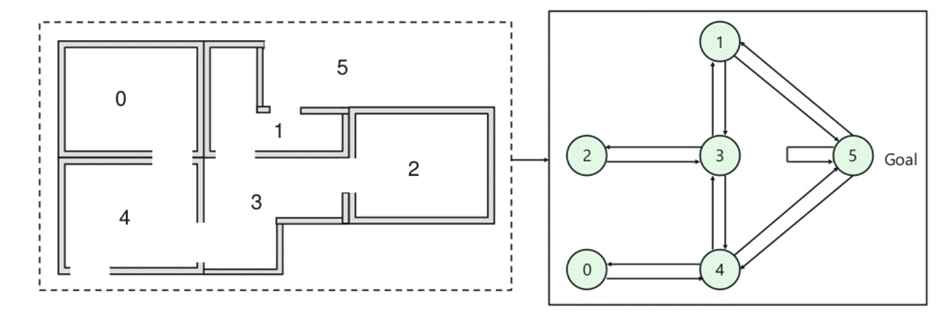
- Er zijn vijf kamers in een gebouw die met elkaar verbonden zijn door deuren.
- Elke kamer is genummerd van 0 tot 4.
- De buitenkant van het gebouw kan worden beschouwd als één grote buitenruimte (5)
- Deuren nummer 1 en 4 leiden vanuit kamer 5 naar het gebouw
De plattegrond hieronder nummert de kamers en laat zien welke deuren ze met elkaar verbinden.
Vervolgens moet je aan elke deur een beloningswaarde koppelen:
- Deuren die rechtstreeks naar het doel leiden, hebben een beloning van 100
- Deuren die niet direct verbonden zijn met de doelruimte leveren geen beloning op.
- Omdat de deuren aan twee kanten te openen zijn, zijn er twee pijlen toegewezen aan elke kamer.
- Elke pijl in de afbeelding hierboven heeft een directe beloningswaarde.
Uitleg: In deze afbeelding vertegenwoordigt elke kamer een toestand, en de beweging van de agent van de ene kamer naar de andere een actie.
In de onderstaande grafiek wordt een toestand weergegeven als een knooppunt, terwijl de pijlen de beschikbare acties en de bijbehorende beloning tonen.

Een agent loopt bijvoorbeeld van kamer nummer 2 naar kamer 5:
- Begintoestand = toestand 2
- Staat 2 -> staat 3
- Staat 3 -> staat (2,1,4)
- Staat 4-> staat (0,5,3)
- Staat 1-> staat (5,3)
- Staat 0 -> staat 4
Versterkend leren versus begeleid leren
De duidelijkste manier om reinforcement learning te plaatsen, is door het naast het paradigma te zetten dat de meeste lezers al kennen.
| Kenmerken | Versterking leren | Leren onder toezicht |
|---|---|---|
| Beslissingsstijl | Reinforcement Learning helpt je om je beslissingen in een bepaalde volgorde te nemen. | Bij deze methode wordt een beslissing genomen op basis van de invoer die aan het begin is gegeven. |
| werkt op | Werkt door interactie met de omgeving. | Werkt aan voorbeelden of gegeven voorbeeldgegevens. |
| Afhankelijkheid van beslissing | Bij de RL-methode is elke leerbeslissing afhankelijk van de beslissingen die eraan voorafgingen, waardoor de hele reeks beslissingen wordt geëvalueerd. | In leren onder toezicht De beslissingen zijn onafhankelijk van elkaar, dus krijgt elke beslissing een label. |
| Best geschikt | Werkt beter in AI-omgevingen waar menselijke interactie veel voorkomt. | Het wordt meestal bediend met een interactief softwaresysteem of applicaties. |
| Voorbeeld | Schaakspel | Object herkenning |
Toepassingen van Reinforcement Learning
Hier zijn toepassingen van Reinforcement Learning:
- Robotica voor industriële automatisering.
- Bedrijfsstrategieplanning
- Machine learning en gegevensverwerking
- Het helpt je bij het creëren van trainingssystemen die instructie en materialen op maat bieden, afgestemd op de behoeften van de studenten.
- Vliegtuigbesturing en bewegingsbesturing van robots
Waarom versterkend leren gebruiken?
Hier zijn de belangrijkste redenen om Reinforcement Learning te gebruiken:
- Het helpt je te bepalen in welke situatie actie nodig is.
- Helpt je ontdekken welke actie op de lange termijn het hoogste rendement oplevert.
- Reinforcement Learning voorziet de lerende agent ook van een beloningsfunctie.
- Het stelt de agent ook in staat om de beste methode te vinden om grote beloningen te behalen.
Wanneer mag u versterkend leren niet gebruiken?
Je kunt een reinforcement learning-model niet in elke situatie toepassen. Hier zijn enkele situaties waarin je er geen zou moeten gebruiken.
- Wanneer je voldoende gelabelde data hebt om het probleem op te lossen met een methode voor begeleid leren
- Reinforcement learning is rekenintensief en tijdrovend, vooral wanneer de actieruimte groot is.
Uitdagingen van versterkend leren
Hieronder vind je de belangrijkste uitdagingen waarmee je te maken krijgt bij het toepassen van reinforcement learning:
- Het ontwerpen van functies en beloningen, wat erg complex kan zijn.
- Parameters kunnen de leersnelheid beïnvloeden.
- Realistische omgevingen kunnen gedeeltelijk waarneembaar zijn.
- Te veel bekrachtiging kan leiden tot een overbelasting van de toestanden, wat de resultaten kan verminderen.
- Realistische omgevingen kunnen niet-stationair zijn.
