
Wat is hersteltesten? met Voorbeeld
 Thomas Hamilton
⚡ Slimme samenvatting
Hersteltesten verifiëren of software na een crash, een netwerkstoring of een hardwarefout de normale werking kan hervatten door het systeem te herstellen naar een bekend, goed functionerend punt en de transacties tot aan de storing opnieuw te verwerken.
Wat is hersteltesten?
Herstel testen Hersteltesten is een softwaretesttechniek die het vermogen van software om te herstellen van storingen, zoals software- of hardwarecrashes en netwerkstoringen, verifieert. Het doel van hersteltesten is om te bepalen of de software na een ramp of een integriteitsverlies kan worden voortgezet. Hersteltesten houdt in dat de software wordt teruggezet naar een punt waar de integriteit nog bekend was, en dat transacties tot aan het storingspunt opnieuw worden verwerkt.
In software engineering is herstelbaarheidstesten een type test. niet-functionele testen — Het omvat aspecten die niet aan een specifieke functie of gebruikersactie zijn gekoppeld, zoals schaalbaarheid of beveiliging. Het wordt uitgevoerd door professionele testers en er worden vooraf adequate back-upgegevens op veilige locaties bewaard.
Voorbeeld van hersteltest
Twee scenario's illustreren de techniek in zijn eenvoudigste vorm. In beide gevallen wordt opzettelijk een storing veroorzaakt, waarna de applicatie wordt geobserveerd terwijl deze weer opstart.
- Netwerkonderbreking: Terwijl een applicatie gegevens van het netwerk ontvangt, koppelt u de verbindingskabel los. Na enige tijd sluit u de kabel weer aan en analyseert u of de applicatie in staat is om vanaf het punt waar de verbinding werd verbroken, verder te gaan met het ontvangen van gegevens.
- Sessieherstel: Start het systeem opnieuw op terwijl een browser een bepaald aantal sessies open heeft staan en controleer of de browser ze allemaal herstelt.
De onderstaande afbeelding illustreert hetzelfde idee in visuele vorm.
De hersteltijd is afhankelijk van:
- Het aantal herstartpunten
- De hoeveelheid gegevens die de applicatie bevat.
- De opleiding en vaardigheden van de mensen die herstelactiviteiten uitvoeren, en de beschikbare hulpmiddelen voor herstel.
Bij meerdere storingen moet het herstelproces gestructureerd worden uitgevoerd, in plaats van alles tegelijk – eerst voor het ene segment en dan voor het andere.
Levenscyclus van herstelproces
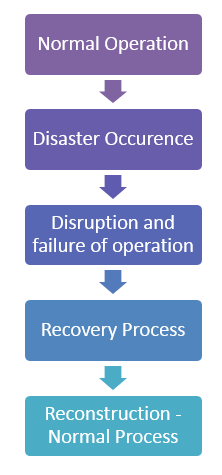
Voordat je testgevallen ontwerpt, is het handig om te kijken waar een hersteltest ingrijpt. De levenscyclus van het herstelproces bestaat uit vijf stappen:
- Normale operatie
- Het voorkomen van een ramp
- Verstoring en mislukking van de operatie
- Rampenbestrijding via het herstelproces
- Alle processen en informatie worden gereconstrueerd, waardoor het hele systeem weer normaal functioneert.
Het onderstaande stroomdiagram toont die vijf fasen in volgorde.
Laten we deze vijf stappen eens nader bekijken:
- Normale werking. Een systeem van hardware, software en firmware, geïntegreerd om een gemeenschappelijk doel te bereiken, voert de beoogde taak ongestoord uit binnen een vastgestelde tijdsperiode.
- Rampzalige gebeurtenis. Een storing kan optreden als gevolg van een defect in de software, door oorzaken zoals een door invoer veroorzaakte storing, een crash veroorzaakt door hardwarefalen of schade door brand, diefstal of staking.
- Verstoring en mislukking. Dit is de meest pijnlijke fase, die leidt tot zakelijke verliezen, verbroken relaties, gemiste kansen, verloren werkuren en, onvermijdelijk, financieel verlies en verlies van reputatie. Een rampenherstelplan minimaliseert deze fase.
- Rampenbestrijding. Als er al een back-upplan en risicobeheersingsprocessen aanwezig zijn, kost herstel veel minder tijd en moeite. Een speciaal team, met een vooraf gedefinieerde rol voor elk teamlid, zorgt voor een duidelijke verantwoordelijkheid en voorkomt een lange periode van verstoring.
- Wederopbouw. Dit kan meerdere bewerkingssessies vereisen om alle mappen en configuratiebestanden opnieuw op te bouwen. Goede documentatie en een gedefinieerd herstelproces zijn nodig voor een correct herstel.
Herstel Strategie
Het herstelteam moet een eigen strategie hebben voor het terughalen van belangrijke code en data om de normale bedrijfsvoering te hervatten. Die strategie is uniek voor elke organisatie, gebaseerd op de kritische aard van de systemen die beheerd worden, en voor kritieke systemen komt het neer op een aantal keuzes:
- Een enkele back-up, of meer dan één.
- Meerdere back-ups op één locatie, of op verschillende locaties.
- Online back-up of offline back-up
- Backups worden automatisch uitgevoerd op basis van een beleid, of handmatig geactiveerd.
- Een onafhankelijk restauratieteam, of het ontwikkelingsteam dat het werk uitvoert.
Elke keuze brengt kosten met zich mee, en meerdere back-ups kunnen meer fysieke middelen vergen of een apart team vereisen. Afhankelijkheid speelt ook een rol: bedrijven lopen risico door de code en data die ze bij één provider bewaren, en een grootschalige back-up kan ook een bedreiging vormen. AWS Door een storing zijn bekende consumentendiensten herhaaldelijk tegelijkertijd offline gegaan. Onafhankelijke herstelmogelijkheden zijn in dergelijke gevallen cruciaal.
Hersteltesten uitvoeren
De strategie is vastgesteld, de volgende vraag is hoe de test zelf wordt opgezet. De volgende punten moeten in acht worden genomen bij het uitvoeren van hersteltesten.
- Creëer een testomgeving die de daadwerkelijke implementatieomstandigheden zo goed mogelijk nabootst: de interface, het protocol, de firmware, de hardware en de software moeten overeenkomen met de productieomgeving.
- Hoewel uitgebreide tests tijdrovend en kostbaar kunnen zijn, is het toch raadzaam om een identieke configuratie te gebruiken en een volledige controle uit te voeren.
- Test indien mogelijk op de hardware waarop de back-up uiteindelijk zal worden hersteld, vooral wanneer u de back-up herstelt naar een andere machine dan die waarop de back-up is gemaakt.
- Sommige back-upsystemen verwachten dat de harde schijf exact dezelfde grootte heeft als de schijf waarvan de back-up is gemaakt.
- Beheer veroudering: schijftechnologie ontwikkelt zich snel en een oude schijf is mogelijk niet compatibel met een nieuwe. Herstellen naar een virtuele machine Dit is handig, omdat virtualisatiesoftware de bestaande hardware kan nabootsen, inclusief de schijfgrootte.
- Online back-upsystemen vormen geen uitzondering op de testprocedure. De meeste aanbieders beschermen gebruikers tegen problemen met de opslagmedia door middel van fouttolerante opslag, waardoor storingen pas laat aan het licht komen.
- Hoewel online back-upsystemen uiterst betrouwbaar zijn, moet het herstelproces worden getest om te bevestigen dat er geen problemen zijn met het ophalen, de beveiliging of de versleuteling.
Omdat het herstelproces van begin tot eind wordt uitgevoerd, worden deze runs meestal tegelijkertijd ingepland. systeem testen in plaats van op eenheidsniveau.
Testprocedure na restauratie
Het herstellen van de gegevens is slechts de helft van het werk; de herstelde kopie moet nog steeds bruikbaar blijken. De meeste grote bedrijven laten periodiek hersteloefeningen uitvoeren door onafhankelijke auditors. Een uitgebreid rampenherstelplan is duur om te onderhouden en te testen, dus kleinere organisaties vertrouwen vaak op back-ups en externe opslag.
Nadat mappen en bestanden zijn hersteld, bevestigen de volgende controles of ze correct zijn hersteld:
- Hernoem de map met het beschadigde document, zodat de herstelde kopie er niet mee verward kan worden.
- Tel het aantal bestanden in de herstelde mappen en vergelijk dat aantal met het aantal bestanden in de oorspronkelijke map.
- Open een paar bestanden met de applicatie die ze normaal gebruikt en controleer of de gegevens zoals gebruikelijk kunnen worden bekeken en bijgewerkt.
- Open meerdere bestanden van verschillende typen — afbeeldingen, MP3en documenten, sommige groot en sommige klein.
- Gebruik de hulpprogramma's voor het vergelijken van bestanden en mappen die de meeste gebruikers hebben. besturingssystemen voorzien.
