
T-toets in R-programmering: voorbeeld met één steekproef en voorbeeld met gepaarde steekproeven
 Evelien Clarke
⚡ Slimme samenvatting
De t-toets in R vergelijkt gemiddelden met behulp van de functie t.test(), waarbij één steekproef wordt vergeleken met een vaste doelwaarde, twee onafhankelijke groepen en gepaarde herhaalde metingen. Deze handleiding voert elke variant uit, leest de p-waarde correct af en controleert de onderliggende aannames.
Wat is statistische inferentie?
Statistische inferentie is de kunst om conclusies te trekken over de verdeling van gegevens. Een datawetenschapper wordt vaak geconfronteerd met vragen die alleen wetenschappelijk beantwoord kunnen worden. Statistische inferentie is daarom een strategie om te testen of een hypothese waar is, oftewel of deze door de gegevens wordt bevestigd.
Een veelgebruikte strategie om een hypothese te toetsen is de t-toets, die aangeeft of twee gemiddelden gelijk zijn. Deze toets staat ook bekend als de StudententoetsEen t-test kan worden berekend voor:
- Een enkele vector tegen een vaste waarde (éénsteekproef t-test)
- Twee vectoren uit twee afzonderlijke groepen (onafhankelijke t-toets voor twee steekproeven)
- Twee vectoren gemeten bij dezelfde proefpersonen (gepaarde t-test)
Elke t-test gaat ervan uit dat de gegevens willekeurig zijn verzameld en dat de waarden (of, bij een gepaarde test, de verschillen) afkomstig zijn uit een bij benadering normaal verdeelde populatie. De onafhankelijke tweesteekproefvariant gaat er bovendien van uit dat de twee groepen onafhankelijk van elkaar zijn, en de klassieke variantie gaat ervan uit dat hun varianties gelijk zijn.
Wat is T-Test in R-programmering?
Het basisidee achter een T-Test is om statistieken te gebruiken om twee tegengestelde hypothesen te evalueren:
- H0De nulhypothese stelt dat het populatiegemiddelde gelijk is aan de te testen waarde.
- H1: de alternatieve hypothese, dat het populatiegemiddelde verschilt van die waarde
De t-toets is ontworpen voor kleine steekproefgroottes, waar de normale benadering onbetrouwbaar is. De toets vereist dat de gegevens bij benadering normaal verdeeld zijn.
T-Test-syntaxis in R
De basissyntaxis voor t.test() in R is:
t.test(x, y = NULL,
       mu = 0, var.equal = FALSE)
arguments:
- x : A vector to compute the one-sample t-test
- y: A second vector to compute the two sample t-test
- mu: Mean of the population under the null hypothesis
- var.equal: Specify whether the variances of the two vectors are equal. By default, set to `FALSE`
- paired: Set to `TRUE` when the two vectors are repeated measures on the same subjects
Voordat je iets uitvoert, zorg ervoor dat je de gegevensindeling aanpast aan de juiste variant van de test.
Soorten T-toetsen in R
Het kiezen van de verkeerde variant is de meest voorkomende fout bij t-toetsen, dus begin met het afstemmen van uw data-indeling op de juiste variant.
| Type | Gebruik het wanneer | R-oproep |
|---|---|---|
| Eén voorbeeld | Eén groep vergeleken met een bekende streefwaarde | t.test(x, mu = waarde) |
| Onafhankelijke tweesteekproef (Welch) | Twee afzonderlijke groepen, mogelijk ongelijke varianties | t-test(x, y) |
| Onafhankelijke tweesteekproef (gepoolde) | Twee afzonderlijke groepen met gelijke variantie | t.test(x, y, var.equal = TRUE) |
| Gekoppelde | Dezelfde proefpersonen werden tweemaal gemeten. | t.test(x, y, paired = TRUE) |
| Eenzijdig | Het gaat jou alleen om een verschil in één richting. | t.test(x, mu = waarde, alternatief = “groter”) |
Bij meer dan drie groepen is een t-test niet langer geschikt. Schakel over naar de ANOVA-test, waardoor het totale foutenpercentage op 5 procent blijft in plaats van dat het toeneemt door herhaalde paarsgewijze vergelijkingen.
Eén voorbeeld van een T-test in R
De One Sample t-test, of studententest, vergelijkt het gemiddelde van een vector met een theoretisch gemiddelde,  . De formule die wordt gebruikt om de t-toets te berekenen is:

Hier
 verwijst naar het gemiddelde
 naar het theoretisch gemiddelde
- s is de standaarddeviatie
- n het aantal waarnemingen.
 verwijst naar het gemiddelde
Om de statistische significantie van de t-toets te evalueren, moet u de p-waarde. De p-waarde varieert van 0 tot 1 en wordt als volgt geïnterpreteerd:
- Een p-waarde lager dan 0.05 betekent dat je de nulhypothese kunt verwerpen. Merk op dat het verwerpen van H0 niet hetzelfde is als het bewijzen van H1; het betekent alleen dat de data onwaarschijnlijk zijn onder H0.
- Een p-waarde hoger dan 0.05 geeft aan dat er onvoldoende bewijs is om de nulhypothese te verwerpen.
Je kunt de p-waarde construeren door te kijken naar de overeenkomstige absolute waarde van de t-toets in de Student-verdeling met een vrijheidsgraad gelijk aan 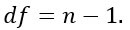
Stel, met 5 waarnemingen vergelijkt u uw t-waarde met de Student-verdeling met 4 vrijheidsgraden en een betrouwbaarheidsniveau van 95 procent. Om de nulhypothese te verwerpen in een tweezijdige toets, moet de absolute t-waarde groter zijn dan 2.776.
Zie onderstaande tabel:

Eén voorbeeld van een T-testvoorbeeld in R
Stel dat u een bedrijf bent dat cookies produceert. Elk koekje zou 10 gram suiker moeten bevatten. De koekjes worden geproduceerd door een machine die de suiker in een kom toevoegt voordat alles wordt gemengd. Je denkt dat de machine niet voor elk koekje 10 gram suiker toevoegt. Als uw veronderstelling waar is, moet de machine worden gerepareerd. Je hebt het suikerniveau van dertig koekjes opgeslagen.
Note: U kunt een gerandomiseerde vector maken met de functie rnorm(). Deze functie genereert normaal verdeelde waarden. De basissyntaxis is:
rnorm(n, mean, sd)
arguments
- n: Number of observations to generate
- mean: The mean of the distribution. Optional
- sd: The standard deviation of the distribution. Optional
Je kunt een verdeling maken met 30 waarnemingen met een gemiddelde van 9.99 en een standaarddeviatie van 0.04.
set.seed(123)
sugar_cookie <- rnorm(30, mean = 9.99, sd = 0.04)
head(sugar_cookie)
Output:
## [1] 9.967581 9.980793 10.052348 9.992820 9.995172 10.058603
Met een one-sample t-test kunt u controleren of het suikergehalte afwijkt van het recept. Je kunt een hypothesetest maken:
- H0: Het gemiddelde suikergehalte is gelijk aan 10
- H1: Het gemiddelde suikergehalte is anders dan 10
U hanteert een significantieniveau van 0.05.
# H0 : mu = 10
t.test(sugar_cookie, mu = 10)
Dit is de uitvoer:

De p-waarde van de t-toets voor één steekproef is 0.1079, boven de drempelwaarde van 0.05. Het 95%-betrouwbaarheidsinterval voor het gemiddelde loopt van 9.973 tot 10.002 gram en omvat de streefwaarde van 10. U kunt H0 daarom niet verwerpen: er is onvoldoende bewijs dat de machine afwijkt van het recept.
Onafhankelijke t-toets voor twee steekproeven in R
De onafhankelijke t-test voor twee steekproeven is de meest gebruikte variant en is van toepassing wanneer de twee sets metingen afkomstig zijn van verschillende proefpersonen: twee winkels, twee machines, twee behandelingsgroepen.
Stel, een fabriek heeft twee productielijnen en je wilt weten of ze de potten tot hetzelfde gewicht vullen.
set.seed(123)
line_a <- rnorm(25, mean = 500, sd = 8)
line_b <- rnorm(25, mean = 505, sd = 8)

# Welch test, the safe default
t.test(line_a, line_b)

# Pooled test, only when the variances are equal
t.test(line_a, line_b, var.equal = TRUE)
Lees de uitvoer in vier stappen.
- t is de gestandaardiseerde grootte van het verschil tussen de twee gemiddelden. Het teken ervan geeft alleen de volgorde weer waarin je de vectoren hebt doorgegeven.
- df is het aantal vrijheidsgraden. Welch produceert een fractionele waarde; de gepoolde test geeft een geheel getal gelijk aan n1 + n2 – 2.
- p-waarde Wat is de kans om zo'n groot verschil te zien als de werkelijke gemiddelden identiek zouden zijn?
- Betrouwbaarheidsinterval begrenst het werkelijke verschil. Wanneer het nul bevat, is het verschil op dat niveau niet significant.
Als uw gegevens zich in één dataframe bevinden met één kolom met waarden en één kolom met factoren, gebruik dan de formule-interface. Deze is gemakkelijker te lezen en voorkomt dat u de gegevens handmatig moet splitsen.
t.test(weight ~ line, data = jars)
Welke versie te gebruiken? Laat var.equal op de standaardwaarde FALSE staan, tenzij u hebt getest en bevestigd dat de varianties gelijk zijn. De correctie van Welch kost vrijwel niets aan stroomverbruik wanneer de varianties toevallig overeenkomen, en beschermt u wanneer dit niet het geval is.
Gepaarde T-test in R
De gepaarde t-toets, ook wel de t-toets voor afhankelijke steekproeven genoemd, wordt gebruikt wanneer dezelfde groep tweemaal wordt gemeten. Typische toepassingen zijn:
- A/B-testing: Vergelijk twee varianten
- Casus-controleonderzoeken: voor en na een behandeling bij dezelfde proefpersonen
Gepaard T-Testvoorbeeld in R
Een drankenbedrijf wil graag weten hoe een kortingsprogramma presteert op de verkoop. Het bedrijf besloot de dagelijkse verkoop te volgen van een van zijn winkels waar het programma wordt gepromoot. Aan het einde van het programma wil het bedrijf weten of er een statistisch verschil is tussen de gemiddelde verkoop van de winkel voor en na het programma.
- het bedrijf tracWe hebben de dagelijkse verkoopcijfers bijgehouden voordat het programma van start ging. Dit is onze eerste vector.
- Het programma wordt een week lang gepromoot en de verkopen worden elke dag geregistreerd. Dit is onze tweede vector.
- Om de effectiviteit van het programma te beoordelen, voer je de t-test uit. Dit wordt een gepaarde t-toets genoemd omdat de waarden van beide vectoren uit dezelfde verdeling komen (dwz uit dezelfde winkel).
Het testen van de hypothese is:
- H0: Geen verschil in gemiddelde
- H1: De twee middelen zijn verschillend
Houd er rekening mee dat de klassieke t-toets uitgaat van een onbekende maar gelijke variantie in beide groepen. In de praktijk voldoen gegevens zelden exact aan die voorwaarde, en het negeren van dit verschil kan de uitkomst vertekenen.
De oplossing is de t-toets van Welch, die de aanname van gelijke variantie versoepelt. R past deze standaard toe omdat `var.equal` op `FALSE` staat, tenzij je anders aangeeft. In deze dataset zijn beide vectoren gegenereerd met dezelfde standaarddeviatie, dus je kunt `var.equal` gerust op `TRUE` zetten.
Je maakt twee willekeurige vectoren uit een Gaussiaanse verdeling met een hoger gemiddelde voor de verkopen na het programma.
set.seed(123)
# sales before the program
sales_before <- rnorm(7, mean = 50000, sd = 50)
# sales after the program.This has higher mean
sales_after <- rnorm(7, mean = 50075, sd = 50)
# draw the distribution
t.test(sales_before, sales_after,var.equal = TRUE)

De p-waarde is 0.04606, net onder de drempel van 0.05, dus je verwerpt H0 en concludeert dat de twee gemiddelden significant van elkaar verschillen. Het kortingsprogramma lijkt de verkoop te hebben gestimuleerd.
⚠️ Belangrijk: De bovenstaande aanroep vergelijkt de twee vectoren als volgt: onafhankelijk monsters. Omdat beide series metingen zijn in dezelfde winkel, telt de statistisch correcte berekening op. gepaard = WAAR:
t.test(sales_before, sales_after, paired = TRUE)
De gepaarde test berekent het gemiddelde van de dagelijkse verschillen in plaats van het verschil tussen twee gemiddelden. Hierdoor wordt de variatie op winkelniveau, die beide vectoren gemeen hebben, geëlimineerd, wat resulteert in een grotere statistische power.
Hoe controleer je de aannames van de T-toets in R?
Een p-waarde van een t-test is alleen betekenisvol als aan de aannames is voldaan. Elke aanname kan direct worden gecontroleerd.
1. Normaliteit. De eensteekproef- en tweesteekproefstoetsen gaan ervan uit dat de waarden bij benadering normaal verdeeld zijn; de gepaarde toets gaat ervan uit dat de verschillen zijn. Bekijk een QQ-grafiek en bevestig dit met de Shapiro-Wilk-test:
qqnorm(sugar_cookie); qqline(sugar_cookie)
shapiro.test(sugar_cookie)

# for a paired design, test the differences
shapiro.test(sales_after - sales_before)
Een Shapiro-Wilk p-waarde boven 0.05 betekent dat normaliteit niet verworpen kan worden. Bij meer dan ongeveer 30 waarnemingen per groep maakt de centrale limietstelling de t-toets sowieso robuust tegen matige scheefheid.
2. Gelijke variantie. Alleen de gecombineerde tweesteekproefstest vereist dit. Test het met een F-toets:
var.test(line_a, line_b)
Een p-waarde boven 0.05 ondersteunt gelijke varianties, wat var.equal = TRUE rechtvaardigt.
3. Onafhankelijkheid. Dit volgt uit het onderzoeksontwerp en kan niet achteraf worden getoetst. Als dezelfde proefpersoon bijdraagt aan beide vectoren, is de onafhankelijke test simpelweg het verkeerde instrument en moet je de gepaarde test als WAAR beschouwen.
Wanneer een aanname niet klopt. Voor duidelijk niet-normaal verdeelde data met kleine steekproeven, gebruik de ranggebaseerde alternatieven: wilcox.test(x, y) vervangt de t-toets voor twee steekproeven en wilcox.test(x, y, paired = TRUE) vervangt de gepaarde versie. Geen van beide vereist normaliteit, hoewel beide een beetje aan power inleveren wanneer de data wél normaal verdeeld zijn.
T-toets in R: Belangrijkste conclusies en testreferentie
- Statistische gevolgtrekking is de kunst van het genereren van conclusies over de distributie van de gegevens.
- De T-toets behoort tot de familie van inferentiële statistieken. Deze wordt vaak gebruikt om te achterhalen of er een statistisch verschil is tussen de gemiddelden van twee groepen.
- De t-toets voor één steekproef, ofwel de Student-toets, vergelijkt het gemiddelde van een vector met een theoretisch gemiddelde.
- De gepaarde t-toets, of t-toets voor afhankelijke steekproeven, wordt gebruikt wanneer dezelfde groep tweemaal wordt gemeten.
De onderstaande tabel geeft een samenvatting van elke hierboven besproken test:
| Test | Hypothese om te testen | p-waarde | Code | Optioneel argument |
|---|---|---|---|---|
| t-test met één monster | Het gemiddelde van een vector verschilt van het theoretische gemiddelde | 0.05 |
t.test(x, mu = mean)
|
|
| gepaarde steekproef t-test | Het gemiddelde A verschilt van het gemiddelde B voor dezelfde proefpersonen. | 0.05 |
t.test(A, B, paired = TRUE) |
var.equal = TRUE
|
Als u bereid bent om gelijke varianties aan te nemen in een onafhankelijke tweesteekproefstest, stelt u var.equal = TRUE in. Laat deze op de standaardwaarde FALSE staan om de veiligere Welch-correctie uit te voeren.
