
Wat is Hadoop? ArchiStructuur, ecosysteem en componenten
 Prafulla Ranadive
⚡ Slimme samenvatting
Apache Hadoop is een open-source framework dat enorme datasets opslaat in clusters van standaardmachines en de verwerkingslogica naar de data verplaatst, waardoor analyses schaalbaar zijn door het toevoegen van goedkope nodes in plaats van grotere servers.
Wat is Hadoop?
Apache Hadoop is een open source softwareframework dat wordt gebruikt om gegevensverwerkingstoepassingen te ontwikkelen die worden uitgevoerd in een gedistribueerde computeromgeving.
Applicaties die met Hadoop zijn ontwikkeld, draaien op grote datasets die verdeeld zijn over clusters van standaardcomputers. Standaardcomputers zijn goedkoop en overal verkrijgbaar. Ze zijn vooral nuttig om tegen lage kosten meer rekenkracht te verkrijgen.
Net zoals gegevens zich in het lokale bestandssysteem van een pc bevinden, bevinden gegevens zich in Hadoop in een gedistribueerd bestandssysteem, dat het gedistribueerde bestandssysteem wordt genoemd. Hadoop gedistribueerd bestandssysteemHet verwerkingsmodel is gebaseerd op de 'Gegevenslokaliteit' concept, waarbij computationele logica naar de clusterknooppunten (servers) wordt gestuurd die de data bevatten. Deze computationele logica is simpelweg een gecompileerde versie van een programma geschreven in een programmeertaal op hoog niveau, zoals JavaEen dergelijk programma verwerkt gegevens die zijn opgeslagen in Hadoop HDFS.
Weet jij het? Een computercluster bestaat uit een set van meerdere verwerkingseenheden (opslagschijf + processor) die met elkaar verbonden zijn en als één systeem functioneren.
Versie 3.5.0, uitgebracht op 2 april 2026, is de huidige stabiele release; de 3.4-serie ontvangt nog steeds onderhoudsupdates.
Hadoop-ecosysteem en -componenten
Het onderstaande diagram toont de verschillende componenten in het Hadoop-ecosysteem, gegroepeerd op basis van de functie die ze vervullen: opslag, verwerking en de bijbehorende tools voor het opvragen, importeren en coördineren van gegevens.

Apache Hadoop bestaat uit twee deelprojecten:
- Hadoop-kaartVerminderen: MapReduce is een computationeel model en softwareframework voor het schrijven van applicaties die op Hadoop draaien. Deze MapReduce-programma's zijn in staat om enorme hoeveelheden data parallel te verwerken op grote clusters van computationele knooppunten.
- HDFS (Hadoop gedistribueerd bestandssysteem): HDFS verzorgt het opslaggedeelte van Hadoop-applicaties. MapReduce-applicaties gebruiken data van HDFS. HDFS maakt meerdere replica's van datablokken en verdeelt deze over rekenknooppunten in een cluster. Deze verdeling maakt betrouwbare en extreem snelle berekeningen mogelijk.
De huidige versies bevatten nog twee extra kernmodules. Hadoop GAREN, toegevoegd in Hadoop 2.x, plant werkzaamheden in op het cluster, en Hadoop algemeen bezit het gedeelde Java bibliotheken waar elke module van afhankelijk is. YARN is wat engines zoals SparkTez en Flink draaien naast MapReduce.
Hoewel Hadoop vooral bekend staat om MapReduce en het gedistribueerde bestandssysteem HDFS, wordt de term ook gebruikt voor een reeks verwante projecten die vallen onder de noemer gedistribueerde computing en grootschalige gegevensverwerking. Andere Hadoop-gerelateerde projecten bij Apache zijn onder andere: BijenkorfHBase, Mahout, Sqoop, Flumeen ZooKeeper.
Hadoop Architectuur
Hadoop maakt gebruik van een master-slave-architectuur voor dataopslag en gedistribueerde dataverwerking. KaartVerminderen en HDFS-methoden. In het onderstaande diagram worden deze rollen naast elkaar weergegeven, met de opslaglaag aan de ene kant en de verwerkingslaag aan de andere kant.
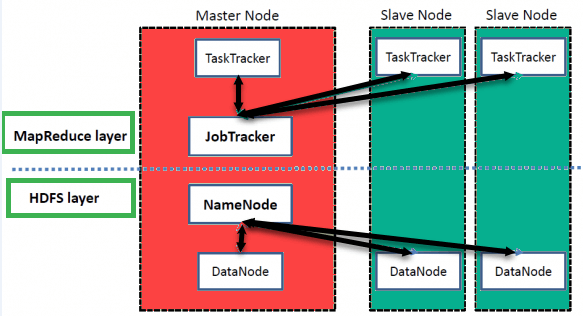
Hadoop op hoog niveau Architectuur
NaamKnooppunt
De NameNode slaat de metadata op voor elk bestand en elke map die in de namespace wordt gebruikt, inclusief welke blokken elk bestand vormen en waar die blokken zich bevinden.
DataNode
Een DataNode beheert de status van een HDFS-node en stelt je in staat om te interageren met de blokken die deze opslaat. De DataNode rapporteert periodiek aan de NameNode met blokrapporten en heartbeats.
MasterNode
Met het masterknooppunt kunt u parallelle gegevensverwerking uitvoeren met behulp van Hadoop MapReduce.
Slave-knooppunt
Slave-nodes zijn de extra machines in het Hadoop-cluster waarmee je gegevens kunt opslaan en complexe berekeningen kunt uitvoeren. Bovendien voert elke slave-node een taak uit.Tracker en een DataNode. Hiermee kunt u de processen synchroniseren met de NameNode en de Job.Tracker respectievelijk.
In Hadoop kunnen master- of slave-systemen in de cloud of on-premise worden opgezet.
Een opmerking over de naamgeving: JobTracker en TaakTracker behoren tot de eerste generatie MapReduce-runtime (MRv1). Vanaf Hadoop 2.x verdeelt YARN hun taken over een clusterbreed systeem. Resource Manager, een KnooppuntManager per werknemer, en één ApplicationMaster per taak. NameNode en DataNode blijven ongewijzigd.
Kenmerken van Hadoop
Geschikt voor big data-analyse
As Big data Omdat Big Data doorgaans gedistribueerd en ongestructureerd van aard is, zijn Hadoop-clusters het meest geschikt voor de analyse van Big Data. Omdat de verwerkingslogica (en niet de data zelf) naar de rekenknooppunten stroomt, wordt er minder netwerkbandbreedte verbruikt. Dit wordt de datalocatieconceptEn het helpt de efficiëntie van op Hadoop gebaseerde applicaties te verhogen.
Schaalbaarheid
Hadoop-clusters kunnen eenvoudig naar elke gewenste omvang worden geschaald door extra clusterknooppunten toe te voegen, waardoor de groei van big data mogelijk wordt. Bovendien vereist schalen geen aanpassingen aan de applicatielogica.
Fouttolerantie
Het Hadoop-ecosysteem biedt de mogelijkheid om de invoergegevens naar andere clusterknooppunten te repliceren. Op die manier kan de gegevensverwerking, in geval van een storing van een clusterknooppunt, doorgaan door gebruik te maken van gegevens die op een ander clusterknooppunt zijn opgeslagen. HDFS bewaart standaard drie kopieën van elk blok, een waarde die is ingesteld door de configuratie. dfs.replicatie eigenschap, en de NameNode repliceert elk blok opnieuw dat onder dat aantal komt.
Netwerktopologie in Hadoop
De topologie (de configuratie) van het netwerk beïnvloedt de prestaties van het Hadoop-cluster naarmate de omvang van het cluster toeneemt. Naast prestaties is ook hoge beschikbaarheid en de afhandeling van storingen van belang. Om dit te bereiken, maakt de configuratie van een Hadoop-cluster gebruik van de netwerktopologie.
De onderstaande boomstructuur laat zien hoe die opstelling is gemodelleerd, van het datacenter tot aan de knooppunten in elk rack.

Doorgaans is de netwerkbandbreedte een belangrijke factor om rekening mee te houden bij het opzetten van een netwerk. Omdat het meten van bandbreedte echter lastig kan zijn, wordt een netwerk in Hadoop weergegeven als een boomstructuur. De afstand tussen de knooppunten in deze boom (het aantal hops) wordt beschouwd als een belangrijke factor bij de vorming van een Hadoop-cluster. Hierbij is de afstand tussen twee knooppunten gelijk aan de som van hun afstanden tot hun dichtstbijzijnde gemeenschappelijke voorouder.
Een Hadoop-cluster bestaat uit een datacenter, een rack en een node die daadwerkelijk taken uitvoert. Het datacenter bestaat uit racks en een rack bestaat uit nodes. De beschikbare netwerkbandbreedte voor processen varieert afhankelijk van de locatie van de processen. Dat wil zeggen dat de beschikbare bandbreedte afneemt naarmate we verder van de locatie verwijderd zijn.
- Processen op hetzelfde knooppunt
- Verschillende knooppunten op hetzelfde rack
- Knooppunten op verschillende racks van hetzelfde datacenter
- Knooppunten in verschillende datacenters
Rack awareness maakt gebruik van dezelfde structuur: HDFS plaatst replica's op meer dan één rack, waardoor het uitvallen van een rackswitch niet alle kopieën van de gegevens meeneemt.
