
Hadoop Pig-zelfstudie: wat is Apache Pig? Architectuur, voorbeeld
 Prafulla Ranadive
⚡ Slimme samenvatting
Apache Pig is een geavanceerd platform voor het analyseren van grote datasets op Hadoop. Het combineert de Pig Latin-dataflowtaal met een runtime die elk script compileert naar MapReduce, Tez of Spark taken automatisch uitvoeren.
Deze handleiding begint met het idee achter Apache Pig en doorloopt vervolgens het installatieproces en het uitvoeren van een compleet Pig Latin-script van begin tot eind.
Wat is Apache Pig?
Pig is een hoogwaardig product. programmeertaal Handig voor het analyseren van grote datasets. Pig is het resultaat van ontwikkelingswerk bij Yahoo!
In een MapReduce-framework moeten programma's worden vertaald naar een reeks Map- en Reduce-fasen. Dit is echter geen programmeermodel waarmee data-analisten bekend zijn. Om deze kloof te overbruggen, is daarom een abstract framework ontwikkeld.traceen gebouw genaamd Pig werd bovenop gebouwd Hadoop.
Apache Pig stelt ontwikkelaars in staat zich meer te richten op het analyseren van grote datasets en minder tijd te besteden aan het schrijven van MapReduce-programma's. Net als varkens, die alles eten, is de programmeertaal Apache Pig ontworpen om met elk type data te werken. Vandaar de naam, Pig! De mascotte van het project hieronder illustreert dit perfect.

Het project is nog steeds actief. Apache Pig 0.18.0 werd uitgebracht op 15 september 2025 en voegt ondersteuning toe voor Hadoop 3, Tez 0.10, Hive 3, Spark 3, HBase 2 en Python 3, volgens de Apache Pig releasespaginaDe onderstaande handleiding is oorspronkelijk geschreven voor de veel oudere versie 0.12.1, dus bij sommige stappen staat vermeld dat een recentere versie zich anders gedraagt.
Varken Architectuur
De architectuur van Pig bestaat uit twee componenten:
- Varken Latijn, wat een taal is
- Een runtime-omgeving, voor het uitvoeren van Pig Latin-programma's.
Een Pig Latin-programma bestaat uit een reeks bewerkingen of transformaties die worden toegepast op de invoergegevens om uitvoer te produceren. Deze bewerkingen beschrijven een gegevensstroom die door de Hadoop Pig-uitvoeringsomgeving wordt vertaald naar een uitvoerbare representatie. De resultaten van deze transformaties zijn in feite een reeks KaartVerminderen taken waar een programmeur zich niet van bewust is. Pig in Hadoop stelt de programmeur dus in staat zich te concentreren op de data in plaats van op de uitvoeringswijze.
Pig Latin is een relatief rigide taal die bekende trefwoorden uit de dataverwerking gebruikt, zoals Join, Group en Filter. Zie onderstaand diagram. tracHet script wordt vanuit de Grunt-shell door de parser, optimizer en compiler geleid voordat het de uitvoeringsengine bereikt.

Uitvoeringsmodi
Pig in Hadoop heeft twee uitvoeringsmodi, en de installatiehandleiding verderop maakt gebruik van beide:
- Lokale modus: In deze modus draait de Hadoop Pig-taal in één enkele omgeving. JVM en maakt gebruik van het lokale bestandssysteem. Deze modus is alleen geschikt voor de analyse van kleine datasets met Pig in Hadoop.
- MapReduce-modus: In deze modus worden query's die in Pig Latin zijn geschreven, vertaald naar MapReduce-taken en uitgevoerd op een Hadoop-cluster (het cluster kan pseudo-gedistribueerd of volledig gedistribueerd zijn). De MapReduce-modus met een volledig gedistribueerd cluster is handig voor het uitvoeren van Pig op grote datasets.
Die twee vormen het klassieke duo. De huidige versies bieden eigenlijk zes uitvoeringstypen, of exectypes, die elk met dezelfde methode geselecteerd kunnen worden. -x vlag, zoals gedocumenteerd in de Handleiding voor het starten met Pig 0.18.0.
| Exectype | commando | Waar het werk plaatsvindt |
|---|---|---|
| Lokale | varken -x lokaal | Eén enkele JVM die het lokale bestandssysteem gebruikt. |
| Tez lokaal | pig -x tez_local | Een enkele JVM die gebruikmaakt van de Tez-runtime (experimenteel) |
| Spark lokaal | pig -x spark_local | Een enkele JVM die gebruikmaakt van de Spark looptijd (experimenteel) |
| KaartVerminderen | pig of pig -x mapreduce | Een Hadoop-cluster met HDFS; dit is de standaard. |
| Tez | varken -x tez | Een Hadoop-cluster waarop de Tez-engine draait. |
| Spark | varken -x vonk | A Spark, YARN- of Mesos-cluster met HDFS |
Pig Latin-datatypen en Operaverdraaid
Voordat je een script schrijft, is het handig om te weten wat Pig kan opslaan en wat het ermee kan doen. Het datamodel is volledig genest, waardoor Pig logbestanden en andere los gestructureerde invoer kan lezen die een relationele tabel zou weigeren.
Pig Latin biedt twee families van typen:
- Scalaire typen:
int,long,float,double,chararray,bytearray,boolean,datetime,bigintegerenbigdecimalHet voorbeeldscript declareert verderop elke kolom alschararray. - Complexe typen: a tuple is een geordende verzameling velden en gedraagt zich als een rij; een zak is een ongeordende verzameling van tuples en gedraagt zich als een tabel; een kaart is een verzameling sleutel-waardeparen waarvan de sleutel een moet zijn
chararray.
De operators vallen in een kleine categorie van functies, en een handjevol daarvan beheert bijna alle pijpleidingen:
| Operator | Wat het doet |
|---|---|
| LADEN / OPSLAAN | Lees een relatie uit het bestandssysteem en schrijf het resultaat terug. |
| FILTER | Bewaar alleen de tuples die aan een voorwaarde voldoen. |
| VOOR ELK … GENEREREN | Werk kolom voor kolom en bouw nieuwe velden op. |
| GROEP / COGROEP | Groepeer één relatie, of twee of meer relaties, op basis van een sleutel. |
| AANMELDEN | Combineer relaties met een inner join of outer join. |
| VERENIGING / SPLITSING | Voeg relaties samen of splits er een op in meerdere. |
| SORTEREN OP / ONDERSCHEIDEN / LIMIET | Sorteer, verwijder duplicaten en beperk het aantal tuples. |
| DUMPEN / BESCHRIJVEN / UITLEGGEN / ILLUSTREREN | Bekijk de resultaten, schema's, uitvoeringsplannen en voorbeeldruns. |
De vier inspecteurs hebben ook Grunt-sneltoetsen, wat tijd bespaart.ping tijdens het debuggen: \d voor DUMP, \de voor BESCHRIJVEN, \e voor EXPLAIN en \i voor ILLUSTRATE.
Voorwaarden
Pig is een client-side tool. Het analyseert een script, plant het werk en dient taken in, maar het biedt geen eigen opslag of cluster. Daarom moet er eerst een werkende Hadoop-installatie aanwezig zijn. De lijst met Apache-vereisten is kort.
| Bestanddeel | eis | Waarom het nodig is |
|---|---|---|
| Hadoop | Hadoop 2.x of 3.x, met HADOOP_HOME geëxporteerd | Levert HDFS en de uitvoeringsengine. Zonder HADOOP_HOME valt Pig 0.18.0 terug op een ingebouwde Hadoop 2.7.3. |
| Java | Java 1.7 of later, met JAVA_HOME ingesteld op de installatiemap. | Pig en de Hadoop-daemons zijn Java programma's |
| Python (Optioneel) | Python 2.7 | Alleen nodig voor streaming. Python door de gebruiker gedefinieerde functies |
| Mier (optioneel) | mier 1.8 | Alleen nodig bij het bouwen of hercompileren van Pig vanuit de broncode. |
Naast die lijst zijn er nog twee praktische punten. Ten eerste: voer alles uit als een Linux-gebruiker die al een thuismap heeft. HDFS en toestemming om erin te schrijven; deze handleiding maakt gebruik van hduser, het account dat is aangemaakt tijdens de Hadoop-installatie. Ten tweede, start het cluster voordat u Pig in MapReduce-modus start, omdat Pig onmiddellijk vastloopt als de NameNode en ResourceManager niet beschikbaar zijn. Als Hadoop nog niet is geïnstalleerd, doorloop dan de volgende stappen: Hoe installeer ik Hadoop? kopen.
Pig downloaden en installeren
In deze Apache Pig-tutorial leren we nu hoe we Pig kunnen downloaden en installeren:
Voordat we met het eigenlijke proces beginnen, moet u ervoor zorgen dat Hadoop is geïnstalleerd. Wijzig de gebruiker naar 'hduser' (de ID die is gebruikt tijdens de configuratie van Hadoop; u kunt overschakelen naar de gebruikers-ID die is gebruikt tijdens uw eigen Hadoop-configuratie).

Stap 1) Download de meest recente stabiele versie van Pig Hadoop van een van de beschikbare mirrorsites op
https://pig.apache.org/releases.html
Selecteer het tar.gz-bestand (en niet src.tar.gz) om te downloaden, zoals hieronder weergegeven.

Stap 2) Zodra de download is voltooid, navigeer je naar de map met het gedownloade tar-bestand en verplaats je het tar-bestand naar de locatie waar je Pig Hadoop wilt installeren. In dit geval verplaatsen we het naar /usr/local.

Ga naar de map die de Pig Hadoop-bestanden zal bevatten.
cd /usr/local
Extract de inhoud van het tar-bestand zoals hieronder.
sudo tar -xvf pig-0.12.1.tar.gz

Stap 3) Wijzig het bestand ~/.bashrc om omgevingsvariabelen met betrekking tot Pig toe te voegen.
Open het bestand ~/.bashrc in een teksteditor naar keuze en voer de onderstaande wijzigingen door.
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

Stap 4) Laad nu deze omgevingsconfiguratie in met behulp van de onderstaande opdracht.
. ~/.bashrc

Stap 5) We moeten Pig opnieuw compileren om Hadoop 2.2.0 te ondersteunen.
Hieronder volgen de stappen om dit te doen.
Ga naar de hoofdmap van Pig.
cd $PIG_HOME
Installeer Ant.
sudo apt-get install ant

Let op: de download start en de duur ervan is afhankelijk van uw internetsnelheid.
Hercompileer Pig.
sudo ant clean jar-all -Dhadoopversion=23

Houd er rekening mee dat er tijdens dit hercompilatieproces meerdere componenten worden gedownload, dus het systeem moet met internet verbonden zijn.
Mocht dit proces ergens vastlopen en u gedurende meer dan 20 minuten geen beweging in de opdrachtprompt zien, druk dan op Ctrl + c en voer dezelfde opdracht opnieuw uit.
In ons geval duurt het 20 minuten.

Deze hercompilatiestap behoort tot het 0.12.1-tijdperk, toen de meegeleverde JAR-bestanden werden gebouwd voor Hadoop 1 en de -Dhadoopversion=23 De vlag heeft de Ant-build overgeschakeld naar de Hadoop 0.23- en 2.x-lijn. Apache Pig 0.18.0 bevat binaire bestanden die al werken op Hadoop 2.7 en hoger, evenals Hadoop 3, dus bij een recente release kunt u het tarball-bestand normaal gesproken uitpakken en direct doorgaan naar de onderstaande test.
Stap 6) Test de Pig-installatie met behulp van het commando.
pig -help

Voorbeeld varkensscript
Nadat Pig is geïnstalleerd, voert de rest van deze Apache Pig-handleiding een compleet script uit. We gebruiken Pig-scripts om het aantal verkochte producten in elk land te achterhalen.
Invoer: Onze invoergegevensset is een CSV-bestand. VerkoopJan2009.csv.
Stap 1) Start Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Stap 2) Pig in Big Data haalt een bestand uit HDFS in MapReduce-modus en slaat de resultaten weer op in HDFS.
Kopieer het bestand SalesJan2009.csv (dat lokaal op het bestandssysteem is opgeslagen onder ~/input/SalesJan2009.csv) naar de thuismap van HDFS (Hadoop Distributed File System).
In dit Apache Pig-voorbeeld bevindt het bestand zich in de map 'input'. Als het bestand op een andere locatie is opgeslagen, gebruik dan die naam.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

Controleer of het bestand daadwerkelijk is gekopieerd.
$HADOOP_HOME/bin/hdfs dfs -ls /

Stap 3) Pig-configuratie.
Ga eerst naar $PIG_HOME/conf en bewaar een kopie van het originele properties-bestand.
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

Open pig.properties met een teksteditor naar keuze en geef het pad naar het logbestand op met pig.logfile.
sudo gedit pig.properties

De logger zal dit bestand gebruiken om fouten te registreren.
Stap 4) Voer het commando 'pig' uit. Hiermee start je de Pig-opdrachtprompt, een interactieve shell voor Pig-query's.
pig

Stap 5) Voer in de Grunt-opdrachtprompt voor Pig de onderstaande Pig-opdrachten in de aangegeven volgorde uit.
— A. Laad het bestand met gegevens.
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
Druk na deze opdracht op Enter.
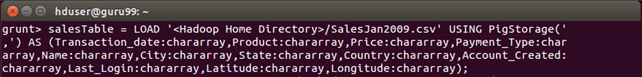
— B. Groepeer de gegevens op basis van het veld Land.
GroupByCountry = GROUP salesTable BY Country;

— C. Genereer voor elke tuple in 'GroupByCountry' de resulterende tekenreeks in de vorm Naam van het land: Aantal verkochte producten.
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
Druk na deze opdracht op Enter.
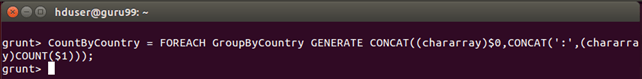
— D. Sla de resultaten van de dataflow op in de map 'pig_output_sales' op HDFS.
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

Het uitvoeren van deze opdracht zal enige tijd in beslag nemen. Zodra het klaar is, zou u het volgende scherm moeten zien.

Stap 6) Het resultaat is te zien via de commando-interface als
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

De resultaten kunnen ook via een webinterface worden bekeken.
Open http://localhost:50070/ in een webbrowser.
Poort 50070 is de webinterface van de NameNode op Hadoop 2. Hadoop 3 heeft dezelfde pagina verplaatst naar poort 9870, dus gebruik dat adres in plaats daarvan als uw cluster Hadoop 3 gebruikt.

Selecteer nu 'Bladeren door het bestandssysteem' en navigeer naar /user/hduser/pig_output_sales.

Open part-r-00000 om de combinaties van land en productaantal te lezen die het script heeft gegenereerd.

Apache Pig versus Hive versus MapReduce
Pig wordt zelden op zichzelf beoordeeld. De gebruikelijke vraag is of een baan wel of niet in Pig thuishoort. Bijenkorf of in een handgeschreven MapReduce-programma, aangezien alle drie uiteindelijk als taken op hetzelfde cluster terechtkomen.
| Aspect | MapReduce (Java) | Apache Varken | Apache-bijenkorf |
|---|---|---|---|
| Interface | Java API | Pig Latin, een scripttaal voor dataflows. | HiveQL, een SQL-dialect |
| Abs-niveautractie | Laag | Medium | Hoge |
| Typische gebruiker | Java ontwikkelaar | Data-ingenieur of -onderzoeker | Analist met ervaring in SQL |
| Gegevens die erbij passen | Alles wat handmatig wordt afgehandeld | Gestructureerd en semi-gestructureerd; het schema is optioneel tijdens het laden. | Gestructureerde tabellen geregistreerd in een metastore. |
| Code volume | De meeste lijnen | Minder rijen | Het minste aantal regels voor een zoekopdracht |
| Draait als | Een MapReduce-taak | Compileert naar MapReduce, Tez of Spark vacatures | Compileert naar MapReduce, Tez of Spark vacatures |
| Het beste bij | Volledige controle en aangepaste logica | ETL-pipelines met meerdere stappen | Ad-hoc query's en rapportages |
In de praktijk is de scheiding eenvoudig. Kies voor Hive wanneer de data al de vorm van een tabel heeft en de vraag op SQL lijkt. Kies voor Pig wanneer de input rommelig is, wanneer de pipeline een reeks transformaties is in plaats van een enkele query, of wanneer hetzelfde script moet vertakken en opnieuw moet samenvoegen. Kies alleen voor MapReduce wanneer geen van beide...tracDe logica kan worden uitgedrukt, omdat het aantal regels snel toeneemt.
Varkensvlees past ook prima in de rest van het ecosysteem. Sqoop en Flume De ruwe data wordt ingevoerd, Pig of Hive structureert deze, en een scheduler zoals Apache Oozie koppelt de stappen aan elkaar tot een herhaalbare workflow. Voor een breder overzicht van waar deze tools in passen, zie de handleiding voor big data en de samenvatting van tools voor big dataVoor een commercieel ETL-alternatief voor handgeschreven scripts, zie Talend.
