
Hebzuchtig algoritme met voorbeeld: wat is, methode en aanpak
 Redactie
⚡ Slimme samenvatting
Het ontwerp van een gulzig algoritme bouwt een optimale oplossing door bij elke stap de beste lokale keuze te maken, waarbij recursie, geordende resources en een stopvoorwaarde worden gebruikt om plannings-, opspannende-boom-, kortste-pad- en netwerkoptimalisatieproblemen efficiënt op te lossen.
Wat is een hebzuchtig algoritme?
A Hebzuchtig algoritme Verdeelt recursief een set resources op basis van de maximale onmiddellijke beschikbaarheid van die resource in elke fase van de uitvoering.
Het oplossen van een probleem met de gulzige aanpak bestaat uit twee fasen:
- De lijst met items scannen
- Optimalisatie
Beide fasen verlopen parallel, waarbij de invoerarray stapsgewijs wordt verdeeld.
Om de gulzige aanpak te volgen, is een goede kennis van recursie en contextwisseling handig. trace de code. Het gulzige paradigma kan worden beschreven met een paar noodzakelijke en voldoende beweringen.
Er zijn twee voorwaarden die het hebzuchtige paradigma definiëren.
- Elke stapsgewijze keuze moet het probleem in de richting van de meest aanvaardbare oplossing sturen.
- De probleemstructuur moet binnen een eindig aantal gierige stappen tot stilstand komen.
Nu de theorie is uiteengezet, laten we eens kijken naar de geschiedenis van de gulzige zoekmethode.
Geschiedenis van hebzuchtig Algorithms
Hieronder vindt u de belangrijkste mijlpalen in de geschiedenis van gulzige algoritmen:
- Gierige algoritmen werden voor het eerst bedacht voor algoritmen die grafen doorlopen, in de jaren 1950.
- Edsger Dijkstra ontwikkelde zijn kortste-pad-algoritme om routes door de Nederlandse hoofdstad Amsterdam te verkorten.
- In hetzelfde decennium ontwikkelden Prim en Kruskal optimalisatiestrategieën die de padkosten langs gewogen routes minimaliseren om minimale opspannende bomen te construeren.
- In de jaren '70 beschreven de Amerikaanse onderzoekers Cormen, Leiserson, Rivest en Stein de recursieve substructurering van gierige oplossingen in hun klassieke werk. Introduction to Algorithms leerboek.
- Het gulzige zoekparadigma werd in 2005 in de NIST-archieven als een aparte optimalisatiestrategie gecatalogiseerd.
- Tot op de dag van vandaag gebruiken webprotocollen zoals Open Shortest Path First (OSPF) en veel pakketschakelprotocollen de 'greedy strategy' om de transittijd op een netwerk te minimaliseren.
Hebzuchtige strategieën en beslissingen
De logica komt in elke fase neer op een binaire keuze: "hebzuchtig" of "niet-hebzuchtig", afhankelijk van de richting waarin het algoritme zich ontwikkelt.
Dijkstra's algoritme identificeert bijvoorbeeld hosts op het internet door bij elke stap een kostenfunctie te evalueren. De waarde die de kostenfunctie retourneert, bepaalt of het volgende pad "gretig" of "niet-gretig" is.
Kort gezegd, een algoritme houdt op hebzuchtig te zijn op het moment dat het een stap zet die niet lokaal optimaal is, en hebzuchtige problemen stoppen wanneer er geen verdere hebzuchtige stap meer mogelijk is.
Kenmerken van het hebzuchtige algoritme
De belangrijke kenmerken van een Greedy-algoritme zijn:
- Een geordende lijst van resources bevat kosten- of waardetoekenningen die de beperkingen van het systeem kwantificeren.
- Het algoritme benut de maximale hoeveelheid resources binnen de tijdslimiet die geldt.
- Bijvoorbeeld, bij een planningsprobleem voor activiteiten worden de kosten van de resources gemeten in uren en moeten de activiteiten in een bepaalde volgorde worden uitgevoerd.

Waarom de hebzuchtige aanpak gebruiken?
Hier zijn de redenen om de hebzuchtige aanpak te gebruiken:
- De gierige aanpak kent afwegingen die hem zeer geschikt maken voor optimalisatie.
- De meest voor de hand liggende reden is om direct een haalbare oplossing te vinden. In het hieronder besproken probleem van activiteitenselectie kunnen, indien er meer activiteiten in hetzelfde tijdsvenster passen voordat de huidige activiteit is voltooid, deze in hetzelfde tijdsvenster worden ingepland.
- Een andere reden is dat het een probleem recursief opdeelt op basis van een voorwaarde, zonder dat het nodig is om deeloplossingen samen te voegen.
- Bij het selecteren van activiteiten wordt de recursieve indelingsstap uitgevoerd door de lijst eenmaal te doorlopen en alleen de in aanmerking komende activiteiten in overweging te nemen.
Hoe los je het probleem van de activiteitenselectie op?
In het voorbeeld van de activiteitenplanning heeft elke activiteit een begin- en eindtijd en wordt deze ter referentie genummerd. Er zijn twee activiteitscategorieën:
- Overwogen activiteit: De referentieactiviteit wordt gemeten aan de hand waarvan het vermogen om meer resterende activiteiten in te passen wordt bepaald.
- Resterende activiteiten: activiteiten op een of meer indexen vóór de beschouwde activiteit.
De kosten van het uitvoeren van een activiteit worden bepaald door de duur ervan, berekend als (eindtijd – begintijd).
De 'greedy extent' is simpelweg het aantal resterende activiteiten dat kan worden uitgevoerd binnen de tijd van een bepaalde activiteit.
Archivan de Greedy Approach
Stap 1) Doorloop de lijst met activiteitskosten, beginnend met index 0 als de te beschouwen index.
Stap 2) Als er nog meer activiteiten afgerond kunnen worden voordat de betreffende activiteit eindigt, zoek dan naar die resterende activiteiten.
Stap 3) Als er geen activiteiten meer ingepland kunnen worden, wordt de huidige resterende activiteit de volgende activiteit die in aanmerking komt. Herhaal stap 1 en stap 2 met de nieuwe activiteit. Als er geen activiteiten meer over zijn, ga dan naar stap 4.
Stap 4) Retourneer de vereniging van de beschouwde indexen — dit zijn de activiteitsindexen die de doorvoer maximaliseren.

Archivan de Greedy Approach
Code Uitleg
#include<iostream>
#include<stdio.h>
#include<stdlib.h>

#define MAX_ACTIVITIES 12

Toelichting code:
- Inbegrepen headerbestanden/klassen
- Het maximale aantal activiteiten dat de gebruiker kan configureren.
using namespace std;

class TIME
{
    public:
    int hours;

    public: TIME()
    {
   	 hours = 0;
    }
};

Toelichting code:
- Declareert de standaardnaamruimte voor streamingbewerkingen.
- Een klassedefinitie voor TIME
- Een tijdstempel van een uur.
- Een TIME-standaardconstructor
- De uren zijn variabel.
class Activity
{
    public:
    int index;
    TIME start;
    TIME finish;

    public: Activity()
    {
   	 start = finish = TIME();
    }
};

Toelichting code:
- Een klassedefinitie voor Activity.
- Tijdstempels die samen een tijdsduur definiëren.
- Alle tijdstempels worden in de standaardconstructor op 0 geïnitialiseerd.
class Scheduler
{
    public:
    int considered_index,init_index;
    Activity *current_activities = new    Activity[MAX_ACTIVITIES];
    Activity *scheduled;

Toelichting code:
- Deel 1 van de definitie van de plannerklasse.
- considered_index is het startpunt voor het scannen van de array.
- init_index wordt gebruikt om willekeurige tijdstempels toe te wijzen tijdens de configuratie.
- Met de `new`-operator wordt dynamisch een array van `Activity`-objecten toegewezen.
- De geplande aanwijzer bevat het huidige greedy-resultaat.
Scheduler()
{
   	 considered_index = 0;
   	 scheduled = NULL;
...
...
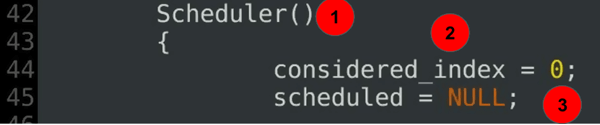
Toelichting code:
- De Scheduler-constructor — deel 2 van de klassedefinitie.
- considered_index markeert het begin van de huidige scan.
- De omvang van de gierigheid is in het begin niet gedefinieerd.
for(init_index = 0; init_index < MAX_ACTIVITIES; init_index++) { current_activities[init_index].start.hours = rand() % 12; current_activities[init_index].finish.hours = current_activities[init_index].start.hours + (rand() % 2); printf("\nSTART:%d END %d\n", current_activities[init_index].start.hours ,current_activities[init_index].finish.hours); } … …
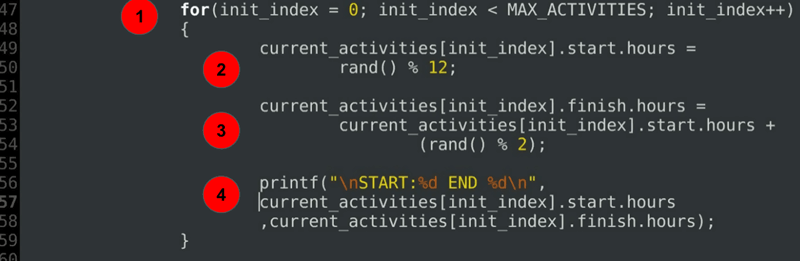
Toelichting code:
- Een for-lus initialiseert de begin- en eindtijd van elke geplande activiteit.
- Initialiseert de starttijd.
- Hiermee wordt de eindtijd ingesteld op of na het beginuur.
- Een debug-instructie print de toegewezen tijdsduur.
	public:
   		 Activity * activity_select(int);
};
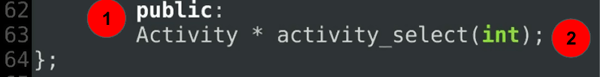
Toelichting code:
- Deel 4 — het laatste deel van de definitie van de Scheduler-klasse.
- activity_select() neemt een startindex als basis en verdeelt de greedy quest in subproblemen.
Activity * Scheduler :: activity_select(int considered_index)
{
    this->considered_index = considered_index;
    int greedy_extent = this->considered_index + 1;
…
…

- De scope-resolutieoperator (::) koppelt de functiedefinitie aan de Scheduler-klasse.
- considered_index wordt doorgegeven via waardeoverdracht, en greedy_extent wordt geïnitialiseerd met de index die er direct op volgt.
Activity * Scheduler :: activity_select(int considered_index) { while( (greedy_extent < MAX_ACTIVITIES ) && ((this->current_activities[greedy_extent]).start.hours < (this->current_activities[considered_index]).finish.hours )) { printf("\nSchedule start:%d \nfinish%d\n activity:%d\n", (this->current_activities[greedy_extent]).start.hours, (this->current_activities[greedy_extent]).finish.hours, greedy_extent + 1); greedy_extent++; } … ...

Toelichting code:
- De kernlogica — de gulzige omvang is beperkt tot MAX_ACTIVITIES.
- Het begintijdstip van de huidige activiteit wordt vergeleken met het eindtijdstip van de betreffende activiteit.
- Zolang aan de voorwaarde is voldaan, wordt een optionele debug-melding afgedrukt.
- De gierige uitbreiding gaat vervolgens verder naar de volgende index in de activiteitenreeks.
...
if ( greedy_extent <= MAX_ACTIVITIES )
    {

   	 return activity_select(greedy_extent);
    }
    else
    {
   	 return NULL;
    }
}

Toelichting code:
- De voorwaarde controleert of alle activiteiten zijn uitgevoerd.
- Zo niet, dan start het algoritme de gulzige zoektocht opnieuw vanaf de huidige index — een recursieve stap die het probleem op een gulzige manier verdeelt.
- Indien ja, keert de controle terug naar de aanroeper zonder de mogelijkheid om hebzucht verder uit te breiden.
int main()
{
    Scheduler *activity_sched = new Scheduler();
    activity_sched->scheduled = activity_sched->activity_select(
   				activity_sched->considered_index);
    return 0;
}

Toelichting code:
- De hoofdfunctie roept de scheduler aan.
- Er wordt een nieuw Scheduler-object aangemaakt.
- De functie activity_select() retourneert een Activity-pointer aan de aanroeper zodra de greedy quest is voltooid.
Output:
START:7 END 7

START:9 END 10

START:5 END 6

START:10 END 10

START:9 END 10

Schedule start:5
finish6
 activity:3

Schedule start:9
finish10
 activity:5
Beperkingen van hebzuchtige techniek
De gulzige aanpak is niet geschikt voor problemen die een optimale oplossing vereisen voor elk deelprobleem, zoals sorteren.
In dergelijke gevallen kan de gulzige methode fout zijn — in het ergste geval levert ze een niet-optimale oplossing op.
Het grootste nadeel van gulzige algoritmen is dat ze een keuze maken zonder te weten wat er na de huidige gulzige toestand zal gebeuren.
Het onderstaande diagram illustreert dit nadeel van de gulzige methode.

In de hier als boom weergegeven gierige scan (een hogere waarde betekent een hogere gierigheid), zou een algoritme met waarde 40 vervolgens 29 kiezen en dan eindigen bij 12, voor een totaal van 41.
Daarentegen zou een verdeel-en-heersstrategie na 25 punten 40 punten opleveren, wat een totaal van 65 punten oplevert. Dat is 24 punten hoger dan de lokaal hebzuchtige keuze.
Voorbeelden van hebzuchtig Algorithms
De meeste netwerkalgoritmen maken gebruik van een gulzige aanpak. Veelvoorkomende voorbeelden van gulzige algoritmen zijn:
- Prim's algoritme voor de minimale opspannende boom
- Het handelsreizigersprobleem (bij benadering)
- Grafiekkaart inkleuren
- Kruskal's algoritme voor de minimale opspannende boom
- Dijkstra's kortste-pad-algoritme
- Graafvertex Cover
- Knapzak probleem
- Taakvolgorde met deadlines
