
Hadoop MapReduce-voorbeeld: Eerste Java Programma met Code
 Prafulla Ranadive
⚡ Slimme samenvatting
Hadoop MapReduce-programma's worden geschreven als drie Java klassen, een mapper, een reducer en een driver, die worden gecompileerd, verpakt in een jar-bestand en naar het cluster worden verzonden om de verkoop per land te tellen.
In deze tutorial leer je Hadoop gebruiken met MapReduce-voorbeelden. De gebruikte invoergegevens zijn VerkoopJan2009.csvHet bevat verkoopgerelateerde informatie zoals productnaam, prijs, betaalmethode, stad en land van de klant. Het doel is om het aantal verkochte producten in elk land te achterhalen.
Eerste Hadoop MapReduce-programma
Nu in dit MapReduce-tutorial, zullen we onze eerste maken Java MapReduce-programma:
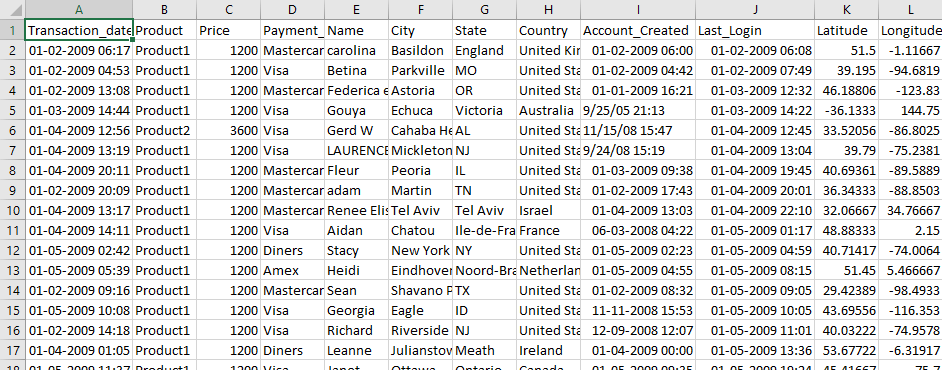
De onderstaande schermafbeelding toont de onbewerkte verkoopgegevens van januari 2009, waarbij elke regel één transactie vertegenwoordigt en het land in de achtste, door komma's gescheiden kolom staat.
Zorg ervoor dat Hadoop is geïnstalleerd. Voordat u met het eigenlijke proces begint, wijzigt u de gebruiker naar 'hduser' (de ID die u gebruikte tijdens de configuratie van Hadoop; u kunt overschakelen naar de gebruikers-ID die u tijdens uw eigen Hadoop-configuratie gebruikte).
su - hduser_
De prompt verandert naar het hduser-account, zoals hieronder weergegeven.

Stap 1) Maak de projectmap en de bronbestanden aan.
Maak een nieuwe map aan met de naam MapReduceTutorial, zoals weergegeven in het onderstaande MapReduce-voorbeeld.
sudo mkdir MapReduceTutorial

Geef toestemming
sudo chmod -R 777 MapReduceTutorial

Maak de drie Java De bronbestanden staan hieronder in MapReduceTutorial. Merk op dat alle drie de oudere versies gebruiken. org.apache.hadoop.mapred API, die nog steeds wordt meegeleverd met Hadoop 3.x.
SalesMapper.java
package SalesCountry;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesMapper extends MapReduceBase implements Mapper <LongWritable, Text, Text, IntWritable> {
	private final static IntWritable one = new IntWritable(1);

	public void map(LongWritable key, Text value, OutputCollector <Text, IntWritable> output, Reporter reporter) throws IOException {

		String valueString = value.toString();
		String[] SingleCountryData = valueString.split(",");
		output.collect(new Text(SingleCountryData[7]), one);
	}
}
SalesCountryReducer.java
package SalesCountry;

import java.io.IOException;
import java.util.*;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {

	public void reduce(Text t_key, Iterator<IntWritable> values, OutputCollector<Text,IntWritable> output, Reporter reporter) throws IOException {
		Text key = t_key;
		int frequencyForCountry = 0;
		while (values.hasNext()) {
			// replace type of value with the actual type of our value
			IntWritable value = (IntWritable) values.next();
			frequencyForCountry += value.get();

		}
		output.collect(key, new IntWritable(frequencyForCountry));
	}
}
SalesCountryDriver.java
package SalesCountry;

import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.*;
import org.apache.hadoop.mapred.*;

public class SalesCountryDriver {
    public static void main(String[] args) {
        JobClient my_client = new JobClient();
        // Create a configuration object for the job
        JobConf job_conf = new JobConf(SalesCountryDriver.class);

        // Set a name of the Job
        job_conf.setJobName("SalePerCountry");

        // Specify data type of output key and value
        job_conf.setOutputKeyClass(Text.class);
        job_conf.setOutputValueClass(IntWritable.class);

        // Specify names of Mapper and Reducer Class
        job_conf.setMapperClass(SalesCountry.SalesMapper.class);
        job_conf.setReducerClass(SalesCountry.SalesCountryReducer.class);

        // Specify formats of the data type of Input and output
        job_conf.setInputFormat(TextInputFormat.class);
        job_conf.setOutputFormat(TextOutputFormat.class);

        // Set input and output directories using command line arguments,
        //arg[0] = name of input directory on HDFS, and arg[1] =  name of output directory to be created to store the output file.

        FileInputFormat.setInputPaths(job_conf, new Path(args[0]));
        FileOutputFormat.setOutputPath(job_conf, new Path(args[1]));

        my_client.setConf(job_conf);
        try {
            // Run the job
            JobClient.runJob(job_conf);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
Het archief wordt uitgepakt tot dezelfde drie bronbestanden, zoals hier weergegeven.
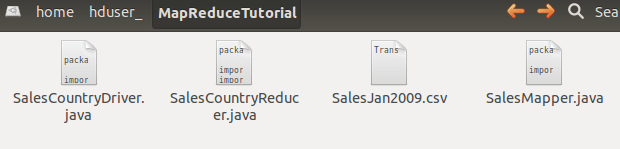
Controleer de bestandsrechten van al deze bestanden

Als de leesrechten ontbreken, verleen ze dan:

Stap 2) Exporteer het Hadoop-classpath
Exporteer het classpath zoals weergegeven in het onderstaande Hadoop-voorbeeld.
export CLASSPATH="$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-core-2.2.0.jar:$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-common-2.2.0.jar:$HADOOP_HOME/share/hadoop/common/hadoop-common-2.2.0.jar:~/MapReduceTutorial/SalesCountry/*:$HADOOP_HOME/lib/*"
Het geëxporteerde classpath wordt weergegeven in de prompt.

Stap 3) Compileer de Java bestanden
Compileer de Java De bestanden (deze bestanden bevinden zich in de map Final-MapReduceHandsOn). De bijbehorende klassebestanden worden in de pakketmap geplaatst.
javac -d . SalesMapper.java SalesCountryReducer.java SalesCountryDriver.java
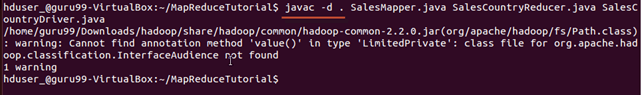
Deze waarschuwing kan gerust genegeerd worden; er staat alleen dat de Mapred API verouderd is.
Deze compilatie zal een map aanmaken in de huidige map met de pakketnaam die is opgegeven in de Java Het bronbestand (in ons geval SalesCountry) en alle gecompileerde klassebestanden daarin plaatsen.

Stap 4) Maak het manifestbestand aan.
Maak een nieuw bestand aan met de naam Manifest.txt.
sudo gedit Manifest.txt
Voeg de volgende regel eraan toe:
Main-Class: SalesCountry.SalesCountryDriver

SalesCountry.SalesCountryDriver is de naam van de hoofdklasse. Let op: u moet aan het einde van deze regel op de enter-toets drukken.
Stap 5) Verpak de klassen in een pot.
Maak een Jar-bestand
jar cfm ProductSalePerCountry.jar Manifest.txt SalesCountry/*.class

Controleer of het jar-bestand is gemaakt

Stap 6) Start Hadoop
Hadoop starten
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Stap 7) Kopieer het invoerbestand naar HDFS.
Kopieer het bestand SalesJan2009.csv naar ~/inputMapReduce
Gebruik nu de onderstaande opdracht om ~/inputMapReduce naar HDFS te kopiëren.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/inputMapReduce /
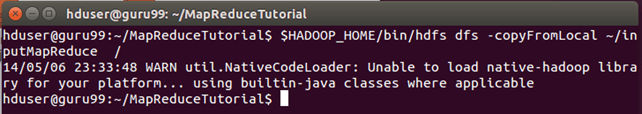
We kunnen deze waarschuwing veilig negeren.
Controleer of een bestand daadwerkelijk wordt gekopieerd of niet.
$HADOOP_HOME/bin/hdfs dfs -ls /inputMapReduce

Stap 8) Voer de MapReduce-taak uit
Voer de MapReduce-taak uit
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales

Hiermee wordt een uitvoermap gemaakt met de naam mapreduce_output_sales on HDFS. De inhoud van deze map zal een bestand zijn met de productverkopen per land.
Stap 9) Lees de resultaten
Het resultaat is via de commando-interface als volgt te zien:
$HADOOP_HOME/bin/hdfs dfs -cat /mapreduce_output_sales/part-00000
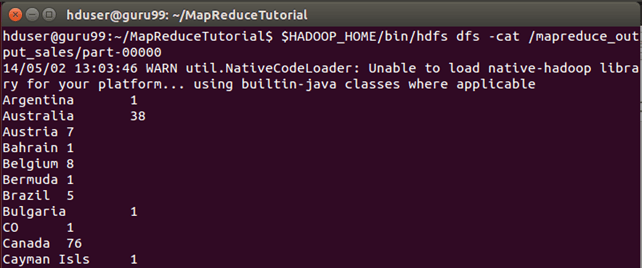
Resultaten kunnen ook worden bekeken via een webinterface als-
Open http://localhost:50070/ in een webbrowser. Op Hadoop 3.x is de NameNode-webinterface verplaatst naar poort 9870, dus gebruik http://localhost:9870/ daar in plaats daarvan.

Selecteer nu 'Bestandssysteem doorbladeren' en navigeer naar /mapreduce_output_sales

Open onderdeel-r-00000

Uitleg van de SalesMapper-klasse
De volgende drie secties beschrijven, aan de hand van een volledig overzicht van de functie van elke klasse.
In dit gedeelte zullen we de implementatie van de SalesMapper-klasse begrijpen.
1. We beginnen met het specificeren van een pakketnaam voor onze klasse. SalesCountry is de naam van ons pakket. Houd er rekening mee dat de uitvoer van de compilatie, SalesMapper.class, in een map met deze pakketnaam terechtkomt: SalesCountry.
Hierna importeren we bibliotheekpakketten.
Onderstaande schermafbeelding toont een implementatie van de SalesMapper-klasse.

Sample Code Uitleg:
1. SalesMapper-klassedefinitie-
public class SalesMapper extends MapReduceBase implements Mapper<LongWritable, Text, Text, IntWritable> {
Elke mapperklasse moet afgeleid zijn van de MapReduceBase-klasse en de Mapper-interface implementeren.
2. 'kaart'-functie definiëren-
public void map(LongWritable key,
         Text value,
OutputCollector<Text, IntWritable> output,
Reporter reporter) throws IOException
Het belangrijkste onderdeel van de Mapper-klasse is de 'map()'-methode, die vier argumenten accepteert.
Bij elke aanroep van de 'map()'-methode wordt een sleutel-waardepaar ('key' en 'value' in deze code) doorgegeven.
De 'map()'-methode begint met het opsplitsen van de invoertekst die als argument wordt ontvangen. Elke regel wordt opgesplitst in velden.
String valueString = value.toString();
String[] SingleCountryData = valueString.split(",");
Hier wordt ',' als scheidingsteken gebruikt.
Hierna wordt een paar gevormd met behulp van een record op de 7e index van de array 'SingleCountryData' en de waarde '1'.
output.collect(new Text(SingleCountryData[7]), one);
We kiezen het record op index 7 omdat we landgegevens nodig hebben en deze zich op index 7 in de array 'SingleCountryData' bevinden.
Houd er rekening mee dat onze invoergegevens de onderstaande indeling hebben (waarbij Land op de 7e positie staat, met 0 als startpositie):
Transaction_date,Product,Price,Payment_Type,Name,City,State,Country,Account_Created,Last_Login,Latitude,Longitude
De uitvoer van de mapper is wederom een sleutel-waardepaar dat wordt gegenereerd met behulp van de 'collect()'-methode van 'OutputCollector'.
Uitleg van de SalesCountryReducer-klasse
In dit gedeelte zullen we de implementatie van de SalesCountryReducer-klasse begrijpen.
1. We beginnen met het specificeren van een naam voor het pakket van onze klasse. SalesCountry is de naam van ons pakket. Houd er rekening mee dat de uitvoer van de compilatie, SalesCountryReducer.class, in een map met deze pakketnaam terechtkomt: SalesCountry.
Hierna importeren we bibliotheekpakketten.
Onderstaande schermafbeelding toont een implementatie van de SalesCountryReducer-klasse.
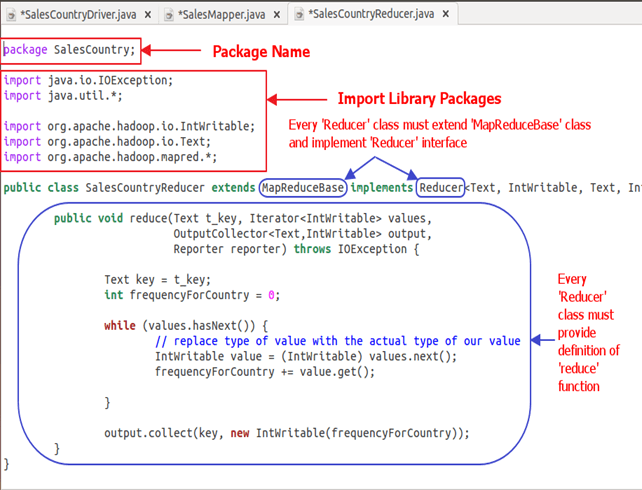
Code Uitleg:
1. SalesCountryReducer-klassedefinitie-
public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {
Hier zijn de eerste twee gegevenstypen, 'Text' en 'IntWritable', de gegevenstypen van de sleutel-waardeparen die als invoer voor de reducer dienen.
De uitvoer van de mapper heeft de volgende vorm: , De uitvoer van de mapper wordt de invoer voor de reducer. Om overeen te komen met het gegevenstype, worden Text en IntWritable als gegevenstype gebruikt.
De laatste twee gegevenstypen, 'Text' en 'IntWritable', zijn de gegevenstypen van de uitvoer die door de reducer wordt gegenereerd in de vorm van een sleutel-waardepaar.
Elke reducer-klasse moet afgeleid zijn van de MapReduceBase-klasse en de Reducer-interface implementeren.
2. De functie 'verminderen' definiëren-
public void reduce( Text t_key,
             Iterator<IntWritable> values,
             OutputCollector<Text,IntWritable> output,
             Reporter reporter) throws IOException {
Een invoer voor de reduce()-methode is een sleutel met een lijst van meerdere waarden.
In ons geval zal het bijvoorbeeld zijn:
, , , , , .
Dit wordt aan de reducer gegeven als
Om argumenten van deze vorm te accepteren, worden eerst twee gegevenstypen gebruikt, namelijk Tekst en Iterator. Tekst is een gegevenstype met een sleutel en een iterator. is een gegevenstype voor een lijst met waarden voor die sleutel.
Het volgende argument is van het type OutputCollector. die de uitvoer van de reductiefase verzamelt.
De `reduce()`-methode begint met het kopiëren van de sleutelwaarde en het initialiseren van de frequentieteller naar 0.
Text key = t_key;int frequencyForCountry = 0;
Vervolgens doorlopen we met behulp van een 'while'-lus de lijst met waarden die aan de sleutel zijn gekoppeld en berekenen we de uiteindelijke frequentie door alle waarden bij elkaar op te tellen.
 while (values.hasNext()) {
            // replace type of value with the actual type of our value
            IntWritable value = (IntWritable) values.next();
            frequencyForCountry += value.get();

        }
Nu sturen we het resultaat naar de uitvoercollector in de vorm van een sleutel en de verkregen frequentietelling.
Onderstaande code doet dit-
output.collect(key, new IntWritable(frequencyForCountry));
Uitleg van de SalesCountryDriver-klasse
In dit gedeelte zullen we de implementatie van de SalesCountryDriver-klasse begrijpen.
1. We beginnen met het specificeren van een pakketnaam voor onze klasse. SalesCountry is de naam van ons pakket. Houd er rekening mee dat het uitvoerbestand van de compilatie, SalesCountryDriver.class, in een map met deze pakketnaam terechtkomt: SalesCountry.
Hier is een regel die de pakketnaam specificeert, gevolgd door code om bibliotheekpakketten te importeren.

2. Definieer een driverklasse die een nieuwe clienttaak en configuratieobject zal creëren en Mapper- en Reducer-klassen zal adverteren.
De stuurprogrammaklasse is verantwoordelijk voor het instellen van onze MapReduce-taak HadoopIn deze klasse specificeren we de taaknaam, het gegevenstype van de invoer/uitvoer en de namen van de mapper- en reducerklassen.

3. In het onderstaande codefragment stellen we invoer- en uitvoermappen in die worden gebruikt om respectievelijk de invoergegevensset te consumeren en uitvoer te produceren.
arg[0] en arg[1] zijn de opdrachtregelargumenten die worden doorgegeven bij een commando dat wordt gegeven in de MapReduce-oefensessie, d.w.z.
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales
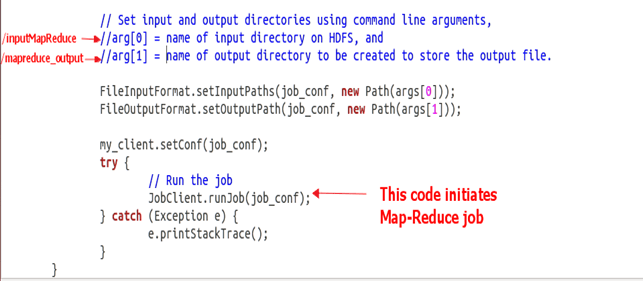
4. Activeer onze taak
Onderstaande code start de uitvoering van de MapReduce-taak.
try {
    // Run the job
    JobClient.runJob(job_conf);
} catch (Exception e) {
    e.printStackTrace();
}
