
Apache Flume-tutorial: wat is, Architecture & Hadoop-voorbeeld
 Prafulla Ranadive
⚡ Slimme samenvatting
Apache Flume is een gedistribueerde service voor het verzamelen, samenvoegen en verplaatsen van grote hoeveelheden loggegevens naar HDFS. De service is opgebouwd rond agents die een bron, een kanaal en een bestemming aan elkaar koppelen.
Wat is Apache Flume in Hadoop?
Apache Flume is een betrouwbaar en gedistribueerd systeem voor het verzamelen, aggregeren en verplaatsen van enorme hoeveelheden loggegevens. Het heeft een eenvoudige maar flexibele architectuur gebaseerd op streaming dataflows. Apache Flume wordt gebruikt om loggegevens uit logbestanden van webservers te verzamelen en te aggregeren. HDFS voor analyse.
Flume in Hadoop ondersteunt meerdere bronnen, waaronder:
- 'tail' (waarmee gegevens vanuit een lokaal bestand via Flume naar HDFS worden geschreven, vergelijkbaar met het Unix-commando 'tail')
- Systeemlogboeken
- Apache-log4j (wat mogelijk maakt) Java toepassingen om gebeurtenissen naar bestanden in HDFS te schrijven via Flume).
De huidige uitgave is Flume 1.11.0, gepubliceerd op 25 oktober 2022 en verkrijgbaar via de Apache Flume downloadpaginaDeze handleiding is geschreven voor versie 1.4.0, dus bij een aantal stappen hieronder staat vermeld waar een recentere versie zich anders gedraagt.
Flume Architectuur
Een Flume-agent is een JVM Een proces met drie componenten – een stroombron, een stroomkanaal en een stroomafvoer – waardoor gebeurtenissen zich voortplanten nadat ze bij een externe bron zijn geïnitieerd. Het onderstaande diagram laat zien hoe ze met elkaar verbonden zijn.
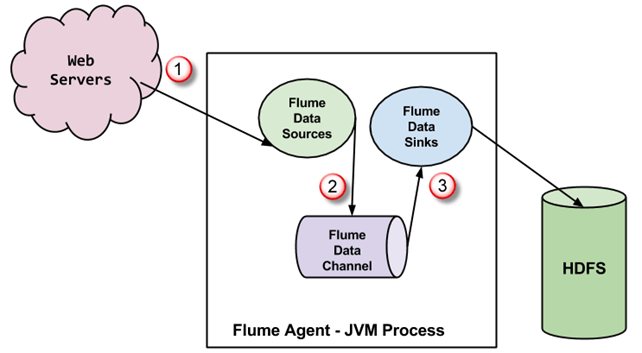
- De gebeurtenissen die door de externe bron (een webserver) worden gegenereerd, worden door de Flume-bron verwerkt. De externe bron stuurt gebeurtenissen naar de Flume-bron in een formaat dat de doelbron herkent.
- De Flume-bron ontvangt een gebeurtenis en slaat deze op in een of meer kanalen. Het kanaal fungeert als een opslagplaats waar de gebeurtenis wordt bewaard totdat deze door de Flume-bestemming wordt verwerkt. Dit kanaal kan een lokaal bestandssysteem gebruiken om deze gebeurtenissen op te slaan.
- De Flume-sink verwijdert de gebeurtenis uit een kanaal en slaat deze op in een externe opslagplaats, zoals HDFS. Er kunnen meerdere Flume-agents zijn; in dat geval stuurt de Flume-sink de gebeurtenis door naar de Flume-bron van de volgende agent in de flow.
Enkele belangrijke kenmerken van een watergoot
- Flume heeft een flexibel ontwerp gebaseerd op streaming dataflows. Het is fouttolerant en robuust, met meerdere failover- en herstelmechanismen. Flume biedt verschillende betrouwbaarheidsniveaus, waaronder 'best effort levering' en 'end-to-end levering'. Best mogelijke levering tolereert geen enkele Flume-knooppuntstoring, terwijl end-to-end levering Garandeert levering, zelfs in geval van meerdere knooppuntstoringen.
- Flume transporteert data tussen bronnen en bestemmingen. Deze dataverzameling kan gepland of gebeurtenisgestuurd zijn. Flume heeft een eigen queryverwerkingsengine, waardoor elke nieuwe batch data eenvoudig kan worden getransformeerd voordat deze naar de beoogde bestemming wordt overgebracht.
- Mogelijk Flume zinkt inclusief HDFS en HBaseFlume kan ook gebeurtenisgegevens transporteren, zoals netwerkverkeersgegevens, gegevens gegenereerd door sociale mediawebsites en e-mailberichten.
Installatie van Flume, bibliotheek en broncode
Voordat we met het eigenlijke proces beginnen, moet u ervoor zorgen dat Hadoop is geïnstalleerd; zo niet, volg dan deze stappen. Hoe installeer ik Hadoop? Ten eerste: wijzig de gebruiker naar 'hduser' (de ID die werd gebruikt tijdens de configuratie van Hadoop; u kunt overschakelen naar de gebruikers-ID die werd gebruikt tijdens uw eigen Hadoop-configuratie).

Stap 1) Maak een nieuwe map aan met de naam 'FlumeTutorial'.
sudo mkdir FlumeTutorial
- Geef lees-, schrijf- en uitvoerrechten.
sudo chmod -R 777 FlumeTutorial
- Kopieer de bestanden MijnTwitterSource.java en MijnTwitterSourceForFlume.java in deze map.
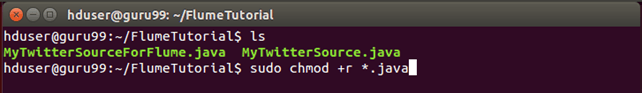
Controleer de bestandsrechten van al deze bestanden, zoals hieronder weergegeven, en verleen leesrechten als deze ontbreken.
Stap 2) Download 'Apache Flume' van https://flume.apache.org/download.html.
In deze Flume-tutorial is Apache Flume 1.4.0 gebruikt.

Klik vervolgens door naar een spiegelkopie.

Stap 3) Kopieer het gedownloade tarball-bestand naar de map van uw keuze en voer het uit.tract de inhoud met behulp van de volgende opdracht.
sudo tar -xvf apache-flume-1.4.0-bin.tar.gz

Dit creëert een nieuwe map met de naam apache-flume-1.4.0-bin en extracts de bestanden erin. Die map wordt aangeduid als in de rest van het artikel.
Stap 4) Installatie van de Flume-bibliotheek. Kopieer de bestanden twitter4j-core-4.0.1.jar, flume-ng-configuration-1.4.0.jar, flume-ng-core-1.4.0.jar en flume-ng-sdk-1.4.0.jar naar de juiste locatie.
/lib/
Een of meerdere van de gekopieerde JAR-bestanden kunnen uitvoerrechten hebben, wat problemen kan veroorzaken bij het compileren van de code. Trek deze rechten daarom in. In mijn geval had twitter4j-core-4.0.1.jar uitvoerrechten. Ik heb deze ingetrokken zoals hieronder beschreven.
sudo chmod -x twitter4j-core-4.0.1.jar

Hierna geeft het onderstaande commando iedereen leesrechten op twitter4j-core-4.0.1.jar.
sudo chmod +rrr /usr/local/apache-flume-1.4.0-bin/lib/twitter4j-core-4.0.1.jar
Let op: ik heb twitter4j-core-4.0.1.jar gedownload van Maven-repositoryen alle Flume JAR-bestanden, bijvoorbeeld flume-ng-*-1.4.0.jar, van de org.apache.flume-artefacten.
Laad gegevens van Twitter met Flume
Stap 1) Ga naar de map met de broncodebestanden.
Stap 2) Stel CLASSPATH in op de volgende inhoud: /lib/* en ~/FlumeTutorial/flume/mytwittersource/*.
export CLASSPATH="/usr/local/apache-flume-1.4.0-bin/lib/*:~/FlumeTutorial/flume/mytwittersource/*"

Stap 3) Compileer de broncode met behulp van de onderstaande opdracht.
javac -d . MyTwitterSourceForFlume.java MyTwitterSource.java

Stap 4) Maak een JAR-bestand aan. Maak eerst een Manifest.txt-bestand aan met een teksteditor naar keuze en voeg de onderstaande regel eraan toe.
Main-Class: flume.mytwittersource.MyTwitterSourceForFlume
Hier is flume.mytwittersource.MyTwitterSourceForFlume de naam van de hoofdklasse. Let op: u moet aan het einde van deze regel op de enter-toets drukken, zoals hieronder weergegeven.

Maak nu het JAR-bestand 'MyTwitterSourceForFlume.jar' als volgt aan.
jar cfm MyTwitterSourceForFlume.jar Manifest.txt flume/mytwittersource/*.class

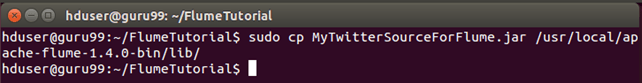
Stap 5) Kopieer dit JAR-bestand naar /lib/.
sudo cp MyTwitterSourceForFlume.jar <Flume Installation Directory>/lib/
Stap 6) Ga naar de configuratiemap van Flume. /conf.
Als het bestand flume.conf niet bestaat, kopieer dan flume-conf.properties.template en hernoem het naar flume.conf.
sudo cp flume-conf.properties.template flume.conf

Als flume-env.sh niet bestaat, kopieer dan flume-env.sh.template en hernoem het naar flume-env.sh.
sudo cp flume-env.sh.template flume-env.sh

Een Twitter-applicatie maken
Lees dit eerst. De v1.1 streaming statuses/filter Het eindpunt dat twitter4j 4.0.1 nodig had, is op 9 maart 2023 buiten gebruik gesteld. De API v2 filtered stream die het heeft vervangen, is nu beschikbaar op developer.x.comDeze functie is alleen beschikbaar tegen betaling. Beschouw de onderstaande schermen als een voorbeeld van een aangepaste bron en laat dezelfde agent vervolgens verwijzen naar een bestand, een uitvoerbaar bestand of een Kafka-bron.
Stap 1) Maak een Twitter-applicatie aan door in te loggen op het ontwikkelaarsportaal.


Stap 2) Ga naar 'Mijn applicaties' (deze optie verschijnt wanneer je op de knop 'Ei' rechtsboven klikt).

Stap 3) Maak een nieuwe applicatie aan door op 'Nieuwe app maken' te klikken.
Stap 4) Vul de aanvraaggegevens in door de naam van de aanvraag, een beschrijving en een website op te geven. U kunt de toelichting onder elk invoerveld raadplegen.
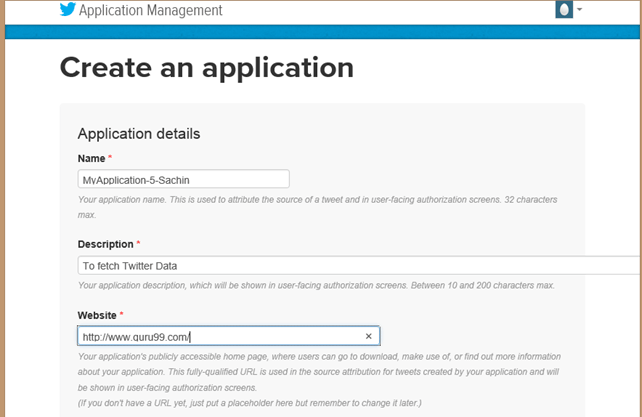
Stap 5) Scroll naar beneden, ga akkoord met de voorwaarden door 'Ja, ik ga akkoord' aan te vinken en klik op de knop 'Maak je Twitter-applicatie aan'.

Stap 6) Ga in het venster van de zojuist aangemaakte applicatie naar het tabblad 'API-sleutels', scroll naar beneden en klik op de knop 'Mijn toegangstoken aanmaken'.


Stap 7) Ververs de pagina.
Stap 8) Klik op 'Test OAuth'. Hiermee worden de 'OAuth'-instellingen van de applicatie weergegeven.

Stap 9) Wijzig 'flume.conf' met behulp van deze OAuth-instellingen. De stappen om 'flume.conf' te wijzigen worden hieronder beschreven.

Om 'flume.conf' bij te werken, moeten we de consumentensleutel, het consumentengeheim, het toegangstoken en het toegangstokengeheim kopiëren.
Let op: deze waarden zijn eigendom van de gebruiker en daarom vertrouwelijk. Ze mogen niet worden gedeeld.
Wijzig het bestand 'flume.conf'
Stap 1) Open 'flume.conf' in schrijfmodus en stel de waarden in voor de onderstaande parameters.
sudo gedit flume.conf
Kopieer de onderstaande inhoud.
MyTwitAgent.sources = Twitter
MyTwitAgent.channels = MemChannel
MyTwitAgent.sinks = HDFS
MyTwitAgent.sources.Twitter.type = flume.mytwittersource.MyTwitterSourceForFlume
MyTwitAgent.sources.Twitter.channels = MemChannel
MyTwitAgent.sources.Twitter.consumerKey = <Copy consumer key value from Twitter App>
MyTwitAgent.sources.Twitter.consumerSecret = <Copy consumer secret value from Twitter App>
MyTwitAgent.sources.Twitter.accessToken = <Copy access token value from Twitter App>
MyTwitAgent.sources.Twitter.accessTokenSecret = <Copy access token secret value from Twitter App>
MyTwitAgent.sources.Twitter.keywords = guru99
MyTwitAgent.sinks.HDFS.channel = MemChannel
MyTwitAgent.sinks.HDFS.type = hdfs
MyTwitAgent.sinks.HDFS.hdfs.path = hdfs://localhost:54310/user/hduser/flume/tweets/
MyTwitAgent.sinks.HDFS.hdfs.fileType = DataStream
MyTwitAgent.sinks.HDFS.hdfs.writeFormat = Text
MyTwitAgent.sinks.HDFS.hdfs.batchSize = 1000
MyTwitAgent.sinks.HDFS.hdfs.rollSize = 0
MyTwitAgent.sinks.HDFS.hdfs.rollCount = 10000
MyTwitAgent.channels.MemChannel.type = memory
MyTwitAgent.channels.MemChannel.capacity = 10000
MyTwitAgent.channels.MemChannel.transactionCapacity = 1000

Stap 2) Stel TwitterAgent.sinks.HDFS.hdfs.path ook als volgt in.
TwitterAgent.sinks.HDFS.hdfs.path = hdfs:// : / /flume/tweets/

Om te vinden , En Zie de waarde van de parameter 'fs.defaultFS' die is ingesteld in $HADOOP_HOME/etc/hadoop/core-site.xml, zoals hieronder weergegeven.

Stap 3) Om de gegevens naar HDFS te schrijven zodra ze binnenkomen, verwijdert u de onderstaande vermelding indien deze bestaat.
TwitterAgent.sinks.HDFS.hdfs.rollInterval = 600
Voorbeeld: Twitter-gegevens streamen met Flume
Stap 1) Open 'flume-env.sh' in schrijfmodus en stel de waarden in voor de onderstaande parameters.
JAVA_HOME=<Installation directory of Java>
FLUME_CLASSPATH="<Flume Installation Directory>/lib/MyTwitterSourceForFlume.jar"

Stap 2) Start Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Stap 3) Twee van de JAR-bestanden uit het Flume-tarball zijn niet compatibel met Hadoop 2.2.0. Daarom volgen we in dit Apache Flume-voorbeeld de onderstaande stappen om Flume compatibel te maken met Hadoop 2.2.0. Deze JAR-vervanging is een oplossing voor versie 1.4.0; Flume 1.11.0 bevat al de meest recente protobuf- en Guava-builds, dus een modern tarball heeft dit normaal gesproken niet meer nodig.
a. Verplaats protobuf-java-2.4.1.jar uit ' Ga eerst naar de map '/lib'.
CD /lib
sudo mv protobuf-java-2.4.1.jar ~/

b. Zoek het JAR-bestand 'guava' zoals hieronder weergegeven.
find . -name "guava*"

Verplaats guava-10.0.1.jar uit ' /lib'.
sudo mv guava-10.0.1.jar ~/

c. Download guava-17.0.jar van Maven-repository, hieronder weergegeven.

Kopieer nu dit gedownloade JAR-bestand naar ' /lib'.
Stap 4) Ga naar ' /bin' en start Flume als volgt.
./flume-ng agent -n MyTwitAgent -c conf -f <Flume Installation Directory>/conf/flume.conf

Het opdrachtpromptvenster waarin Flume tweets ophaalt, ziet er als volgt uit.

Uit het bericht in het opdrachtvenster kunnen we opmaken dat de uitvoer naar de map /user/hduser/flume/tweets/ wordt geschreven. Open deze map nu met een webbrowser.
Stap 5) Om het resultaat van het laden van de gegevens te bekijken, opent u http://localhost:50070/ in een browser, navigeert u door het bestandssysteem en gaat u vervolgens naar de map waar de gegevens zijn geladen, dat wil zeggen
/flume/tweets/
Poort 50070 is de webinterface van de NameNode op Hadoop 2; Hadoop 3 verplaatste dezelfde pagina naar poort 9870.

Flume is de helft van de inname: Duik importeert tabellen in batches, Flume streamt gebeurtenissen, en vervolgens Varken or Bijenkorf vorm de bestanden en oozie plant de keten in. Zie ook tools voor big data-analyse, MapReduce-joins en tellers en Talend.
