
단어 임베딩 및 Word2Vec 예제
 에블린 클라크
⚡ 스마트 요약
단어 임베딩과 Word2Vec은 텍스트를 밀집된 숫자 벡터로 변환하여 머신러닝 모델이 유사한 의미를 가진 단어를 인식할 수 있도록 합니다. 이 자료에서는 해당 기법, CBOW 및 Skip-Gram 아키텍처, 활성화 함수, 그리고 실제 응용 프로그램을 위한 Gensim 구현 예제를 설명합니다.
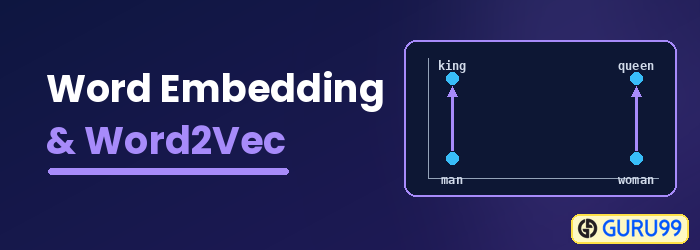
워드 임베딩이란 무엇입니까?
워드 임베딩 단어 임베딩은 기계 학습 알고리즘이 유사한 의미를 가진 단어를 이해할 수 있도록 하는 단어 표현 유형입니다. 이는 신경망, 확률 모델 또는 단어 동시 발생 행렬의 차원 축소를 사용하여 단어를 실수 벡터로 매핑하는 언어 모델링 및 특징 학습 기법입니다. Word2vec(Google), GloVe(스탠포드), fastText(페이스북) 등이 있습니다.
워드 임베딩은 분산 의미 모델, 분산 표현 모델, 의미 벡터 공간 또는 벡터 공간 모델이라고도 불립니다. 이러한 명칭들을 읽다 보면 워드 임베딩이라는 단어를 접하게 됩니다. 워드 임베딩은 워드 임베딩이라는 단어를 통해 접하게 되는 개념입니다. 시맨틱이는 유사한 단어들을 함께 분류하는 것을 의미합니다. 예를 들어, 사과, 망고, 바나나와 같은 과일은 서로 가까이 배치되는 반면, 책은 이러한 과일들과 멀리 떨어져 배치됩니다. 더 넓은 의미에서, 단어 임베딩은 과일 벡터를 생성하는데, 이 벡터는 책 벡터와 멀리 떨어져 있게 됩니다.
워드 임베딩은 어디에 사용되나요?
단어 임베딩은 특징 생성, 문서 클러스터링, 텍스트 분류 및 자연어 처리 작업에 도움이 됩니다. 이러한 응용 분야를 나열하고 각각에 대해 논의해 보겠습니다.
- 비슷한 단어를 계산합니다. 단어 임베딩은 예측 모델이 다룰 단어와 유사한 단어를 제안하는 데 사용됩니다. 뿐만 아니라, 유사하지 않은 단어와 가장 흔하게 사용되는 단어도 제안합니다.
- 관련 단어 그룹을 만듭니다. 의미 그룹에 사용됩니다.ping비슷한 특징을 가진 것들을 함께 묶고, 서로 다른 특징을 가진 것들은 멀리 떨어뜨려 놓는 기능입니다.
- 텍스트 분류 기능: 텍스트는 벡터 배열로 매핑되어 모델 학습 및 예측에 사용됩니다. 텍스트 기반 분류 모델은 문자열로는 학습할 수 없으므로, 이 과정을 통해 텍스트를 기계 학습이 가능한 형태로 변환합니다. 또한, 텍스트에 포함된 의미론적 특징들은 텍스트 기반 분류 성능을 향상시킵니다.
- 문서 클러스터링: 이것은 Word Embedding과 Word2vec이 널리 사용되는 또 다른 응용 분야입니다.
- 자연 언어 처리: 단어 삽입이 유용하고 기능 추출보다 나은 경우가 많습니다.trac품사 태깅, 감정 분석, 구문 분석과 같은 단계들이 포함됩니다.
이제 단어 임베딩이 어디에 적용되는지 이해했으니, 이러한 임베딩을 생성하는 데 사용되는 가장 인기 있는 모델을 살펴보겠습니다.
Word2vec이란 무엇입니까?
워드투벡 단어 임베딩은 단어 표현을 개선하기 위해 단어 임베딩을 생성하는 기술 또는 모델입니다. 이는 단어 간의 정확한 구문적, 의미적 관계를 포착하는 자연어 처리 방법입니다. 단순 2층 구조의 신경망으로, 학습을 통해 동의어를 탐지하고 불완전한 문장에 대한 추가 단어를 제안할 수 있습니다.
더 진행하기 전에 아래 단어 임베딩 예시 다이어그램에 나와 있는 얕은 신경망과 깊은 신경망의 차이점을 살펴보시기 바랍니다.
얕은 신경망은 입력과 출력 사이에 하나의 은닉층만 가지는 반면, 깊은 신경망은 입력과 출력 사이에 여러 개의 은닉층을 가집니다. 입력은 노드를 통해 전달되며, 은닉층과 출력층은 뉴런으로 구성됩니다.
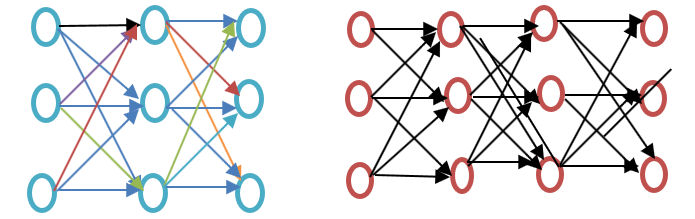
Word2vec은 입력층, 은닉층 하나, 출력층으로 구성된 2층 네트워크입니다.
Word2vec은 Tomas Mikolov가 이끄는 연구팀에 의해 개발되었습니다. GoogleWord2vec은 잠재 의미 분석 모델보다 더 우수하고 효율적입니다.
왜 Word2vec인가?
Word2vec은 단어를 벡터 공간 표현으로 나타냅니다. 단어는 벡터 형태로 표현되며, 의미가 비슷한 단어는 함께 배치되고 의미가 다른 단어는 멀리 떨어지도록 배치됩니다. 이를 의미론적 관계라고도 합니다. 신경망은 텍스트를 이해하지 못하고 숫자만 이해합니다. 단어 임베딩은 텍스트를 숫자 벡터로 변환하는 방법을 제공합니다.
Word2vec은 단어의 언어적 맥락을 재구성합니다. 더 자세히 알아보기 전에 언어적 맥락이 무엇인지 이해해 보겠습니다. 일반적으로 우리가 말하거나 글을 써서 소통할 때, 상대방은 문장의 목적을 파악하려고 합니다. 예를 들어, "인도의 기온은 몇 도입니까?"라는 질문에서 문맥은 사용자가 "인도의 기온"을 알고 싶어 한다는 것입니다. 즉, 문장의 핵심 목적은 문맥에 있습니다. 말이나 글을 둘러싼 주변 단어나 문장들은 문맥의 의미를 파악하는 데 도움을 줍니다. Word2vec은 이러한 문맥을 통해 단어의 벡터 표현을 학습합니다.
Word2vec은 무엇을 합니까?
워드 임베딩 전
단어 임베딩 이전에 사용되었던 접근 방식과 그 단점을 아는 것이 중요합니다. 그런 다음 Word2vec 접근 방식을 사용한 단어 임베딩이 이러한 단점을 어떻게 극복하는지 살펴보겠습니다. 마지막으로 Word2vec의 작동 방식을 이해하는 것이 중요하므로 이에 대해 알아보겠습니다.
잠재 의미 분석을 위한 접근 방식
이는 단어 임베딩 이전에 사용되었던 접근 방식입니다. 단어를 인코딩된 벡터 형태로 표현하는 '단어 모음(Bag of Words)' 개념을 사용합니다. 이 벡터는 어휘 크기와 동일한 차원을 가진 희소 벡터 표현입니다. 단어가 사전에 존재하면 카운트되고, 그렇지 않으면 카운트되지 않습니다. 더 자세한 내용은 아래 프로그램을 참조하십시오.
Word2vec 예

from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer()
data_corpus = ["guru99 is the best site for online tutorials. I love to visit guru99."]
vocabulary = vectorizer.fit(data_corpus)
X = vectorizer.transform(data_corpus)

print(X.toarray())
print(vectorizer.get_feature_names_out())
출력:
[[1 2 1 1 1 1 1 1 1 1]]
[u'best', u'guru99', u'is', u'love', u'online', u'sitefor', u'the', u'to', u'tutorials', u'visit']
Code 설명
- CountVectorizer는 단어들을 벡터화하여 어휘를 저장하는 데 사용되는 모듈입니다. 이 모듈은 sklearn에서 가져옵니다.
- CountVectorizer 클래스를 사용하여 객체를 만듭니다.
- CountVectorizer에 입력할 데이터를 리스트에 작성하세요.
- 데이터는 CountVectorizer 클래스에서 생성된 개체에 맞습니다.
- 어휘집을 사용하여 데이터 내 단어 수를 세는 데 단어 모음(bag-of-words) 방식을 적용합니다. 단어나 토큰이 어휘집에 없는 경우 해당 인덱스 위치는 0으로 설정됩니다.
- 5번째 줄의 변수 x는 배열로 변환됩니다(x에 사용 가능한 메서드). 이를 통해 3번째 줄에 제공된 문장 또는 목록에 있는 각 토큰의 개수를 얻을 수 있습니다.
- 이는 4번째 줄의 데이터를 사용하여 어휘를 적합시켰을 때 어휘에 포함되는 특징들을 보여줍니다.
잠재 의미론적 접근법에서 행은 고유한 단어를 나타내고, 열은 해당 단어가 문서에 나타나는 횟수를 나타냅니다. 이는 문서를 행렬 형태로 표현한 것입니다. TF-IDF(Term Frequency-Inverse Document Frequency)는 문서 내 단어 빈도를 계산하는 데 사용되며, 이는 문서 내 단어 빈도를 전체 코퍼스 내 단어 빈도로 나눈 값입니다.
Bag of Words 방식의 단점
- 단어의 순서를 무시합니다. 예를 들어, 이건 나쁘다 = 이건 나쁜 거야.
- 이 방법은 단어의 맥락을 무시합니다. 예를 들어 "그는 책을 사랑했다. 교육은 책에서 가장 잘 찾을 수 있다."라는 문장을 썼다고 가정해 봅시다. 그러면 "그는 책을 사랑했다"와 "교육은 책에서 가장 잘 찾을 수 있다"라는 두 개의 벡터가 생성됩니다. 이 방법은 두 벡터를 서로 직교하는 것으로 취급하여 독립적인 것으로 만들지만, 실제로는 서로 관련되어 있습니다.
이러한 한계를 극복하기 위해 단어 임베딩 기술이 개발되었으며, Word2vec은 이를 구현하는 데 사용되는 접근 방식 중 하나입니다.
Word2vec은 어떻게 작동하나요?
Word2vec은 단어가 사용되는 주변 맥락을 예측하여 단어를 학습합니다. 예를 들어, "He"라는 단어를 살펴보겠습니다. loves 축구."
우리는 다음 단어에 대한 Word2vec 값을 계산하고 싶습니다: loves.
다음을 가정하십시오.
loves = Vin. P(Vout / Vin) is calculated
where,
Vin is the input word.
P is the probability of likelihood.
Vout is the output word.
단어 loves 이 도구는 코퍼스에 있는 각 단어를 차례로 탐색합니다. 단어 간의 구문적 및 의미적 관계가 인코딩됩니다. 이를 통해 유사하거나 유추할 수 있는 단어를 찾을 수 있습니다.
단어의 모든 무작위 기능 loves 이러한 특징들은 계산됩니다. 이 특징들은 인접 단어나 문맥 단어에 따라 변경되거나 업데이트됩니다. 역전파 방법.
또 다른 학습 방법은 두 단어의 문맥이 비슷하거나 두 단어가 비슷한 특징을 가지고 있다면 그 두 단어는 관련이 있다는 것입니다.
워드투벡 Archi강의
Word2vec에서는 두 가지 아키텍처가 사용됩니다.
- 연속 단어 백(CBOW)
- 스킵그램
더 자세히 살펴보기 전에, 단어 표현이라는 관점에서 이러한 아키텍처 또는 모델이 왜 중요한지 논의해 보겠습니다. 단어 표현 학습은 본질적으로 비지도 학습이지만, 모델을 학습시키기 위해서는 목표값/레이블이 필요합니다. Skip-gram과 CBOW는 비지도 표현을 모델 학습에 필요한 지도 표현 형태로 변환합니다.
CBOW에서 현재 단어는 주변 컨텍스트 창의 창을 사용하여 예측됩니다. 예를 들어, wI-1, wI-2, wi + 1, wi + 2 단어나 문맥이 주어지면 이 모델은 다음을 제공합니다.i.
Skip-Gram은 CBOW와 정반대로 작동합니다. 즉, 단어에서 주어진 순서나 문맥을 예측한다는 의미입니다. 예시를 반대로 생각하면 이해하기 쉽습니다. 만약 wi 주어진 값을 바탕으로 맥락을 예측하거나, 아니면 wI-1, wI-2, wi + 1, wi + 2.
Word2vec은 CBOW(Continuous Bag of Words)와 skip-gram 중에서 선택할 수 있는 옵션을 제공합니다. 이러한 매개변수는 모델 학습 중에 제공됩니다. 또한 네거티브 샘플링 또는 계층적 소프트맥스 레이어를 사용할 수도 있습니다.
연속 단어 가방
연속적인 단어 모음 아키텍처를 이해하기 위해 Word2vec의 간단한 예시 다이어그램을 그려보겠습니다.

방정식을 수학적으로 계산해 보겠습니다. V가 어휘 크기이고 N이 은닉층 크기라고 가정합니다. 입력은 다음과 같이 정의됩니다. { xI-1, XI-2, Xi + 1, Xi + 2 V * N을 곱하여 가중치 행렬을 얻습니다. 또 다른 행렬은 입력 벡터에 가중치 행렬을 곱하여 얻습니다. 이는 다음 방정식으로도 이해할 수 있습니다.
h = xitW
어디 xit 여기서 W는 각각 입력 벡터와 가중치 행렬입니다.
문맥과 바로 다음 단어의 일치율을 계산하려면 아래 공식을 참조하십시오.
u = 예측 표현 * h
여기서 예측 표현은 위 방정식의 모델로부터 얻어집니다.
스킵그램 모델
Skip-Gram 방식은 입력된 단어를 바탕으로 문장을 예측하는 데 사용됩니다. 이를 더 잘 이해하기 위해 아래 Word2vec 예제에 나와 있는 다이어그램을 그려 보겠습니다.

이 모델은 입력이 단어이고 모델이 문맥 또는 시퀀스를 제공하는 연속 단어 모음(Continuous Bag of Words) 모델의 역으로 볼 수 있습니다. 즉, 목표값이 입력으로 제공되고 출력 계층은 선택된 문맥 단어 수에 맞춰 여러 번 복제됩니다. 모든 출력 계층의 오류 벡터를 합산하여 역전파 방식을 통해 가중치를 조정합니다.
어떤 모델을 선택할 것인가?
CBOW는 skip-gram보다 몇 배 더 빠르며 빈번하게 사용되는 단어의 빈도를 더 잘 나타냅니다. 반면 skip-gram은 적은 양의 학습 데이터로도 드문 단어나 구까지 표현할 수 있습니다. 아래 표에서 두 아키텍처를 한눈에 비교해 볼 수 있습니다.
| 아래 | CBOW | 스킵그램 |
|---|---|---|
| 예측 | 문맥을 통해 목표 단어를 예측합니다. | 목표 단어를 통해 문맥을 예측합니다. |
| 훈련 속도 | 빠른 | 느린 |
| 자주 쓰이는 단어 | 더 높은 정확도 | 낮은 정확도 |
| 희귀한 단어 | 약한 대표성 | 더 강력한 대표성 |
| 훈련 데이터 | 더 많은 데이터가 필요합니다 | 더 적은 데이터로도 작동합니다 |
Word2vec과 NLTK의 관계
NLTK 자연이다 Language Tool이 키트는 텍스트 전처리에 사용됩니다. 품사 태깅, 어근 추출, 어간 추출, 불용어 제거, 사용 빈도가 낮은 단어 제거 등 다양한 작업을 수행할 수 있습니다. 텍스트를 정리하고 효과적인 단어에서 특징을 추출하는 데 도움이 됩니다. 반면 Word2vec은 의미론적(밀접하게 관련된 항목끼리) 및 구문론적(순서) 매칭에 사용됩니다. Word2vec을 사용하면 유사어, 비유사어, 차원 축소 등 다양한 작업을 수행할 수 있습니다. Word2vec의 또 다른 중요한 기능은 텍스트의 고차원 표현을 저차원 벡터로 변환하는 것입니다.
NLTK와 Word2vec을 어디에서 사용합니까?
위에서 언급한 토큰화, 품사 태깅, 구문 분석과 같은 일반적인 작업을 수행해야 하는 경우에는 NLTK를 사용해야 하며, 문맥에 따른 단어 예측, 토픽 모델링 또는 문서 유사성 분석에는 Word2vec을 사용해야 합니다.
코드의 도움으로 NLTK와 Word2vec의 관계
NLTK와 Word2vec은 함께 사용하여 유사한 단어 표현이나 구문적 일치를 찾을 수 있습니다. NLTK 툴킷을 사용하면 NLTK에 포함된 여러 패키지를 불러올 수 있으며, Word2vec을 사용하여 모델을 생성할 수 있습니다. 그런 다음 실시간 단어에 대해 모델을 테스트할 수 있습니다. 다음 코드에서 두 가지를 함께 사용하는 방법을 살펴보겠습니다. 더 진행하기 전에 NLTK에서 제공하는 코퍼스를 살펴보시기 바랍니다. 다음 명령어를 사용하여 다운로드할 수 있습니다.
nltk(nltk.download('all'))

코드는 스크린샷을 참조하세요.
import nltk
import gensim
from nltk.corpus import abc

model = gensim.models.Word2Vec(abc.sents())
X = list(model.wv.vocab)
data = model.most_similar('science')
print(data)

출력:
[('law', 0.9415997266769409), ('practice', 0.9276568293571472), ('discussion', 0.9259148836135864), ('agriculture', 0.9257254004478455), ('media', 0.9232194423675537), ('policy', 0.922248125076294), ('general', 0.9166069030761719), ('undertaking', 0.916458249092102), ('tight', 0.9129181504249573), ('board', 0.9107444286346436)]
설명 Code
- nltk 라이브러리가 임포트되었으며, 여기에서 다음 단계에서 사용할 abc 코퍼스를 다운로드할 수 있습니다.
- Gensim이 임포트되었습니다. Gensim Word2vec이 설치되어 있지 않은 경우, "pip3 install gensim" 명령어를 사용하여 설치하십시오. 아래 스크린샷을 참조하십시오.

- nltk.download('abc')를 사용하여 다운로드한 abc 코퍼스를 가져옵니다.
- Gensim을 사용하여 가져온 Word2vec 모델에 파일을 문장 형태로 전달합니다.
- 어휘는 변수 형태로 저장됩니다.
- 해당 모델은 샘플 단어를 사용하여 테스트되었습니다. 과학이 파일들은 과학과 관련이 있기 때문입니다.
- 여기서 모델은 "과학"이라는 유사한 단어를 예측합니다.
활성기 및 Word2Vec
뉴런의 활성화 함수는 주어진 입력에 대한 해당 뉴런의 출력을 정의합니다. 이는 우리 뇌의 활동에서 영감을 얻은 것으로, 뇌에서는 서로 다른 자극에 따라 서로 다른 뉴런이 활성화됩니다. 다음 그림을 통해 활성화 함수를 이해해 보겠습니다.

여기서 x1, x2, … x4는 신경망의 노드입니다.
w1, w2, w3는 노드의 가중치입니다.
모든 가중치와 노드 값의 합(Σ)이 활성화 함수 역할을 합니다.
활성화 기능이 필요한 이유는 무엇입니까?
활성화 함수를 사용하지 않으면 출력은 선형이 되지만, 선형 함수의 기능에는 한계가 있습니다. 객체 탐지, 이미지 분류와 같은 복잡한 기능을 구현하려면 다양한 활성화 함수를 사용해야 합니다.ping 음성을 이용한 텍스트 출력 및 기타 여러 비선형 출력에는 활성화 함수가 필요합니다.
단어 임베딩(Word2vec)에서 활성화 레이어를 계산하는 방법
소프트맥스 레이어(정규화된 지수 함수)는 각 노드를 활성화하거나 작동시키는 출력 레이어 함수입니다. 또 다른 접근 방식으로는 계층적 소프트맥스가 있으며, 이 경우 시간 복잡도는 O(log)입니다.2소프트맥스에서는 O(V)인 반면, 계층적 소프트맥스에서는 O(V)입니다. 이 둘의 차이점은 계층적 소프트맥스 레이어의 복잡성 감소에 있습니다. 그 기능을 이해하려면 아래 단어 임베딩 예제를 참조하십시오.

단어를 관찰할 확률을 계산한다고 가정합니다. 사랑과 특정 컨텍스트가 주어졌을 때, 루트 노드에서 리프 노드로의 흐름은 먼저 노드 2를 거쳐 노드 5로 이동합니다. 따라서 어휘 크기가 8인 경우 세 번의 계산만 필요합니다. 이를 통해 단어 하나의 확률 계산을 분해할 수 있습니다.사랑과).
계층적 소프트맥스 이외에 어떤 다른 옵션을 사용할 수 있나요?
일반적으로 사용 가능한 단어 임베딩 옵션에는 미분 소프트맥스, CNN-소프트맥스, 중요도 샘플링, 적응형 중요도 샘플링, 노이즈 대비 추정, 네거티브 샘플링, 자체 정규화 및 비빈도 정규화가 있습니다.
Word2vec에 대해 구체적으로 말씀드리자면, 저희는 네거티브 샘플링을 사용할 수 있습니다.
네거티브 샘플링은 훈련 데이터를 샘플링하는 한 방법입니다. 확률적 경사 하강법과 유사하지만 몇 가지 차이점이 있습니다. 네거티브 샘플링은 부정적인 훈련 예제만 찾습니다. 이는 노이즈 대비 추정에 기반하며 문맥에 포함되지 않은 단어를 무작위로 샘플링합니다. 빠른 훈련 방법이며 문맥을 무작위로 선택합니다. 예측된 단어가 무작위로 선택된 문맥에 나타나면 두 벡터는 서로 가까워집니다.
어떤 결론을 내릴 수 있습니까?
액티베이터는 외부 자극에 의해 뉴런이 활성화되는 방식과 유사하게 뉴런을 활성화합니다. 소프트맥스 레이어는 단어 임베딩의 경우 뉴런을 활성화하는 출력 레이어 함수 중 하나입니다. Word2vec에서는 계층적 소프트맥스 및 네거티브 샘플링과 같은 옵션을 제공합니다. 액티베이터를 사용하면 선형 함수를 비선형 함수로 변환할 수 있으며, 이러한 함수를 활용하여 복잡한 머신러닝 알고리즘을 구현할 수 있습니다.
젠심이란 무엇인가요?
겐심 는 오픈 소스 주제 모델링 및 자연어 처리 도구 키트로 구현됩니다. Python 또한 Cython도 지원합니다. Gensim 툴킷을 사용하면 Word2vec을 가져와 토픽 모델링을 통해 텍스트 본문에 숨겨진 구조를 발견할 수 있습니다. Gensim은 Word2vec뿐만 아니라 Doc2vec 및 FastText도 구현하여 제공합니다.
이 섹션은 Word2vec에 초점을 맞추고 있으므로 현재 주제에 집중하겠습니다.
Gensim을 사용하여 Word2vec을 구현하는 방법
지금까지 우리는 Word2vec이 무엇인지, 다양한 아키텍처, 단어 모음(bag of words)에서 Word2vec으로 전환하는 이유, Word2vec과 NLTK의 라이브 코드와의 관계, 그리고 활성화 함수에 대해 논의했습니다.
Gensim을 사용하여 Word2vec을 구현하는 단계별 방법은 다음과 같습니다.
1단계) 데이터 수집
머신러닝 모델을 구현하거나 자연어 처리를 구현하는 첫 번째 단계는 데이터 수집입니다.
아래 Gensim Word2vec 예제에서 보이는 것처럼 지능형 챗봇을 구축하기 위해 데이터를 관찰해 보세요.
[{"tag": "welcome",
"patterns": ["Hi", "How are you", "Is any one to talk?", "Hello", "hi are you available"],
"responses": ["Hello, thanks for contacting us", "Good to see you here", "Hi there, how may I assist you?"]
        },
{"tag": "goodbye",
"patterns": ["Bye", "See you later", "Goodbye", "I will come back soon"],
"responses": ["See you later, thanks for visiting", "have a great day ahead", "Wish you Come back again soon."]
        },
{"tag": "thankful",
"patterns": ["Thanks for helping me", "Thank your guidance", "That's helpful and kind from you"],
"responses": ["Happy to help!", "Any time!", "My pleasure", "It is my duty to help you"]
        },
        {"tag": "hoursopening",
"patterns": ["What hours are you open?", "Tell your opening time?", "When are you open?", "Just your timing please"],
"responses": ["We're open every day 8am-7pm", "Our office hours are 8am-7pm every day", "We open office at 8 am and close at 7 pm"]
        },
{"tag": "payments",
"patterns": ["Can I pay using credit card?", "Can I pay using Mastercard?", "Can I pay using cash only?"],
"responses": ["We accept VISA, Mastercard and credit card", "We accept credit card, debit cards and cash. Please don't worry"]
        }
   ]
데이터 분석을 통해 다음과 같은 사실을 알 수 있었습니다.
- 이 데이터에는 태그, 패턴, 응답이라는 세 가지 요소가 포함되어 있습니다. 태그는 의도(토론 주제)를 나타냅니다.
- 데이터는 JSON 형식입니다.
- 패턴이란 사용자가 봇에게 묻는 질문입니다.
- 응답은 챗봇이 해당 질문/패턴에 대해 제공하는 답변입니다.
2단계) 데이터 전처리
원시 데이터를 처리하는 것은 매우 중요합니다. 정리된 데이터가 기계에 공급되면 모델은 더 정확하게 반응하고 데이터를 더 효율적으로 학습하게 됩니다.
이 단계에서는 불용어 제거, 어간 추출, 불필요한 단어 제거 등이 포함됩니다. 진행하기 전에 데이터를 불러와 데이터프레임으로 변환하는 것이 중요합니다. 아래 코드를 참조하세요.
import json
json_file = 'intents.json'
with open('intents.json', 'r') as f:
    data = json.load(f)
설명 Code:
- 데이터가 JSON 형식이므로 json 파일을 가져옵니다.
- 해당 파일은 변수에 저장됩니다.
- 파일이 열리고 데이터 변수에 로드됩니다.
이제 데이터가 불러와졌으므로, 데이터를 데이터프레임으로 변환할 차례입니다. 다음 단계는 아래 코드를 참조하세요.
import pandas as pd
df = pd.DataFrame(data)
df['patterns'] = df['patterns'].apply(', '.join)
설명 Code:
1. 위에서 가져온 pandas를 사용하여 데이터를 데이터프레임으로 변환합니다.
2. `patterns` 열의 목록을 문자열로 변환합니다.
from nltk.corpus import stopwords
from textblob import Word
stop = stopwords.words('english')
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x.lower() for x in x.split()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in string.punctuation))
df['patterns'] = df['patterns'].str.replace('[^\w\s]', '')
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if not x.isdigit()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in stop))
df['patterns'] = df['patterns'].apply(lambda x: " ".join([Word(word).lemmatize() for word in x.split()]))
Code 설명 :
1. 영어 불용어는 nltk 툴킷의 불용어 모듈을 사용하여 가져옵니다.
2. for 조건문과 람다 함수를 사용하여 텍스트의 모든 단어를 소문자로 변환합니다. 람다 함수 익명 함수입니다.
3. 데이터 프레임의 텍스트 행 전체에 대해 문자열 구두점을 확인하고, 구두점이 있는 행은 필터링합니다.
4. 숫자나 점과 같은 문자는 정규 표현식을 사용하여 제거됩니다.
5. Digits가 텍스트에서 제거됩니다.
6. 이 단계에서는 불용어가 제거됩니다.
7. 이제 단어를 필터링하고, 어근 추출을 통해 같은 단어의 다른 형태를 제거합니다. 이로써 데이터 전처리가 완료되었습니다.
출력:
, patterns, responses, tag
0,hi one talk hello hi available,"['Hello, thanks for contacting us', 'Good to see you here', ' Hi there, how may I assist you?']",welcome
1,bye see later goodbye come back soon,"['See you later, thanks for visiting', 'have a great day ahead', 'Wish you Come back again soon.']",goodbye
2,thanks helping thank guidance thats helpful kind,"['Happy to help!', 'Any time!', 'My pleasure', 'It is my duty to help you']",thankful
3,hour open tell opening time open timing please,"[""We're open every day 8am-7pm"", 'Our office hours are 8am-7pm every day', 'We open office at 8 am and close at 7 pm']",hoursopening
4,pay using credit card pay using mastercard pay using cash,"['We accept VISA, Mastercard and credit card', 'We accept credit card, debit cards and cash. Please dont worry']",payments
3단계) Word2vec을 이용한 신경망 구축
이제 Gensim Word2vec 모듈을 사용하여 모델을 구축할 차례입니다. Gensim에서 Word2vec을 가져와야 합니다. 먼저 Word2vec을 가져온 다음 모델을 구축하고, 마지막 단계에서는 실시간 데이터를 사용하여 모델을 검증하겠습니다.
from gensim.models import Word2Vec
이제 Word2Vec을 사용하여 모델을 성공적으로 구축할 수 있습니다. Word2Vec을 사용하여 모델을 생성하는 방법은 다음 코드를 참조하십시오. 텍스트는 리스트 형태로 모델에 제공되므로 아래 코드를 사용하여 데이터 프레임의 텍스트를 리스트로 변환합니다.
Bigger_list = []
for i in df['patterns']:
     li = list(i.split(""))
     Bigger_list.append(li)
Model = Word2Vec(Bigger_list, min_count=1, size=300, workers=4)
설명 Code:
1. 내부 리스트가 추가된 더 큰 리스트를 생성했습니다. 이 형식이 Word2Vec 모델에 입력되는 형식입니다.
2. 반복문을 구현하여 데이터프레임의 patterns 열에 있는 각 항목을 순회합니다.
3. 열 패턴의 각 요소는 분할되어 내부 목록 li에 저장됩니다.
4. 내부 리스트에 외부 리스트가 추가됩니다.
5. 이 목록은 Word2Vec 모델에 제공됩니다. 여기에 제공된 몇 가지 매개변수를 살펴보겠습니다.
최소 개수: 이보다 총 빈도수가 낮은 모든 단어를 무시합니다.
크기 : 이는 단어 벡터의 차원을 알려줍니다.
노동자 : 이것들은 모델을 학습시키는 데 사용되는 스레드입니다.
이 외에도 다른 옵션들이 있으며, 그중 중요한 몇 가지는 아래에 설명되어 있습니다.
창 : 문장 내에서 현재 단어와 예측 단어 사이의 최대 거리입니다.
Sg: 이는 학습 알고리즘입니다. skip-gram은 1, Continuous Bag of Words는 0입니다. 이에 대해서는 위에서 자세히 설명했습니다.
Hs : 이 값이 1이면 계층적 소프트맥스를 사용하여 학습하고, 0이면 네거티브 샘플링을 사용합니다.
알파 : 초기 학습률.
아래에 최종 코드를 표시해 보겠습니다.
# list of libraries used by the code
import string
from gensim.models import Word2Vec
import logging
from nltk.corpus import stopwords
from textblob import Word
import json
import pandas as pd
# data in json format
json_file = 'intents.json'
with open('intents.json', 'r') as f:
    data = json.load(f)
# displaying the list of stopwords
stop = stopwords.words('english')
# dataframe
df = pd.DataFrame(data)

df['patterns'] = df['patterns'].apply(', '.join)
# cleaning the data using the NLP approach
print(df)
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x.lower() for x in x.split()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in string.punctuation))
df['patterns'] = df['patterns'].str.replace('[^\w\s]', '')
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if not x.isdigit()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in stop))
df['patterns'] = df['patterns'].apply(lambda x: " ".join([Word(word).lemmatize() for word in x.split()]))
# taking the outer list
bigger_list = []
for i in df['patterns']:
    li = list(i.split(" "))
    bigger_list.append(li)
# structure of data to be taken by the model.word2vec
print("Data format for the overall list:", bigger_list)
# custom data is fed to machine for further processing
model = Word2Vec(bigger_list, min_count=1, size=300, workers=4)
4단계) 모델 저장
모델은 바이너리 파일(bin) 형식과 일반 모델 파일 형식으로 저장할 수 있습니다. 바이너리 파일은 바이너리 파일 형식을 나타냅니다. 모델을 저장하는 방법은 아래 코드를 참조하십시오.
model.save("word2vec.model")
model.save("model.bin")
위 코드에 대한 설명
1. 모델은 .model 파일 형식으로 저장됩니다.
2. 모델은 .bin 파일 형식으로 저장됩니다.
우리는 이 모델을 사용하여 유사어, 비유사어, 가장 흔한 단어 등과 같은 실시간 테스트를 수행할 것입니다.
5단계) 모델 로딩 및 실시간 테스트 수행
아래 코드를 사용하여 모델을 로드합니다.
model = Word2Vec.load('model.bin')
만약 해당 어휘 목록을 출력하고 싶다면, 아래 명령어를 사용하면 됩니다.
vocab = list(model.wv.vocab)
결과를 확인하세요:
['see', 'thank', 'back', 'thanks', 'soon', 'open', 'mastercard', 'card', 'time', 'pay', 'talk', 'cash', 'one', 'please', 'goodbye', 'thats', 'helpful', 'hour', 'credit', 'hi', 'later', 'guidance', 'opening', 'timing', 'hello', 'helping', 'bye', 'tell', 'come', 'using', 'kind', 'available']
6단계) 가장 유사한 단어 확인
실제로 구현해 보겠습니다.
similar_words = model.most_similar('thanks')
print(similar_words)
결과를 확인하세요:
[('kind', 0.16104359924793243), ('using', 0.1352398842573166), ('come', 0.11500970274209976), ('later', 0.09989878535270691), ('helping', 0.04855936020612717), ('credit', 0.04659383371472359), ('pay', 0.0329081267118454), ('thank', 0.02484947443008423), ('hour', 0.0202352125197649), ('opening', 0.018177658319473267)]
7단계) 제공된 단어의 단어가 일치하지 않습니다.
dissimlar_words = model.doesnt_match('See you later, thanks for visiting'.split())
print(dissimlar_words)
우리는 단어를 제공했습니다 '나중에 봐요, 방문해주셔서 감사합니다.'이 코드는 주어진 단어들 중에서 가장 유사성이 낮은 단어를 출력합니다. 이제 이 코드를 실행하고 결과를 확인해 보겠습니다.
위 코드를 실행한 후의 결과는 다음과 같습니다.
Thanks
8 단계) 두 단어 사이의 유사성 찾기
이 부분은 두 단어 간의 유사성 확률을 결과로 보여줍니다. 아래 코드를 참조하여 이 부분을 실행해 보세요.
similarity_two_words = model.similarity('please', 'see')
print("Please provide the similarity between these two words:")
print(similarity_two_words)
위 코드의 결과는 다음과 같습니다.
0.13706
아래 코드를 실행하면 유사한 단어를 더 찾을 수 있습니다.
similar = model.similar_by_word('kind')
print(similar)
위 코드의 출력:
[('credit', 0.11764447391033173), ('cash', 0.11440904438495636), ('one', 0.11151769757270813), ('hour', 0.0944807156920433), ('using', 0.0705675333738327), ('thats', 0.05206916481256485), ('later', 0.04502468928694725), ('bye', 0.03960943967103958), ('back', 0.03837274760007858), ('thank', 0.0380823090672493)]
