
SJF(Shortest Job First): 선점형, 비선점형 예
 너다니엘 브룩스
⚡ 스마트 요약
최단 작업 우선(SJF)은 실행 시간이 가장 짧은 프로세스를 다음 실행 프로세스로 선택하는 CPU 스케줄링 알고리즘입니다. 선점형 또는 비선점형으로 구현될 수 있으며, 프로세스의 평균 대기 시간을 크게 줄여줍니다.
최단 작업 우선 스케줄링이란 무엇입니까?
최단 작업 우선(SJF) 실행 시간이 가장 짧은 프로세스를 선택하여 다음 실행을 수행하는 알고리즘이다. 이 스케줄링 방법은 선점형이거나 비선점형일 수 있습니다. 실행을 기다리는 다른 프로세스의 평균 대기 시간을 크게 줄입니다. SJF의 전체 형태는 Shortest Job First입니다.
SJF 방법에는 기본적으로 두 가지 유형이 있습니다.
- 비선점형 SJF
- 선제적 SJF
SJF 스케줄링의 특징
- 완료하는 데 걸리는 시간 단위로 각 작업과 연결됩니다.
- 이 알고리즘 방법은 작업이 완료될 때까지 기다리는 것이 중요하지 않은 배치 유형 처리에 유용합니다.
- 이는 작업 시간이 짧은 작업을 먼저 실행함으로써 처리량을 향상시키고, 결과적으로 처리 시간을 단축할 수 있습니다.
- 이는 작업 속도가 더 빠른, 즉 처리 시간이 더 짧은 작업을 우선적으로 처리하도록 함으로써 작업 생산성을 향상시킵니다.
비선점형 SJF
비선점형 스케줄링에서는 CPU 사이클이 프로세스에 할당되면 해당 프로세스는 대기 상태에 도달하거나 종료될 때까지 해당 사이클을 유지합니다.
각각 고유한 버스트 시간과 도착 시간을 가진 다음 다섯 가지 프로세스를 고려해 보십시오.
| 프로세스 대기열 | 버스트 시간 | 도착 시간 |
|---|---|---|
| P1 | 6 | 2 |
| P2 | 2 | 5 |
| P3 | 8 | 1 |
| P4 | 3 | 0 |
| P5 | 4 | 4 |
단계 0) 시간 = 0에 P4가 도착하여 실행을 시작합니다.

단계 1) 시간 t=1에 프로세스 P3이 도착합니다. 하지만 P4는 완료하는 데 2개의 실행 단위가 더 필요합니다. 따라서 P4는 계속 실행됩니다.

단계 2) 시간 = 2에 프로세스 P1가 도착하여 대기 대기열에 추가됩니다. P4은 실행을 계속합니다.

단계 3) 시간 = 3에서 프로세스 P4는 실행을 완료합니다. P3과 P1의 버스트 시간을 비교합니다. 프로세스 P1은 버스트 시간이 P3에 비해 짧기 때문에 실행됩니다.

단계 4) 시간 = 4에 프로세스 P5가 도착하여 대기 대기열에 추가됩니다. P1은 실행을 계속합니다.

단계 5) 시간 = 5에 프로세스 P2가 도착하여 대기 대기열에 추가됩니다. P1은 실행을 계속합니다.

단계 6) 시간 = 9에서 프로세스 P1은 실행을 완료합니다. P3, P5, P2의 버스트 시간을 비교합니다. 프로세스 P2는 버스트 시간이 가장 낮기 때문에 실행됩니다.

단계 7) 시간 = 10일 때, P2는 실행 중이고 P3와 P5는 대기열에 있습니다.

단계 8) 시간 = 11에서 프로세스 P2는 실행을 완료합니다. P3과 P5의 버스트 시간을 비교합니다. 버스트 시간이 더 짧기 때문에 프로세스 P5가 실행됩니다.

단계 9) 시간 = 15에서 프로세스 P5는 실행을 완료합니다.

단계 10) 시간 = 23에서 프로세스 P3는 실행을 완료합니다.
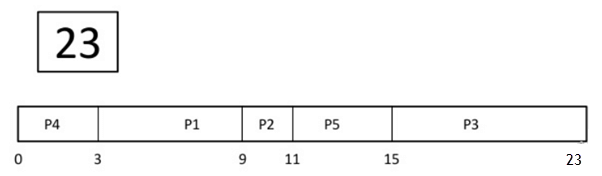
단계 11) 위 예시의 평균 대기 시간을 계산해 보겠습니다.
Wait time
P4 = 0 - 0 = 0
P1 = 3 - 2 = 1
P2 = 9 - 5 = 4
P5 = 11 - 4 = 7
P3 = 15 - 1 = 14
Average Waiting Time = (0 + 1 + 4 + 7 + 14)/5 = 26/5 = 5.2
선제적 SJF
선점형 SJF 스케줄링에서는 작업이 들어오는 대로 준비 큐에 추가됩니다. 버스트 시간이 가장 짧은 프로세스가 실행을 시작합니다. 만약 버스트 시간이 더 짧은 프로세스가 도착하면, 현재 프로세스는 실행에서 제거되거나 선점되고, 버스트 시간이 더 짧은 작업에 CPU 사이클이 할당됩니다.
다음 다섯 가지 과정을 고려해 보세요.
| 프로세스 대기열 | 버스트 시간 | 도착 시간 |
|---|---|---|
| P1 | 6 | 2 |
| P2 | 2 | 5 |
| P3 | 8 | 1 |
| P4 | 3 | 0 |
| P5 | 4 | 4 |
단계 0) 시간 = 0에 P4가 도착하여 실행을 시작합니다.
| 프로세스 대기열 | 버스트 시간 | 도착 시간 |
|---|---|---|
| P1 | 6 | 2 |
| P2 | 2 | 5 |
| P3 | 8 | 1 |
| P4 | 3 | 0 |
| P5 | 4 | 4 |
단계 1) 시간 = 1에 프로세스 P3이 도착합니다. 하지만 P4는 버스트 시간이 더 짧으므로 계속 실행됩니다.

단계 2) 시간 = 2에서 프로세스 P1은 버스트 시간 = 6으로 도착합니다. 버스트 시간은 P4의 시간보다 깁니다. 따라서 P4는 계속해서 실행됩니다.

단계 3) 시간 = 3에서 프로세스 P4는 실행을 완료합니다. P3과 P1의 버스트 시간을 비교합니다. 버스트 시간이 더 짧기 때문에 프로세스 P1가 실행됩니다.

단계 4) 시간 = 4에 프로세스 P5가 도착합니다. P3, P5, P1의 버스트 시간을 비교합니다. 프로세스 P5는 버스트 시간이 가장 낮기 때문에 실행됩니다. 프로세스 P1이 선점되었습니다.
| 프로세스 대기열 | 버스트 시간 | 도착 시간 |
|---|---|---|
| P1 | 5개 중 6개 남았습니다. | 2 |
| P2 | 2 | 5 |
| P3 | 8 | 1 |
| P4 | 3 | 0 |
| P5 | 4 | 4 |

단계 5) 시간 t=5에 프로세스 P2가 도착합니다. P1, P2, P3, P5의 버스트 시간을 비교합니다. 버스트 시간이 가장 짧은 프로세스 P2가 실행됩니다. 프로세스 P5는 선점됩니다.
| 프로세스 대기열 | 버스트 시간 | 도착 시간 |
|---|---|---|
| P1 | 5개 중 6개 남았습니다. | 2 |
| P2 | 2 | 5 |
| P3 | 8 | 1 |
| P4 | 3 | 0 |
| P5 | 3개 중 4개 남았습니다. | 4 |

단계 6) 시간 = 6일 때, P2가 실행 중입니다.

단계 7) 시간 t=7에 P2 프로세스의 실행이 완료됩니다. P1, P3, P5 프로세스의 버스트 시간을 비교합니다. 버스트 시간이 가장 짧은 P5 프로세스가 실행됩니다.
| 프로세스 대기열 | 버스트 시간 | 도착 시간 |
|---|---|---|
| P1 | 5개 중 6개 남았습니다. | 2 |
| P2 | 2 | 5 |
| P3 | 8 | 1 |
| P4 | 3 | 0 |
| P5 | 3개 중 4개 남았습니다. | 4 |

단계 8) 시간 t=10에 P5 프로세스가 실행을 완료합니다. P1과 P3 프로세스의 버스트 시간을 비교합니다. 버스트 시간이 더 짧은 P1 프로세스가 실행됩니다.

단계 9) 시간 15에서 P1의 실행이 완료됩니다. 이제 P3만 남았으며, P3가 실행을 시작합니다.

단계 10) 시간 = 23에 P3의 실행이 완료됩니다.

단계 11) 위 예시의 평균 대기 시간을 계산해 보겠습니다.
Wait time
P4 = 0 - 0 = 0
P1 = (3 - 2) + 6 = 7
P2 = 5 - 5 = 0
P5 = 4 - 4 + 2 = 2
P3 = 15 - 1 = 14
Average Waiting Time = (0 + 7 + 0 + 2 + 14)/5 = 23/5 = 4.6
SJF의 장점
SJF 방법을 사용했을 때의 이점은 다음과 같습니다.
- SJF는 장기 스케줄링에 자주 사용됩니다.
- 이는 FIFO(선입선출) 알고리즘에 비해 평균 대기 시간을 줄여줍니다.
- SJF 방법은 특정 프로세스 집합에 대해 가장 낮은 평균 대기 시간을 제공합니다.
- 실행 시간이 미리 알려진 배치로 실행되는 작업에 적합합니다.
- 장기 스케줄링 배치 시스템의 경우 작업 설명에서 버스트 시간 추정을 얻을 수 있습니다.
- 단기 스케줄링의 경우 다음 버스트 시간의 값을 예측해야 합니다.
- 평균 처리 시간 측면에서 보면 아마도 최적일 것입니다.
SJF의 단점/단점
다음은 SJF 알고리즘의 몇 가지 단점입니다.
- 작업 완료 시간을 더 일찍 알아야 하지만 예측하기는 어렵습니다.
- 장기 스케줄링을 위해 배치 시스템에서 자주 사용됩니다.
- SJF는 구현할 수 없습니다. CPU 스케줄링 단기적으로는. 다가오는 CPU 버스트의 길이를 예측할 수 있는 구체적인 방법이 없기 때문입니다.
- 이 알고리즘은 처리 시간이 매우 길어지거나 기아 상태가 발생할 수 있습니다.
- 프로세스나 작업이 실행되는 기간에 대한 지식이 필요합니다.
- 이는 평균 처리 시간을 줄이지 못하는 기아 상태로 이어집니다.
- 다가오는 CPU 요청의 길이를 아는 것은 어렵습니다.
- 경과 시간을 기록해야 하므로 프로세서에 추가적인 부담이 발생합니다.
