
R에서의 GLM: 일반화 선형 모델 및 로지스틱 회귀
 편집 팀
⚡ 스마트 요약
R의 일반화 선형 모델(GLM)은 일반 회귀 분석을 확장하여 이진형, 카운트 기반 또는 비정규 분포를 따르는 결과 변수를 처리할 수 있게 해줍니다. 이 가이드에서는 성인 소득 데이터셋을 사용하여 로지스틱 GLM을 구축하고 정확도, 정밀도, 재현율 및 ROC 곡선을 통해 성능을 평가합니다.
R에서 일반화 선형 모델(GLM)이란 무엇인가요?
A 일반화 선형 모델(GLM) 일반적인 선형 회귀 분석을 확장하여 반응 변수가 정규 분포 이외의 분포를 따를 수 있도록 합니다. R내장형으로 된 제품을 하나 장착하면 됩니다. 글름() stats 패키지의 함수입니다.
모든 GLM은 세 가지 구성 요소로 정의됩니다.
- 랜덤 요소: 반응 변수의 확률 분포는 지수족 분포(이항 분포, 포아송 분포, 감마 분포, 가우시안 분포 등)에서 추출됩니다.
- 체계적인 구성 요소: 선형 예측 변수, 즉 설명 변수들의 가중 조합입니다.
- 링크 기능: 응답의 평균과 선형 예측 변수를 연결하는 함수로, 예를 들어 이진 데이터의 경우 로짓 링크, 카운트 데이터의 경우 로그 링크가 사용됩니다.
그러한 구조가 바로 모델을 "일반화"하는 요소입니다. 정규 분포 결과를 강제하는 대신, 올바른 분포를 선언하는 방식입니다. 가족 인수와 R은 최대우도법을 사용하여 계수를 추정합니다. 로지스틱 회귀는 이항 분포족과 로짓 연결 함수를 사용하는 일반화 선형 모델(GLM)이므로 자연스러운 출발점입니다.
R에서 로지스틱 회귀란 무엇인가요?
로지스틱 회귀는 클래스, 즉 확률을 예측하는 데 사용됩니다. 로지스틱 회귀는 이진 결과를 정확하게 예측할 수 있습니다.
다양한 속성을 기반으로 대출 거부/수락 여부를 예측한다고 가정해 보세요. 로지스틱 회귀는 0/1 형식입니다. 대출이 거부되면 y = 0, 승인되면 y = 1입니다.
로지스틱 회귀 모델은 선형 회귀 모델과 두 가지 측면에서 다릅니다.
- 우선, 로지스틱 회귀 분석에서는 이분형(이진) 입력만 종속 변수(즉, 0과 1의 벡터)로 허용합니다.
- 둘째로, 결과는 확률적 연결 함수라고 불리는 것을 통해 매핑됩니다. 시그 모이 드 (로지스틱) 함수는 S자형 곡선을 나타내기 때문입니다.

함수의 출력은 항상 0과 1 사이입니다. 아래 이미지를 확인하세요.
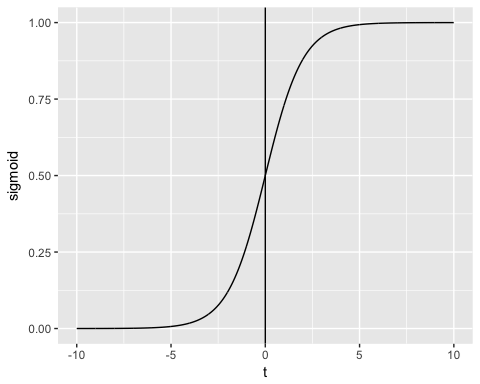
시그모이드 함수는 0에서 1까지의 값을 반환합니다. 분류 작업에는 0 또는 1의 이산 출력이 필요합니다.
연속 흐름을 이산 값으로 변환하기 위해 결정 한계를 0.5로 설정할 수 있습니다. 이 임계값을 초과하는 모든 값은 1로 분류됩니다.

이제 연결 함수가 명확해졌으니, 일반화된 모델과 여러분이 이미 알고 있는 일반 선형 모델을 비교해 보세요.
GLM과 선형 회귀 분석: R에서의 주요 차이점
코드를 작성하기 전에 표준이 언제 적용되는지 정확히 아는 것이 도움이 됩니다. 선형 회귀 lm() 함수는 더 이상 적절하지 않으며 glm() 함수로 대체해야 합니다.
| 기준 | 선형 회귀(lm) | 일반화 선형 모델(glm) |
|---|---|---|
| 응답 변수 | 연속적이고 무한함 | 이진, 개수, 비율 또는 양의 연속형 |
| 오류 분포 | 일반 전용 | 지수족의 구성원 |
| 링크 기능 | 정체성(암묵적) | 명시적 용어: 로짓, 로그, 역함수, 프로빗 |
| 추정 방법 | 일반 최소 제곱 | 최대우도법(IRLS) |
| 분산 가정 | 관찰 전반에 걸쳐 일정함 | 평균에 의존하는 것이 허용됨 |
| 적합도 측정 | R-제곱 | AIC 및 잔차 편차 |
| R 함수 | lm(수식, 데이터) | glm(수식, 데이터, 패밀리) |
요약하자면, 결과값이 정규분포를 따르는 측정값일 때는 lm() 함수를 선택하고, 결과값이 예/아니오와 같은 결정일 때는 glm() 함수를 선택하세요. 후자의 경우는 다른 사람에게 맡길 수도 있습니다. 의사 결정 트리 분류기, 이벤트 발생 횟수 또는 평균에 따라 분산이 증가하는 엄밀히 양수인 양수.
R에서 일반화 선형 모델(GLM)을 만드는 방법
이론이 정리되었으니, 이 튜토리얼의 나머지 부분에서는 실제 데이터 세트에 이항 GLM을 처음부터 끝까지 적용해 보겠습니다.
사용합시다 성인 로지스틱 회귀 분석을 설명하기 위한 데이터 세트입니다. "성인" 데이터 세트는 분류 작업에 매우 적합합니다. 목표는 개인의 연간 소득(미국 달러 기준)이 5만 달러를 초과할지 여부를 예측하는 것입니다. 이 데이터 세트는 48,842개의 관측치와 10개의 변수로 구성되어 있습니다.
- 나이: 개인의 나이. 숫자
- 교육: 개인의 교육 수준. 요인.
- 결혼 상태: Mari개인의 전체적인 상태. 요인, 즉 미혼, 기혼-시민-배우자, …
- 성별: 개인의 성별입니다. 요인, 즉 남성 또는 여성
- 소득: Target 변하기 쉬운. 소득이 50 초과 또는 미만입니다. 인수(예: >50K, <=50K)
다른 사람들 사이에서
library(dplyr)
data_adult <-read.csv("https://raw.githubusercontent.com/guru99-edu/R-Programming/master/adult.csv")
glimpse(data_adult)
출력:
Observations: 48,842
Variables: 10
$ x               <int> 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15,...
$ age             <int> 25, 38, 28, 44, 18, 34, 29, 63, 24, 55, 65, 36, 26...
$ workclass       <fctr> Private, Private, Local-gov, Private, ?, Private,...
$ education       <fctr> 11th, HS-grad, Assoc-acdm, Some-college, Some-col...
$ educational.num <int> 7, 9, 12, 10, 10, 6, 9, 15, 10, 4, 9, 13, 9, 9, 9,...
$ marital.status  <fctr> Never-married, Married-civ-spouse, Married-civ-sp...
$ race            <fctr> Black, White, White, Black, White, White, Black, ...
$ gender          <fctr> Male, Male, Male, Male, Female, Male, Male, Male,...
$ hours.per.week  <int> 40, 50, 40, 40, 30, 30, 40, 32, 40, 10, 40, 40, 39...
$ income          <fctr> <=50K, <=50K, >50K, >50K, <=50K, <=50K, <=50K, >5...
우리는 다음과 같이 진행합니다:
- 1단계: 연속형 변수 확인
- 2단계: 요인변수 확인
- 3단계: 특성 추출
- 4단계: 요약 통계
- 5단계: 훈련/테스트 세트
- 6단계: 모델 구축
- 7단계: 모델 성능 평가
- 8단계: 모델 개선
당신의 임무는 어떤 개인이 50보다 높은 수익을 얻을 것인지 예측하는 것입니다.
이 튜토리얼에서는 실제 데이터세트에 대한 분석을 수행하기 위한 각 단계를 자세히 설명합니다.
1단계) 연속변수 확인
첫 번째 단계에서는 연속형 변수의 분포를 볼 수 있습니다.
continuous <-select_if(data_adult, is.numeric)
summary(continuous)
Code 설명
- 연속 <- select_if(data_adult, is.numeric): dplyr 라이브러리의 select_if() 함수를 사용하여 숫자 열만 선택합니다.
- summary(continuous): 요약 통계를 출력합니다.
출력:
##        X              age        educational.num hours.per.week
##  Min.   :    1   Min.   :17.00   Min.   : 1.00   Min.   : 1.00
##  1st Qu.:11509   1st Qu.:28.00   1st Qu.: 9.00   1st Qu.:40.00
##  Median :23017   Median :37.00   Median :10.00   Median :40.00
##  Mean   :23017   Mean   :38.56   Mean   :10.13   Mean   :40.95
##  3rd Qu.:34525   3rd Qu.:47.00   3rd Qu.:13.00   3rd Qu.:45.00
##  Max.   :46033   Max.   :90.00   Max.   :16.00   Max.   :99.00
위 표에서 볼 수 있듯이 데이터의 규모는 완전히 다르고 hours.per.weeks에는 큰 이상치가 있습니다(즉, 마지막 사분위수와 최대값을 살펴보세요).
다음 두 단계에 따라 문제를 해결할 수 있습니다.
- 주당 근무시간 분포를 그래프로 나타내시오
- 연속형 변수 표준화
- 분포를 그려라
주당 시간 분포를 자세히 살펴보겠습니다.
# Histogram with kernel density curve
library(ggplot2)
ggplot(continuous, aes(x = hours.per.week)) +
    geom_density(alpha = .2, fill = "#FF6666")
출력:

변수에는 이상치가 많고 분포도 잘 정의되지 않았습니다. 주당 시간 상위 0.01%를 삭제하여 이 문제를 부분적으로 해결할 수 있습니다.
분위수의 기본 구문:
quantile(variable, percentile)
arguments:
-variable:  Select the variable in the data frame to compute the percentile
-percentile:  Can be a single value between 0 and 1 or multiple value. If multiple, use this format:  `c(A,B,C, ...)
- `A`,`B`,`C` and `...` are all integer from 0 to 1.
우리는 주당 근무 시간의 99번째 백분위수를 계산합니다.
top_one_percent <- quantile(data_adult$hours.per.week, .99)
top_one_percent
Code 설명
- quantile(data_adult$hours.per.week, .99): 주당 근무 시간의 99번째 백분위수를 계산합니다.
출력:
## 99%
##  80
인구의 99%가 주당 80시간 이하로 일합니다.
이 임계값 이상으로 관측치를 삭제할 수 있습니다. 당신은 필터를 사용합니다 dplyr 도서관.
data_adult_drop <-data_adult %>%
filter(hours.per.week<top_one_percent)
dim(data_adult_drop)
출력:
## [1] 45537 10
- 연속형 변수 표준화
데이터의 척도가 동일하지 않기 때문에 각 열을 표준화하여 성능을 향상시킬 수 있습니다. dplyr 라이브러리의 mutate_if 함수를 사용할 수 있습니다. 기본 구문은 다음과 같습니다.
mutate_if(df, condition, funs(function))
arguments:
-`df`: Data frame used to compute the function
- `condition`: Statement used. Do not use parenthesis
- funs(function):  Return the function to apply. Do not use parenthesis for the function
다음과 같이 숫자 열을 표준화할 수 있습니다.
data_adult_rescale <- data_adult_drop %>%
	mutate_if(is.numeric, funs(as.numeric(scale(.))))
head(data_adult_rescale)
Code 설명
- mutate_if(is.numeric, funs(scale)): 조건은 숫자 열만이고 함수는 scale입니다.
출력:
##           X         age        workclass    education educational.num
## 1 -1.732680 -1.02325949          Private         11th     -1.22106443
## 2 -1.732605 -0.03969284          Private      HS-grad     -0.43998868
## 3 -1.732530 -0.79628257        Local-gov   Assoc-acdm      0.73162494
## 4 -1.732455  0.41426100          Private Some-college     -0.04945081
## 5 -1.732379 -0.34232873          Private         10th     -1.61160231
## 6 -1.732304  1.85178149 Self-emp-not-inc  Prof-school      1.90323857
##       marital.status  race gender hours.per.week income
## 1      Never-married Black   Male    -0.03995944  <=50K
## 2 Married-civ-spouse White   Male     0.86863037  <=50K
## 3 Married-civ-spouse White   Male    -0.03995944   >50K
## 4 Married-civ-spouse Black   Male    -0.03995944   >50K
## 5      Never-married White   Male    -0.94854924  <=50K
## 6 Married-civ-spouse White   Male    -0.76683128   >50K
2단계) 요인변수 확인
이 단계에는 두 가지 목표가 있습니다.
- 각 범주형 열의 수준을 확인하세요.
- 새로운 레벨 정의
이 단계를 세 부분으로 나누겠습니다.
- 범주형 열을 선택하세요.
- 각 열의 막대 차트를 목록에 저장
- 그래프 인쇄
아래 코드를 사용하여 요인 열을 선택할 수 있습니다.
# Select categorical column
factor <- data.frame(select_if(data_adult_rescale, is.factor))
	ncol(factor)
Code 설명
- data.frame(select_if(data_adult, is.factor)): 팩터 열을 데이터 프레임 유형으로 저장합니다. ggplot2 라이브러리에는 데이터 프레임 개체가 필요합니다.
출력:
## [1] 6
데이터 세트에는 6개의 범주형 변수가 포함되어 있습니다.
두 번째 단계는 좀 더 까다롭습니다. 데이터프레임 factor의 각 열에 대해 막대 그래프를 그려야 합니다. 특히 열이 많은 경우 이 과정을 자동화하는 것이 더 편리합니다.
library(ggplot2)
# Create graph for each column
graph <- lapply(names(factor),
    function(x)
	ggplot(factor, aes(get(x))) +
		geom_bar() +
		theme(axis.text.x = element_text(angle = 90)))
Code 설명
- lapply(): lapply() 함수를 사용하여 데이터세트의 모든 열에 함수를 전달합니다. 출력을 목록에 저장합니다.
- function(x): 함수는 각 x에 대해 처리됩니다. 여기서 x는 열입니다.
- ggplot(factor, aes(get(x))) + geom_bar()+ theme(axis.text.x = element_text(angle = 90)): 각 x 요소에 대한 막대형 차트를 만듭니다. x를 열로 반환하려면 get() 안에 x를 포함해야 합니다.
마지막 단계는 비교적 쉽습니다. 6개의 그래프를 인쇄하고 싶습니다.
# Print the graph
graph
출력:
## [[1]]

## ## [[2]]

## ## [[3]]

## ## [[4]]

## ## [[5]]

## ## [[6]]

참고: 다음 그래프로 이동하려면 다음 버튼을 사용하세요.

3단계) 특성 추출
두 개의 범주형 변수가 모델에 필요한 것보다 더 많은 레벨을 가지고 있습니다. 이 변수들을 더 광범위하고 더 많은 변수를 포함하는 범주로 재그룹화해야 합니다.
리캐스트 교육
위의 그래프를 보면 변수 교육은 16단계로 구성되어 있음을 알 수 있습니다. 이는 상당한 수준이며 일부 수준에서는 관찰 수가 상대적으로 적습니다. 이 변수에서 얻을 수 있는 정보의 양을 늘리려면 더 높은 수준으로 다시 캐스팅할 수 있습니다. 즉, 비슷한 수준의 교육을 받은 더 큰 그룹을 만듭니다. 예를 들어, 낮은 교육 수준은 중퇴로 전환됩니다. 더 높은 수준의 교육이 석사로 변경됩니다.
세부 사항은 다음과 같습니다.
| 이전 수준 | 새로운 수준 |
|---|---|
| 프리스쿨 | 탈락 |
| 10 위 | 탈락 |
| 11 위 | 탈락 |
| 12 위 | 탈락 |
| 1 일 ~ 4 일 | 탈락 |
| 5th-6th | 탈락 |
| 7th-8th | 탈락 |
| 9 위 | 탈락 |
| 고등학생 | 하이그라드 |
| 일부 대학 | 커뮤니티 |
| Assoc-acdm | 커뮤니티 |
| 협회-Voc | 커뮤니티 |
| 학사 | 학사 |
| 석사 | 석사 |
| 교수 | 석사 |
| 박사 | 박사 |
recast_data <- data_adult_rescale %>%
	select(-X) %>%
	mutate(education = factor(ifelse(education == "Preschool" | education == "10th" | education == "11th" | education == "12th" | education == "1st-4th" | education == "5th-6th" | education == "7th-8th" | education == "9th", "dropout", ifelse(education == "HS-grad", "HighGrad", ifelse(education == "Some-college" | education == "Assoc-acdm" | education == "Assoc-voc", "Community",
    ifelse(education == "Bachelors", "Bachelors",
        ifelse(education == "Masters" | education == "Prof-school", "Master", "PhD")))))))
Code 설명
- 우리는 dplyr 라이브러리에서 동사 mutate를 사용합니다. 우리는 ifelse문으로 교육의 가치를 바꿉니다.
아래 표에서는 학사, 석사 또는 박사 학위를 취득하는 데 평균적으로 몇 년의 교육 기간(z-값)이 걸리는지 확인하기 위한 요약 통계를 만듭니다.
recast_data %>%
	group_by(education) %>%
	summarize(average_educ_year = mean(educational.num),
		count = n()) %>%
	arrange(average_educ_year)
출력:
## # A tibble: 6 x 3
## education average_educ_year count
##      <fctr>             <dbl> <int>
## 1   dropout       -1.76147258  5712
## 2  HighGrad       -0.43998868 14803
## 3 Community        0.09561361 13407
## 4 Bachelors        1.12216282  7720
## 5    Master        1.60337381  3338
## 6       PhD        2.29377644   557
개주 Mari탈 상태
결혼 상태에 대해 더 낮은 수준을 만드는 것도 가능합니다. 다음 코드에서 다음과 같이 수준을 변경합니다.
| 이전 수준 | 새로운 수준 |
|---|---|
| 미혼 | 결혼하지 |
| 기혼-배우자-부재 | 결혼하지 |
| 기혼-AF-배우자 | 결혼한 |
| 기혼-시민-배우자 | |
| 분리 | 분리 |
| 이혼 | |
| 과부 | 과부 |
# Change level marry
recast_data <- recast_data %>%
	mutate(marital.status = factor(ifelse(marital.status == "Never-married" | marital.status == "Married-spouse-absent", "Not_married", ifelse(marital.status == "Married-AF-spouse" | marital.status == "Married-civ-spouse", "Married", ifelse(marital.status == "Separated" | marital.status == "Divorced", "Separated", "Widow")))))
각 그룹 내 개인 수를 확인할 수 있습니다.
table(recast_data$marital.status)
출력:
## ##     Married Not_married   Separated       Widow
##       21165       15359        7727        1286
4단계) 요약 통계
이제 목표 변수에 대한 통계를 확인할 차례입니다. 아래 그래프에서는 성별에 따라 50달러 이상을 버는 개인의 비율을 계산합니다.
# Plot gender income
ggplot(recast_data, aes(x = gender, fill = income)) +
    geom_bar(position = "fill") +
    theme_classic()
출력:

다음으로 개인의 출신이 소득에 영향을 미치는지 확인하십시오.
# Plot origin income
ggplot(recast_data, aes(x = race, fill = income)) +
    geom_bar(position = "fill") +
    theme_classic() +
    theme(axis.text.x = element_text(angle = 90))
출력:
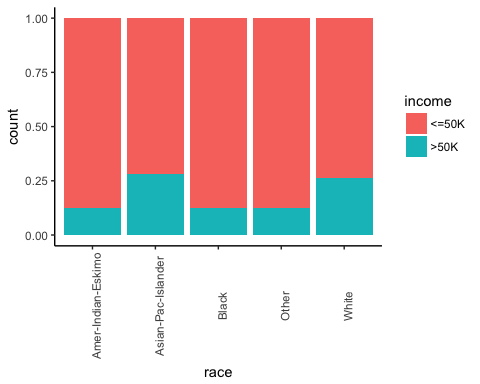
성별에 따른 근무시간.
# box plot gender working time
ggplot(recast_data, aes(x = gender, y = hours.per.week)) +
    geom_boxplot() +
    stat_summary(fun.y = mean,
        geom = "point",
        size = 3,
        color = "steelblue") +
    theme_classic()
출력:

상자 그림은 근무 시간 분포가 다양한 그룹에 적합하다는 것을 확인합니다. 상자 그림에서 두 성별 모두 동질적인 관찰 결과를 가지고 있지 않습니다.
교육 유형별 주당 근무 시간 밀도를 확인할 수 있습니다. 분포에는 다양한 선택지가 있습니다. 이는 아마도 교육 유형으로 설명될 수 있을 것입니다.trac미국에서.
# Plot distribution working time by education
ggplot(recast_data, aes(x = hours.per.week)) +
    geom_density(aes(color = education), alpha = 0.5) +
    theme_classic()
Code 설명
- ggplot(recast_data, aes(x= hours.per.week)): 밀도 플롯에는 변수가 하나만 필요합니다.
- geom_density(aes(color = education), alpha =0.5): 밀도를 제어하는 기하학적 객체
출력:

생각을 확인하려면 단방향으로 수행하면 됩니다. ANOVA 검정:
anova <- aov(hours.per.week~education, recast_data)
summary(anova)
출력:
##                Df Sum Sq Mean Sq F value Pr(>F)
## education       5   1552  310.31   321.2 <2e-16 ***
## Residuals   45531  43984    0.97
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
ANOVA 검정은 그룹 간 평균 차이를 확인합니다.
비선형 성
모델을 실행하기 전에 근무 시간이 연령과 연관이 있는지 확인할 수 있습니다.
library(ggplot2)
ggplot(recast_data, aes(x = age, y = hours.per.week)) +
    geom_point(aes(color = income),
        size = 0.5) +
    stat_smooth(method = 'lm',
        formula = y~poly(x, 2),
        se = TRUE,
        aes(color = income)) +
    theme_classic()
Code 설명
- ggplot(recast_data, aes(x = age, y = hours.per.week)): 그래프의 미적 요소를 설정합니다.
- geom_point(aes(color=income), size =0.5): 도트 플롯을 구성합니다.
- stat_smooth(): 다음 인수를 사용하여 추세선을 추가합니다.
- method='lm': 다음과 같은 경우 적합치를 표시합니다. 선형 회귀
- 공식 = y~poly(x,2): 다항식 회귀 피팅
- se = TRUE: 표준 오류를 추가합니다.
- aes(color=income): 소득별로 모델을 분리합니다.
출력:

간단히 말해서 모델의 상호 작용 항을 테스트하여 주별 작업 시간과 기타 기능 간의 비선형 효과를 확인할 수 있습니다. 어떤 조건에서 작업 시간이 다른지 감지하는 것이 중요합니다.
상관관계
다음 확인은 변수 간의 상관관계를 시각화하는 것입니다. Spearman 방법으로 계산된 상관 계수가 포함된 열 지도를 그릴 수 있도록 요인 수준 유형을 숫자로 변환합니다.
library(GGally)
# Convert data to numeric
corr <- data.frame(lapply(recast_data, as.integer))
# Plot the graphggcorr(corr,
    method = c("pairwise", "spearman"),
    nbreaks = 6,
    hjust = 0.8,
    label = TRUE,
    label_size = 3,
    color = "grey50")
Code 설명
- data.frame(lapply(recast_data,as.integer)): 데이터를 숫자로 변환합니다.
- ggcorr()는 다음 인수를 사용하여 열 지도를 그립니다.
- method: 상관관계를 계산하는 방법
- nbreaks = 6: 중단 횟수
- hjust = 0.8: 플롯에서 변수 이름의 위치 제어
- label = TRUE: 창 중앙에 라벨 추가
- label_size = 3: 사이즈 라벨
- color = “grey50”): 라벨 색상
출력:
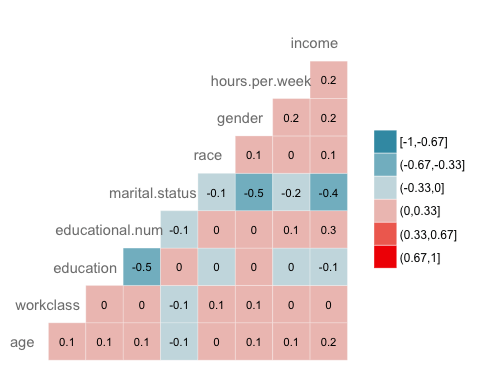
5단계) 학습/테스트 세트
모든 감독 기계 학습 이 과제에서는 데이터를 훈련 세트와 테스트 세트로 분할해야 합니다. 다른 지도 학습 튜토리얼에서 만든 "함수"를 사용하여 훈련/테스트 세트를 생성할 수 있습니다.
set.seed(1234)
create_train_test <- function(data, size = 0.8, train = TRUE) {
    n_row = nrow(data)
    total_row = size * n_row
    train_sample <- 1: total_row
    if (train == TRUE) {
        return (data[train_sample, ])
    } else {
        return (data[-train_sample, ])
    }
}
data_train <- create_train_test(recast_data, 0.8, train = TRUE)
data_test <- create_train_test(recast_data, 0.8, train = FALSE)
dim(data_train)
출력:
## [1] 36429 9
dim(data_test)
출력:
## [1] 9108 9
6단계) 모델 구축
알고리즘의 성능을 확인하려면 stats 패키지의 glm() 함수를 사용합니다. 일반화 선형 모델 모델들의 모음입니다. 기본 구문은 다음과 같습니다.
glm(formula, data=data, family=linkfunction()
Argument:
- formula:  Equation used to fit the model- data: dataset used
- Family:     - binomial: (link = "logit")
- gaussian: (link = "identity")
- Gamma:    (link = "inverse")
- inverse.gaussian: (link = "1/mu^2")
- poisson:  (link = "log")
- quasi:    (link = "identity", variance = "constant")
- quasibinomial:    (link = "logit")
- quasipoisson: (link = "log")
일련의 특성 간에 소득 수준을 분할하기 위해 로지스틱 모델을 추정할 준비가 되었습니다.
formula <- income~.
logit <- glm(formula, data = data_train, family = 'binomial')
summary(logit)
Code 설명
- 수식 <- 소득 ~ .: 적합하도록 모델을 생성합니다.
- logit <- glm(formula, data = data_train, family = 'binomial'): data_train 데이터를 사용하여 로지스틱 모델(family = 'binomial')을 맞춥니다.
- summary(logit): 모델의 요약을 인쇄합니다.
출력:
##
## Call:
## glm(formula = formula, family = "binomial", data = data_train)
## ## Deviance Residuals:
##     Min       1Q   Median       3Q      Max
## -2.6456  -0.5858  -0.2609  -0.0651   3.1982
##
## Coefficients:
##                           Estimate Std. Error z value Pr(>|z|)
## (Intercept)                0.07882    0.21726   0.363  0.71675
## age                        0.41119    0.01857  22.146  < 2e-16 ***
## workclassLocal-gov        -0.64018    0.09396  -6.813 9.54e-12 ***
## workclassPrivate          -0.53542    0.07886  -6.789 1.13e-11 ***
## workclassSelf-emp-inc     -0.07733    0.10350  -0.747  0.45499
## workclassSelf-emp-not-inc -1.09052    0.09140 -11.931  < 2e-16 ***
## workclassState-gov        -0.80562    0.10617  -7.588 3.25e-14 ***
## workclassWithout-pay      -1.09765    0.86787  -1.265  0.20596
## educationCommunity        -0.44436    0.08267  -5.375 7.66e-08 ***
## educationHighGrad         -0.67613    0.11827  -5.717 1.08e-08 ***
## educationMaster            0.35651    0.06780   5.258 1.46e-07 ***
## educationPhD               0.46995    0.15772   2.980  0.00289 **
## educationdropout          -1.04974    0.21280  -4.933 8.10e-07 ***
## educational.num            0.56908    0.07063   8.057 7.84e-16 ***
## marital.statusNot_married -2.50346    0.05113 -48.966  < 2e-16 ***
## marital.statusSeparated   -2.16177    0.05425 -39.846  < 2e-16 ***
## marital.statusWidow       -2.22707    0.12522 -17.785  < 2e-16 ***
## raceAsian-Pac-Islander     0.08359    0.20344   0.411  0.68117
## raceBlack                  0.07188    0.19330   0.372  0.71001
## raceOther                  0.01370    0.27695   0.049  0.96054
## raceWhite                  0.34830    0.18441   1.889  0.05894 .
## genderMale                 0.08596    0.04289   2.004  0.04506 *
## hours.per.week             0.41942    0.01748  23.998  < 2e-16 ***
## ---## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
## ## (Dispersion parameter for binomial family taken to be 1)
## ##     Null deviance: 40601  on 36428  degrees of freedom
## Residual deviance: 27041  on 36406  degrees of freedom
## AIC: 27087
##
## Number of Fisher Scoring iterations: 6
우리 모델의 요약은 흥미로운 정보를 보여줍니다. 로지스틱 회귀의 성능은 특정 주요 지표를 사용하여 평가됩니다.
- AIC(Akaike 정보 기준): 이는 다음과 같습니다. R2 로지스틱 회귀에서. 매개변수 수에 페널티가 적용될 때 적합도를 측정합니다. 더 작게 AIC 값은 모델이 진실에 더 가깝다는 것을 나타냅니다.
- 영 이탈도(Null deviance): 절편만으로 모형을 적합시킵니다. 자유도는 n-1입니다. 카이제곱 값(실제 값 가설 검정과 다른 적합 값)으로 해석할 수 있습니다.
- 잔차 이탈도: 모든 변수를 사용하여 모형화합니다. 이는 카이제곱 가설 검정으로도 해석됩니다.
- Fisher Scoring 반복 횟수: 수렴 전 반복 횟수입니다.
glm() 함수의 출력은 목록에 저장됩니다. 아래 코드는 로지스틱 회귀를 평가하기 위해 구성한 로짓 변수에서 사용할 수 있는 모든 항목을 보여줍니다.
# 목록이 매우 길기 때문에 처음 세 요소만 인쇄합니다.
lapply(logit, class)[1:3]
출력:
## $coefficients
## [1] "numeric"
##
## $residuals
## [1] "numeric"
##
## $fitted.values
## [1] "numeric"
각 값은 다음과 같습니다.trac모델 이름 뒤에 $ 기호를 붙이고 그 뒤에 측정항목 이름을 붙입니다. 예를 들어, 모델을 logit으로 저장했다면, 다음과 같이 입력합니다.tracAIC 기준에서는 다음을 사용합니다.
logit$aic
출력:
## [1] 27086.65
7단계) 모델 성능 평가
혼란 매트릭스
The 혼란 매트릭스 이전에 본 다양한 측정항목과 비교하여 분류 성능을 평가하는 것이 더 나은 선택입니다. 일반적인 아이디어는 True 인스턴스가 False로 분류된 횟수를 계산하는 것입니다.

혼동 행렬을 계산하려면 먼저 실제 목표와 비교할 수 있도록 일련의 예측이 필요합니다.
predict <- predict(logit, data_test, type = 'response')
# confusion matrix
table_mat <- table(data_test$income, predict > 0.5)
table_mat
Code 설명
- 예측(logit,data_test, type = 'response'): 테스트 세트에 대한 예측을 계산합니다. 유형 = '응답'을 설정하여 응답 확률을 계산합니다.
- table(data_test$income, 예측 > 0.5): 혼동 행렬을 계산합니다. 예측 > 0.5는 예측 확률이 1보다 크면 0.5을 반환하고 그렇지 않으면 0을 반환한다는 의미입니다.
출력:
##
##         FALSE TRUE
##   <=50K  6310  495
##   >50K   1074 1229
혼동 행렬의 각 행은 실제 목표값을 나타내고, 각 열은 예측된 목표값을 나타냅니다. 이 행렬의 첫 번째 행은 소득이 50만 달러 미만인 경우(음성 클래스)를 고려합니다. 6,310개의 관측치가 소득이 50만 달러 미만인 개인으로 정확하게 분류되었습니다.진정한 부정), 반면 495건은 50k 이상으로 잘못 분류되었습니다.거짓 긍정두 번째 행은 소득이 50만 이상인 경우를 고려한 것으로, 1,229명이 정확하게 식별되었습니다.진정한 긍정), 반면 1,074건은 누락되었습니다.위음성).
모델을 계산할 수 있습니다. 전체 관찰에 대해 참양성 + 참음성을 합산하여

accuracy_Test <- sum(diag(table_mat)) / sum(table_mat)
accuracy_Test
Code 설명
- sum(diag(table_mat)): 대각선의 합
- sum(table_mat): 행렬의 합입니다.
출력:
## [1] 0.8277339
이 모델은 한 가지 문제점을 가지고 있는 것으로 보입니다. 바로 너무 많은 오탐(false negative)을 발생시킨다는 것입니다. 이를 오탐(false negative)이라고 합니다. 정확도 테스트 역설정확도는 전체 사례 수 대비 올바른 예측 수의 비율이라고 설명했습니다. 정확도가 비교적 높더라도 모델이 쓸모없을 수 있습니다. 이는 특정 클래스가 지배적일 때 발생합니다. 혼동 행렬을 살펴보면 대부분의 사례가 참음성으로 분류된 것을 알 수 있습니다. 이제 모델이 모든 관측치를 음성으로 분류했다고 가정해 보겠습니다(즉, 50만 개 미만). 그래도 정확도는 약 75%(6,805 / 9,108)가 될 것입니다. 모델의 성능은 향상되었지만, 참양성과 참음성을 구분하는 데 어려움을 겪는 것입니다.
이러한 상황에서는 보다 간결한 측정항목을 사용하는 것이 좋습니다. 우리는 다음을 볼 수 있습니다:
- 정밀도=TP/(TP+FP)
- 회상=TP/(TP+FN)
정밀도 대 재현율
정밀성 긍정적인 예측의 정확성을 살펴봅니다. 소환 분류기에 의해 올바르게 감지된 양성 인스턴스의 비율입니다.
두 가지 측정항목을 계산하기 위해 두 가지 함수를 구성할 수 있습니다.
- 구성 정밀도
precision <- function(matrix) {
	# True positive
    tp <- matrix[2, 2]
	# false positive
    fp <- matrix[1, 2]
    return (tp / (tp + fp))
}
Code 설명
- mat[1,1]: 데이터 프레임의 첫 번째 열의 첫 번째 셀을 반환합니다. 즉, 참양성입니다.
- 매트[1,2]; 데이터 프레임의 두 번째 열의 첫 번째 셀을 반환합니다. 즉, 거짓 긍정입니다.
recall <- function(matrix) {
# true positive
    tp <- matrix[2, 2]# false positive
    fn <- matrix[2, 1]
    return (tp / (tp + fn))
}
Code 설명
- mat[1,1]: 데이터 프레임의 첫 번째 열의 첫 번째 셀을 반환합니다. 즉, 참양성입니다.
- 매트[2,1]; 데이터 프레임의 첫 번째 열의 두 번째 셀, 즉 거짓 부정을 반환합니다.
기능을 테스트할 수 있습니다.
prec <- precision(table_mat)
prec
rec <- recall(table_mat)
rec
출력:
## [1] 0.712877
## [2] 0.5336518
이 두 수치를 주의 깊게 읽어보세요. 정밀도는 0.71이므로, 모델이 개인의 소득이 50만 달러 이상이라고 판단할 때 71%의 정확도를 보입니다. 재현율은 0.53이므로, 모델은 실제로 50만 달러 이상을 버는 사람 중 53%만 정확하게 감지합니다.
당신은 만들 수 있습니다  정밀도와 재현율을 기준으로 점수를 매깁니다. 그만큼 는 이 두 측정항목의 조화 평균입니다. 즉, 낮은 값에 더 많은 가중치를 부여한다는 의미입니다.

f1 <- 2 * ((prec * rec) / (prec + rec))
f1
출력:
## [1] 0.6103799
정밀도와 재현율의 절충
높은 정밀도와 높은 재현율을 모두 갖는 것은 불가능합니다.
정밀도를 높이면 올바른 개인을 더 잘 예측할 수 있지만 많은 개인을 놓칠 수 있습니다(낮은 재현율). 어떤 상황에서는 재현율보다 높은 정밀도를 선호합니다. 정밀도와 재현율 사이에는 오목한 관계가 있습니다.
- 환자에게 질병이 있는지 예측해야 한다고 상상해 보십시오. 당신은 가능한 한 정확하고 싶습니다.
- 얼굴인식을 통해 거리에서 잠재적인 사기꾼을 탐지해야 한다면, 정확도가 낮더라도 사기꾼으로 낙인찍힌 사람을 많이 잡아내는 것이 더 나을 것입니다. 경찰은 사기 행위를 하지 않은 사람을 석방할 수 있습니다.
ROC 곡선
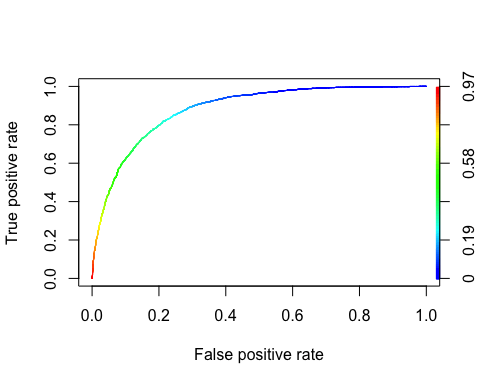
The 리시버 Opera팅 특징 곡선은 이진 분류에 사용되는 또 다른 일반적인 도구입니다. 정밀도/재현율 곡선과 매우 유사하지만 정밀도 대 재현율을 표시하는 대신 ROC 곡선은 위양성률에 대한 참양성률(즉, 재현율)을 표시합니다. 위양성률은 양성으로 잘못 분류된 음성 인스턴스의 비율입니다. XNUMX에서 진음성률을 뺀 것과 같습니다. 진음성률이라고도 합니다. 특성. 따라서 ROC 곡선은 다음과 같습니다. 감광도 (리콜) 대 1-특이성
ROC 곡선을 그리려면 ROCR이라는 패키지를 설치해야 합니다. 이 패키지는 conda에서 찾을 수 있습니다. 도서관. 다음 코드를 입력할 수 있습니다.
conda install -c r r-rocr --yes
예측() 및 성능() 함수를 사용하여 ROC를 그릴 수 있습니다.
library(ROCR)
ROCRpred <- prediction(predict, data_test$income)
ROCRperf <- performance(ROCRpred, 'tpr', 'fpr')
plot(ROCRperf, colorize = TRUE, text.adj = c(-0.2, 1.7))
Code 설명
- 예측(예측, data_test$income): ROCR 라이브러리는 입력 데이터를 변환하기 위해 예측 개체를 생성해야 합니다.
- Performance(ROCRpred, 'tpr','fpr'): 그래프에 생성할 두 조합을 반환합니다. 여기서는 tpr과 fpr이 구성됩니다. 정밀도와 재현율을 함께 표시하려면 "prec", "rec"를 사용하세요.
출력:
8단계) 모델 개선
다음과 같은 상호 작용을 통해 모델에 비선형성을 추가할 수 있습니다.
- 연령 및 주당 시간
- 성별과 주당 근무시간.
그다음 두 모델의 F1 점수를 비교합니다.
formula_2 <- income~age: hours.per.week + gender: hours.per.week + .
logit_2 <- glm(formula_2, data = data_train, family = 'binomial')
predict_2 <- predict(logit_2, data_test, type = 'response')
table_mat_2 <- table(data_test$income, predict_2 > 0.5)
precision_2 <- precision(table_mat_2)
recall_2 <- recall(table_mat_2)
f1_2 <- 2 * ((precision_2 * recall_2) / (precision_2 + recall_2))
f1_2
출력:
## [1] 0.6109181
F1 점수가 이전보다 약간 높습니다. 데이터를 계속 분석하여 점수를 개선해 보세요.
R에서 GLM 계수와 오즈비를 해석하는 방법
6단계에서 출력되는 요약표는 계수를 보고합니다. 로그 확률 이는 비전문가에게 설명하기 어려운 규모입니다. 이를 확률비로 변환하면 모델을 훨씬 쉽게 전달할 수 있습니다.
다음 네 단계를 따르십시오.
- 계수를 지수화합니다. 모든 추정치에 exp() 함수를 적용하여 로그 오즈가 곱셈 오즈비가 되도록 합니다.
- 신뢰구간을 추가하세요. confint() 함수를 exp() 함수로 감싸면 동일한 확률 척도에서 95% 신뢰구간을 얻을 수 있습니다.
- 각 값을 1과 비교하십시오. 오즈비가 1보다 크면 양성 클래스의 확률이 증가하고, 1보다 작으면 감소하며, 1에 가까우면 예측 변수가 거의 영향을 미치지 않음을 의미합니다.
- 통계적 유의성을 확인하십시오. 요약 출력에서 p값이 선택한 임계값(일반적으로 0.05)보다 낮은 예측 변수만 해석하십시오.
# Convert log-odds coefficients into odds ratios
odds_ratio <- exp(coef(logit))
round(odds_ratio, 3)

# Odds ratios with 95% confidence intervals
exp(cbind(OddsRatio = coef(logit), confint(logit)))
출력 결과를 읽고 있습니다. 우리 모델에서 주당 근무시간의 계수는 0.41942입니다. 이를 지수화하면 exp(0.41942) = 1.52가 되는데, 이는 다른 모든 변수를 일정하게 유지할 때 주당 근무시간이 표준편차만큼 증가하면 50만 달러 이상을 벌 확률이 대략 1.5배 증가한다는 것을 의미합니다.
음의 계수도 같은 방식으로 작동합니다. marital.statusNot_married는 -2.50346이므로 exp(-2.50346) = 0.08입니다. 즉, 미혼인 사람은 기혼인 사람의 약 8% 확률을 가집니다. 1단계에서 연속형 예측 변수가 표준화되었으므로 원시 시간 단위가 아닌 표준 편차 단위로 변화를 설명해야 합니다.
다른 가족분들께 드리는 참고 사항: 지수화된 계수는 로짓 링크를 사용하는 이항 분포족에서만 오즈비로 해석됩니다. 분포족이 "포아송"이고 로그 링크를 사용하는 경우, 동일한 exp() 값은 비율비로 해석됩니다.
R에서의 GLM: 빠른 함수 참조
코딩하는 동안 이 표를 옆에 두고 보세요. 이 표에는 위 8단계에서 사용된 모든 함수와 해당 함수를 제공하는 패키지, 그리고 함수가 필요로 하는 인수가 나열되어 있습니다.
| 묶음 | 목표 | 함수 | 논의 |
|---|---|---|---|
| - | 학습/테스트 데이터 세트 만들기 | create_train_set() | 데이터, 크기, 열차 |
| glm | 일반화 선형 모델 훈련 | 글름() | 수식, 데이터, 계열* |
| glm | 모델을 요약하다 | 요약() | 장착 모델 |
| 기지 | 예측하기 | 예측 () | 적합 모델, 데이터 세트, 유형 = '응답' |
| 기지 | 혼동 행렬 만들기 | 테이블() | y, 예측() |
| 기지 | 정확도 점수 생성 | 합계(diag(테이블())/sum(테이블() | |
| ROCR | ROC 생성: 1단계 예측 생성 | 예측() | 예측(), y |
| ROCR | ROC 생성 : 2단계 성과 생성 | 성능() | 예측(), 'tpr', 'fpr' |
| ROCR | ROC 생성: 3단계 그래프 플롯 | 구성() | 성능() |
다른 GLM 가족 논리를 통해 사용 가능한 가족은 다음과 같습니다.
- 이항분포: (링크 = “로짓”)
- 가우스: (링크 = “항등”)
- 감마: (링크 = "역")
- 역가우스: (링크 = “1/mu^2”)
- 포아송: (링크 = "로그")
- 유사: (링크 = "동일성", 분산 = "상수")
- 준이항식: (링크 = “로짓”)
- 준수아송: (링크 = "로그")
