
R에서 CSV 및 Excel 파일로 데이터를 내보내는 방법
 에블린 클라크
⚡ 스마트 요약
R에서 데이터를 내보내는 방법에는 데이터프레임을 CSV, Excel, SPSS, SAS, STATA 및 R 고유 형식으로 작성하는 방법과 동일한 파일을 다른 플랫폼으로 전송하는 방법이 포함됩니다. Google Drive or Dropbox모든 내보내기는 함수, 데이터 프레임 및 대상 경로라는 하나의 패턴을 따릅니다.
R에서 데이터를 내보내는 방법
이 튜토리얼에서는 R 환경에서 다른 형식으로 데이터를 내보내는 방법을 알아봅니다.
데이터를 하드 드라이브로 내보내려면 파일 경로와 확장자가 필요합니다. 우선, 경로는 데이터가 저장될 위치입니다. 이 튜토리얼에서는 다음에 데이터를 저장하는 방법을 알아봅니다.
- 하드 드라이브
- Google Drive
- Dropbox
둘째, R은 데이터를 다양한 형식으로 저장할 수 있습니다. 이 튜토리얼에서는 필수적인 파일 확장자에 대해 다룹니다.
- csv 파일
- XLSX
- RDS
- SAS
- SPSS
- 스태타
모든 내보내기는 동일한 형식을 따릅니다. 즉, 하나의 함수 호출, 데이터 프레임 및 대상 경로로 구성됩니다.
하드 드라이브로 내보내기
우선, 데이터를 작업 디렉토리에 직접 저장할 수 있습니다. 다음 코드는 작업 디렉토리의 경로를 인쇄합니다.
directory <- getwd()
directory
출력:
## [1] "/Users/15_Export_to_do"
전체 경로를 지정하지 않으면 모든 파일은 현재 작업 디렉터리에 저장됩니다. 기본 디렉터리는 시스템마다 다르며, 일반적으로 사용자의 홈 폴더입니다. macOS 그리고 Linux와 Documents 폴더 Windows하지만 getwd() 함수는 항상 현재 값을 알려줍니다. setwd() 함수를 사용하여 값을 변경하거나, 쓰기 함수에 전체 경로를 전달하면 됩니다.
setwd("/Users/USERNAME/Downloads")
데이터 프레임 생성
먼저, mtcars 데이터셋에서 기어별로 그룹화된 mpg와 disp의 평균값을 사용하여 간단한 데이터프레임을 생성합니다.
library(dplyr)
df <-mtcars %>%
    select(mpg, disp, gear) %>%
    group_by(gear) %>%
    summarize(mean_mpg = mean(mpg), mean_disp = mean(disp))
df
출력:
## # A tibble: 3 x 3
##	gear mean_mpg mean_disp
##	<dbl>	<dbl>	<dbl>
## 1	3 16.10667  326.3000
## 2 	4 24.53333  123.0167
## 3	5 21.38000  202.4800
테이블에는 XNUMX개의 행과 XNUMX개의 열이 있습니다. R에서 write.csv 함수를 사용하여 CSV 파일을 만들 수 있습니다.
R에서 DataFrame을 CSV 파일로 내보내는 방법
R에서 DataFrame을 CSV로 내보내기 위한 R의 write.csv 기본 구문은 다음과 같습니다.
write.csv(df, path)
arguments
-df: Dataset to save. Need to be the same name of the data frame in the environment.
-path: A string. Set the destination path. Path + filename + extension i.e. "/Users/USERNAME/Downloads/mydata.csv" or the filename + extension if the folder is the same as the working directory
예:
write.csv(df, "table_car.csv")
Code 설명
- write.csv(df, “table_car.csv”): 하드 드라이브에 CSV 파일을 생성합니다.
- df: 환경의 데이터 프레임 이름
- "table_car.csv": 파일 이름을 table_car로 지정하고 csv로 저장합니다.
주의 사항`write.csv2()` 함수는 필드 구분 기호로 세미콜론을, 소수점 구분 기호로 쉼표를 사용하여 동일한 파일을 작성합니다. 이는 유럽 대륙의 많은 지역에서 사용하는 관례입니다.
write.csv2(df, "table_car.csv")
주의 사항교육적인 목적으로, 디렉토리 폴더를 열어주는 `open_folder()`라는 함수를 만들었습니다. 아래 코드를 실행하고 CSV 파일이 저장된 위치를 확인해 보세요. `table_car.csv`라는 파일이 보일 것입니다.
# Run this code to create the function
open_folder <-function(dir){
	if (.Platform['OS.type'] == "windows"){
	shell.exec(dir)
	} else {
	system(paste(Sys.getenv("R_BROWSER"), dir))
  }
}
# Call the function to open the folder
open_folder(directory)
R에서 데이터프레임을 엑셀 파일로 내보내는 방법
엑셀로 내보내기는 간단합니다. Windows 그리고 약간 더 까다롭습니다. macOS둘 다 xlsx 라이브러리를 사용하며, 차이점은 설치 방식에만 있습니다. xlsx는 xlsx에 의존하기 때문입니다. Java. Java 패키지를 로드하려면 해당 파일이 기기에 있어야 합니다.
Windows 사용자
On Windowsconda를 사용하여 라이브러리를 직접 설치하세요.
conda install -c r r-xlsx
라이브러리가 설치되면 write.xlsx() 함수는 작업 디렉터리에 새 Excel 통합 문서를 생성합니다.
library(xlsx)
write.xlsx(df, "table_car.xlsx")
Mac OS 사용자라면 다음 단계를 따라야 합니다.
- 1단계: 최신 버전 설치 Java
- 2단계: r 라이브러리 설치Java
- 3단계: xlsx 라이브러리 설치
단계 1) 다운로드할 수 있습니다 Java 공식에서 Oracle 사이트를 찾아 설치합니다.
Rstudio로 돌아가서 어떤 버전인지 확인할 수 있습니다. Java 설치되어 있습니다.
system("java -version")
최근 Java 릴리스가 제대로 작동합니다. 명령 실행 결과가 아무것도 표시되지 않으면, Java 해당 패키지가 설치되어 있지 않으면 xlsx 패키지를 로드할 수 없습니다.
단계 2) R에 rjava를 설치해야 합니다. Anaconda와 함께 R과 Rstudio를 설치하는 것이 좋습니다. Anaconda는 라이브러리 간의 종속성을 관리합니다. 이런 의미에서 Anaconda는 r의 복잡한 부분을 처리합니다.Java 설치.
먼저 conda를 업데이트한 후 다음을 설치해야 합니다. 도서관. 터미널에 다음 두 줄의 코드를 복사하여 붙여 넣을 수 있습니다.
conda update conda
conda install -c r r-rjava
다음으로 Rstudio에서 rjava를 엽니다.
library(rJava)
단계 3) 드디어 xlsx를 설치할 차례입니다. 다시 한번, 당신은 사용할 수 있습니다 콘도 그것을 하기 위해:
conda install -c r r-xlsx
Windows 사용자와 마찬가지로 write.xlsx() 함수를 사용하여 데이터를 저장할 수 있습니다.
library(xlsx)
출력:
## Loading required package: xlsxjars
write.xlsx(df, "table_car.xlsx")
R에서 다른 소프트웨어로 데이터 내보내기
다양한 소프트웨어로 데이터를 내보내는 것은 데이터를 가져오는 것만큼 간단합니다. 라이브러리 "haven"은 데이터를 내보내는 편리한 방법을 제공합니다.
- spss
- SAS
- 스타 타
우선 라이브러리를 임포트합니다. "haven"이 없다면 다음으로 이동하세요. 여기에서 확인하세요 그것을 설치하십시오.
library(haven)
SPSS 파일
다음은 데이터를 SPSS 소프트웨어로 내보내는 코드입니다.
write_sav(df, "table_car.sav")
SAS 파일
spss처럼 간단하게 sas로 내보낼 수 있습니다.
write_sas(df, "table_car.sas7bdat")
STATA 파일
마지막으로, haven 라이브러리는 .dta 파일을 쓸 수 있도록 허용합니다.
write_dta(df, "table_car.dta")
R 기본 형식으로 데이터를 내보내는 방법
객체를 다른 프로그램으로 전달하지 않고 R 내부에 유지하려면 두 가지 기본 형식 중 하나를 사용하십시오. save() 함수는 하나 이상의 명명된 객체를 .RData 파일에 저장합니다.
save(df, file ='table_car.RData')
대안으로는 saveRDS() 함수가 있는데, 이 함수는 정확히 하나의 객체를 저장하고 읽는 사람이 돌아올 때 객체의 이름을 선택할 수 있도록 합니다.
# One object, name chosen at read time
saveRDS(df, file = "table_car.rds")
my_data <- readRDS("table_car.rds")

# Several objects, original names restored
save(df, directory, file = "workspace.RData")
load("workspace.RData")
| 기준 | saveRDS() / readRDS() | 저장() / 불러오기() |
|---|---|---|
| 파일당 객체 수 | 정확히 하나 | 하나 또는 여러 개 |
| 새로 고침 시 객체 이름 | 당신이 선택하세요 | 저장된 상태로 복원됨 |
| 환경을 덮어씁니다 | 아니 | 네, 조용히 |
| 평소 확장 | .rds | .RData |
스크립트에서는 saveRDS() 함수를 사용하는 것이 좋습니다. load() 함수는 동일한 이름의 기존 객체를 자동으로 덮어쓸 수 있기 때문입니다. 두 형식 모두 CSV 형식과 달리 요인 수준, 순서 및 속성을 그대로 유지합니다.
현재 작업 디렉터리에서 위에서 생성된 파일을 확인할 수 있습니다.

클라우드 서비스와 상호 작용
마지막으로, R 클라우드 컴퓨팅 서비스와 상호 작용할 수 있는 환상적인 라이브러리를 갖추고 있습니다. 이 튜토리얼의 마지막 부분에서는 다음에서 파일 내보내기/가져오기를 다룹니다.
- Google Drive
- Dropbox
주의 사항이 튜토리얼 부분은 사용자가 계정을 가지고 있다고 가정합니다. Google Dropbox. 그렇지 않은 경우 다음을 위해 빠르게 만들 수 있습니다. Google Drive: https://accounts.google.com/SignUp?hl=en - Dropbox: https://www.dropbox.com/h
Google Drive
이 기능에 접근하려면 라이브러리 GoogleDrive를 설치해야 합니다. Google Drive.
Anaconda에서는 아직 라이브러리를 사용할 수 없습니다. 콘솔에서 아래 코드를 사용하여 설치할 수 있습니다.
install.packages("googledrive")
그리고 도서관을 열어요.
library(googledrive)
conda를 사용하지 않는 경우, 라이브러리 설치는 간단합니다. 괄호 안에 따옴표로 묶은 패키지 이름을 사용하여 install.packages('패키지 이름')을 입력하면 됩니다. R은 .libPaths()가 반환하는 첫 번째 위치에 해당 패키지를 설치합니다.
에 업로드 Google Drive
파일을 업로드하려면 Google 드라이브를 사용하려면 drive_upload() 함수를 사용해야 합니다.
Rstudio를 다시 시작할 때마다 tidyverse에 대한 액세스를 허용하라는 메시지가 표시됩니다. Google Drive.
Drive_upload()의 기본 구문은 다음과 같습니다.
drive_upload(file, path = NULL, name = NULL)
arguments:
- file: Full name of the file to upload (i.e., including the extension)
- path: Location of the file- name: You can rename it as you wish. By default, it is the local name.
코드를 실행한 후 몇 가지 질문을 확인해야 합니다.
drive_upload("table_car.csv", name = "table_car")
출력:
## Local file:
## * table_car.csv
## uploaded into Drive file:
## * table_car: 1hwb57eT-9qSgDHt9CrVt5Ht7RHogQaMk
## with MIME type:
## * text/csv
액세스를 확인하려면 콘솔에 1을 입력합니다.
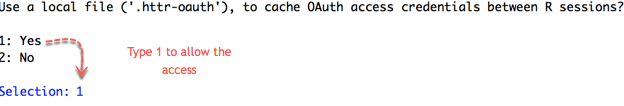
그러면 다음 페이지로 이동합니다. Google API 접근을 허용하려면 '허용'을 클릭하세요.

인증이 완료되면 브라우저를 종료하실 수 있습니다.

Rstudio 콘솔에서 완료된 단계의 요약을 볼 수 있습니다. Google 드라이브에 있는 로컬 파일을 성공적으로 업로드했습니다. Google 드라이브에 있는 각 파일에 ID를 할당했습니다.

이 파일은 다음에서 볼 수 있습니다. Google Spreadsheet.
drive_browse("table_car")
출력:
로 리디렉션됩니다 Google Spreadsheet

다음에서 가져오기 Google Drive
파일 ID로 다운로드하는 것이 가장 확실한 방법입니다. 파일 이름을 알고 있다면 먼저 파일 ID를 확인하세요.
주의 사항: 인터넷 연결 상태와 드라이브 크기에 따라 시간이 걸릴 수 있습니다.
x <-drive_get("table_car")
as_id(x)

변수 x에 ID를 저장했습니다. Drive_download() 함수를 사용하면 다음에서 파일을 다운로드할 수 있습니다. Google Drive.
기본 구문은 다음과 같습니다.
drive_download(file, path = NULL, overwrite = FALSE)
arguments:
- file:  Name or id of the file to download
-path: Location to download the file. By default, it is downloaded to the working directory and the name as in Google Drive
-overwrite = FALSE: If the file already exists, don't overwrite it. If set to TRUE, the old file is erased and replaced by the new one.
마침내 파일을 다운로드할 수 있습니다.
download_google <- drive_download(as_id(x), overwrite = TRUE)
Code 설명
- Drive_download(): 파일을 다운로드하는 함수 Google Drive
- as_id(x): 해당 ID를 사용하여 파일을 찾아봅니다. Google Drive
- overwrite = TRUE: 파일이 있으면 덮어쓰고 그렇지 않으면 실행이 중지됩니다. 로컬에서 파일 이름을 보려면 다음을 사용할 수 있습니다.
출력:

해당 파일은 작업 디렉토리에 저장됩니다. R에서 파일을 열기 전에 파일 확장자를 추가하는 것을 잊지 마세요. paste() 함수를 사용하여 전체 파일 이름을 생성할 수 있습니다(예: table_car.csv).
google_file <-download_google$local_path
google_file
path <-paste(google_file, ".csv", sep = "")
google_table_car <-read.csv(path)
google_table_car
출력:
##   X gear mean_mpg mean_disp
## 1 1    3 16.10667  326.3000
## 2 2    4 24.53333  123.0167
## 3 3    5 21.38000  202.4800
마지막으로, 해당 파일을 삭제할 수 있습니다. Google 구동한다.
## remove file
drive_find("table_car") %>%drive_rm()
출력:

삭제는 비동기적으로 처리됩니다. Google따라서 파일이 사라지는 데 잠시 시간이 걸릴 수 있습니다.
다음 위치로 내보내기 : Dropbox
R은 다음과 상호작용합니다. Dropbox rdrop2 라이브러리를 통해. Anaconda에서도 도서관을 이용할 수 없습니다. 콘솔을 통해 설치할 수 있습니다
install.packages('rdrop2')
library(rdrop2)
귀하는 임시 접근 권한을 부여합니다. Dropbox 사용자 자격 증명을 사용하여 인증하십시오. 인증이 완료되면 R은 사용자 디렉터리에 파일을 생성, 삭제, 업로드 및 다운로드할 수 있습니다. Dropbox.
먼저, 귀하의 계정에 대한 액세스 권한을 부여해야 합니다. 자격 증명은 모든 세션 중에 캐시됩니다.
drop_auth()
로 리디렉션됩니다 Dropbox 인증을 확인합니다.

확인 페이지가 나타납니다. 닫고 R로 돌아갈 수 있습니다

drop_create() 함수를 사용하여 폴더를 만들 수 있습니다.
- drop_create('my_first_drop'): 첫 번째 분기에 폴더를 만듭니다. Dropbox
- drop_create('First_branch/my_first_drop'): 기존 First_branch 폴더 내에 폴더를 만듭니다.
drop_create('my_first_drop')
출력:

드롭에서Box

.csv 파일을 Dropbox, drop_upload() 함수를 사용하세요.
기본 구문:
drop_upload(file, path = NULL, mode = "overwrite")
arguments:
- file: local path
- path: Path on Dropbox
- mode = "overwrite":  By default, overwrite an existing file. If set to `add`, the upload is not completed.
drop_upload('table_car.csv', path = "my_first_drop")
출력:

드롭에서Box

csv 파일은 다음에서 읽을 수 있습니다. Dropbox drop_read_csv() 함수를 사용하여
dropbox_table_car <-drop_read_csv("my_first_drop/table_car.csv")
dropbox_table_car
출력:
##   X gear mean_mpg mean_disp
## 1 1    3 16.10667  326.3000
## 2 2    4 24.53333  123.0167
## 3 3    5 21.38000  202.4800
파일 사용을 마치고 삭제하고 싶을 때. drop_delete() 함수에 파일 경로를 작성해야 합니다.
drop_delete('my_first_drop/table_car.csv')
출력:

폴더 삭제도 가능해요
drop_delete('my_first_drop')
출력:

R에서 데이터 내보내기: 함수 참조
이 튜토리얼에서 사용된 모든 내보내기 함수는 아래에 나열되어 있습니다.
| 도서관 | 목표 | 함수 |
|---|---|---|
| 기지 | CSV 내보내기 | 쓰기.csv() |
| XLSX | 엑셀 내보내기 | 쓰기.xlsx() |
| 항구 | spss 내보내기 | write_sav() |
| 항구 | SAS 내보내기 | write_sas() |
| 항구 | 수출 상태 | write_dta() |
| 기지 | R 객체 내보내기 | save() / saveRDS() |
| googledrive | 가이드라가 Google Drive | 드라이브_업로드() |
| googledrive | 에서 열기 Google Drive | 드라이브_찾아보기() |
| googledrive | 파일 ID 검색 | 드라이브_get(as_id()) |
| googledrive | 에서 다운로드 Google Drive | 드라이브 다운로드() |
| googledrive | 다음에서 파일 제거 Google Drive | 드라이브_RM() |
| rdrop2 | 인증 | drop_auth() |
| rdrop2 | 폴더 만들기 | 드롭_생성() |
| rdrop2 | 에 업로드 Dropbox | 드롭_업로드() |
| rdrop2 | 다음에서 CSV 읽기 Dropbox | drop_read_csv() |
| rdrop2 | 다음에서 파일 삭제 Dropbox | drop_delete() |
