
R의 dplyr 사용법 튜토리얼: 예제를 통해 데이터 병합 및 결합
 에블린 클라크
⚡ 스마트 요약
dplyr 패키지는 left_join(), right_join(), inner_join(), full_join()의 네 가지 함수를 사용하여 R에서 데이터 프레임을 병합하고 결합합니다. 함께 제공되는 tidyr 패키지는 gather(), spread(), separate(), unite() 함수를 사용하여 결합된 결과를 재구성합니다.
데이터 분석 소개
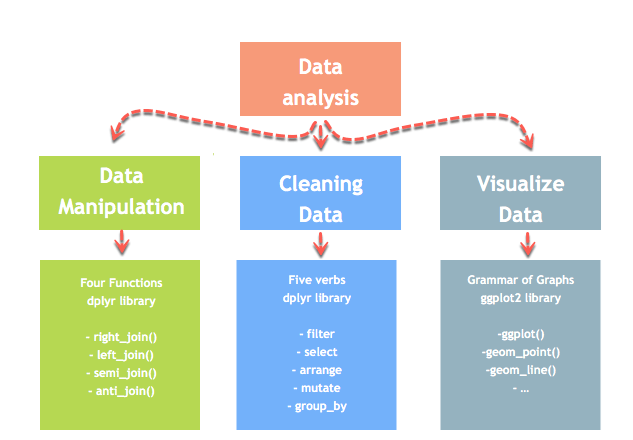
어떤 참여나 재공유 전에ping 동사의 의미가 통하고, 데이터 조작이 어디에 해당하는지 이해하는 데 도움이 됩니다. 데이터 분석 세 부분으로 나눌 수 있습니다.
- Extrac기: 첫째, 다양한 소스로부터 데이터를 수집하고 결합해야 합니다.
- 에이전트 기반 AI로 R&D 혁신: 이 단계에는 데이터 조작이 포함됩니다. 모든 데이터 소스를 통합한 후에는 데이터 정리를 시작할 수 있습니다.
- 눈에 보이게하다: 마지막 움직임은 데이터를 시각화하여 불규칙성을 확인하는 것입니다.
아래 그림은 세 단계가 어떻게 연결되는지 보여줍니다.
데이터 과학자들이 직면하는 가장 중요한 과제 중 하나는 데이터 조작입니다. 데이터는 항상 원하는 형식으로 제공되는 경우가 드뭅니다. 데이터 과학자들은 업무 시간의 최소 절반을 데이터 정제 및 조작에 할애해야 합니다. 이는 데이터 과학자의 업무에서 가장 중요한 부분 중 하나입니다. 데이터 조작 과정이 완벽하고 정확하며 엄격하게 이루어지지 않으면 모델이 제대로 작동하지 않습니다.
R dplyr
R에는 데이터 변환을 처리하는 dplyr이라는 패키지가 있습니다. 이 패키지는 filter(), select(), arrange(), mutate(), summarise()와 같은 몇 가지 핵심 함수와 여러 개의 join 함수를 중심으로 구성되어 있습니다. 데이터가 원하는 형태로 변환되면 ggplot2를 사용하여 시각화할 수 있습니다.
우리는 dplyr 패키지를 사용하여 조작하는 방법을 배우게 될 것입니다. 데이터 프레임R이 아직 설치되어 있지 않다면 다음 단계를 따르세요. R 및 RStudio 설정 단계그런 다음 install.packages(“dplyr”)를 실행합니다.
dplyr을 사용하여 데이터 병합
dplyr은 데이터 세트를 결합하는 훌륭하고 편리한 방법을 제공합니다. 입력 데이터의 소스가 많을 수 있으며 어느 시점에서는 이를 결합해야 합니다. dplyr을 사용한 조인은 원본 데이터 세트의 오른쪽에 변수를 추가합니다.
dplyr가 참여합니다
다음은 dplyr에서 두 데이터셋을 병합하는 데 사용되는 네 가지 중요한 조인 유형입니다. 네 가지 유형 모두 동일한 인수(두 테이블과 키)를 사용하며, 일치하지 않는 행 중 어떤 행이 남을지만 다릅니다.
| 함수 | 목표 | 인수 | 여러 키 |
|---|---|---|---|
| 왼쪽_결합() | 두 개의 데이터 세트를 병합합니다. 원본 테이블의 모든 관측값을 유지합니다. | x, y, by = “ID” | x, y, by = c(“ID”, “ID2”) |
| 오른쪽_결합() | 두 개의 데이터 세트를 병합합니다. 대상 테이블의 모든 관측치를 유지합니다. | x, y, by = “ID” | x, y, by = c(“ID”, “ID2”) |
| 내부_조인() | 두 데이터셋을 병합합니다. 일치하지 않는 행은 모두 제외합니다. | x, y, by = “ID” | x, y, by = c(“ID”, “ID2”) |
| 전체_결합() | 두 데이터셋을 병합합니다. 모든 관측치를 유지합니다. | x, y, by = “ID” | x, y, by = c(“ID”, “ID2”) |
이 네 가지 동사는 각각 LEFT, RIGHT, INNER 및 FULL OUTER 조인에 해당합니다. SQL기본 R은 all, all.x 및 all.y 인수를 통해 동일한 결과를 얻습니다. 병합().
간단한 예제를 통해 모든 조인 유형을 살펴보겠습니다.
우선 두 개의 데이터셋을 구축합니다. 표 1에는 ID와 y라는 두 변수가 포함되어 있고, 표 2에는 ID와 z가 포함되어 있습니다. 각 상황에서 우리는 다음을 가져야 합니다. 키 쌍 변하기 쉬운. 우리의 경우에는 ID가 우리의 것입니다. 키 이 함수는 두 테이블에서 동일한 값을 찾아 반환 값을 테이블 1의 오른쪽에 바인딩합니다. 아래 그림은 두 테이블을 나란히 보여줍니다.

library(dplyr)
df_primary <- tribble(
  ~ID, ~y,
   "A", 5,
   "B", 5,
   "C", 8,
   "D", 0,
  "F", 9)
df_secondary <- tribble(
  ~ID, ~z,
   "A", 30,
   "B", 21,
   "C", 22,
   "D", 25,
   "E", 29)
dplyr left_join()
두 데이터셋을 병합하는 가장 일반적인 방법은 `left_join()` 함수를 사용하는 것입니다. 아래 그림은 키 쌍이 A, B, C, D 행과 일치하고 E와 F 행은 제외된 것을 보여줍니다. `left_join()` 함수를 사용하면 원본 테이블의 모든 행은 유지하고 대상 테이블에 키 쌍이 없는 행은 무시합니다. 예시에서 E 값은 테이블 1에 존재하지 않으므로 해당 행은 삭제됩니다. F 값은 원본 테이블에서 가져온 것이므로 `left_join()` 후에도 유지되며, `z` 열에는 `NA`가 반환됩니다.
dplyr left_join()의 예
아래 다이어그램은 left_join() 호출 중에 발생하는 상황을 보여줍니다.

left_join(df_primary, df_secondary, by ='ID')
출력:
##
# A tibble: 5 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     F     9    NA
두 테이블에 동일한 이름의 열이 있는 경우 dplyr은 위에 표시된 .x 및 .y 접미사를 사용하여 두 테이블을 구분합니다.
dplyr right_join()
right_join() 함수는 left_join()과 정확히 동일하게 작동합니다. 유일한 차이점은 행이 삭제되었다는 것입니다. 대상 데이터 프레임에서 사용 가능한 E 값은 새 테이블에 존재하며 y 열에 NA 값을 사용합니다.
dplyr right_join()의 예
아래 그림은 거울상입니다.

right_join(df_primary, df_secondary, by = 'ID')
출력:
##
# A tibble: 5 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     E    NA    29
dplyr inner_join()
일치하지 않는 관측값이 전혀 쓸모가 없을 경우, 우리는 반환할 수 있습니다. 만 존재하는 행 두 데이터셋입니다. 이는 완전한 데이터셋이 필요하고 결측값을 평균이나 중앙값으로 대체하고 싶지 않을 때 적합한 선택입니다.
여기서 inner_join() 함수가 도움이 됩니다. 이 함수는 양쪽에서 일치하지 않는 행을 제외합니다.
dplyr inner_join()의 예
아래 다이어그램은 조인 과정에서 남는 네 가지 ID를 보여줍니다.

inner_join(df_primary, df_secondary, by ='ID')
출력:
##
# A tibble: 4 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
dplyr full_join()
마지막으로 full_join() 함수는 모든 관측값을 유지하고 결측값을 NA로 대체합니다.
dplyr full_join()의 예
아래 다이어그램은 조인 후에도 두 테이블의 모든 ID가 유지됨을 보여줍니다.

full_join(df_primary, df_secondary, by = 'ID')
출력:
## # A tibble: 6 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     F     9    NA
## 6     E    NA    29
다중 키 쌍
마지막으로, 데이터 세트에는 여러 개의 키가 있을 수 있습니다. 다음은 고객이 구매한 제품 목록과 연도 정보가 포함된 데이터 세트입니다. 아래 스크린샷은 두 개의 테이블과 행을 식별하는 데 사용되는 ID 및 연도 열을 보여줍니다.
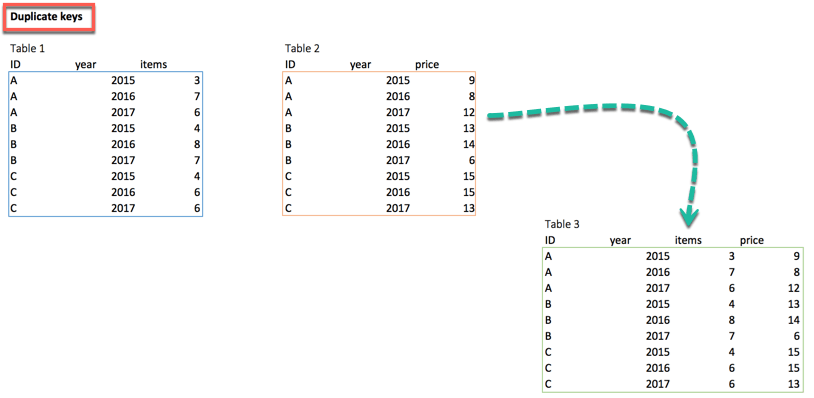
ID만을 기준으로 두 테이블을 조인하면 모든 연도가 서로 매칭되어 행 수가 폭발적으로 증가합니다. 이 문제를 해결하기 위해 두 데이터 세트에 모두 존재하는 ID와 연도라는 두 개의 키-값 쌍 변수를 사용할 수 있습니다. 다음 코드를 사용하여 테이블 1과 테이블 2를 병합할 수 있습니다.
df_primary <- tribble(
  ~ID, ~year, ~items,
  "A", 2015,3,
  "A", 2016,7,
  "A", 2017,6,
  "B", 2015,4,
  "B", 2016,8,
  "B", 2017,7,
  "C", 2015,4,
  "C", 2016,6,
  "C", 2017,6)
df_secondary <- tribble(
  ~ID, ~year, ~prices,
  "A", 2015,9,
  "A", 2016,8,
  "A", 2017,12,
  "B", 2015,13,
  "B", 2016,14,
  "B", 2017,6,
  "C", 2015,15,
  "C", 2016,15,
  "C", 2017,13)
left_join(df_primary, df_secondary, by = c('ID', 'year'))
출력:
## # A tibble: 9 x 4
##      ID  year items prices
##   <chr> <dbl> <dbl>  <dbl>
## 1     A  2015     3      9
## 2     A  2016     7      8
## 3     A  2017     6     12
## 4     B  2015     4     13
## 5     B  2016     8     14
## 6     B  2017     7      6
## 7     C  2015     4     15
## 8     C  2016     6     15
## 9     C  2017     6     13
dplyr 1.1.0 버전(2023년 1월)부터 동일한 키를 join_by(ID, year)와 같이 작성할 수 있게 되었으며, dplyr은 이제 예상치 못한 다대다 관계 일치에 대해 경고를 표시합니다. dplyr 1.1.0 버전 출시 발표 설명합니다.
R의 데이터 정리 기능
병합만으로는 문제의 절반만 해결됩니다. 병합된 테이블의 구조를 다시 정리해야 하기 때문입니다. 다음은 데이터를 정리하는 데 중요한 네 가지 기능입니다.
| 함수 | 목표 | 인수 |
|---|---|---|
| 모으다() | 데이터를 넓은 것에서 긴 것으로 변환 | (데이터, 키, 값, na.rm = FALSE) |
| 확산() | 데이터를 긴 데이터에서 넓은 데이터로 변환 | (데이터, 키, 값) |
| 분리된() | 하나의 변수를 두 개로 분할합니다. | (데이터, 열, 입력, 구분 = "", 제거 = TRUE) |
| 맞잡다() | 두 변수를 하나로 합치다 | (데이터, 열, 농도, 구분 = "", 제거 = TRUE) |
버전 참고: gather()와 spread() 함수는 tidyr 1.0.0에서 pivot_longer()와 pivot_wider() 함수로, separate() 함수는 tidyr 1.3.0에서 separate_wider_delim() 계열 함수로 대체되었습니다. 대체된 함수들도 여전히 실행 가능하므로 아래의 모든 예제는 정상적으로 작동하지만, 새로운 코드를 작성할 때는 최신 함수 계열을 사용하는 것이 좋습니다. 정리된 회전 비네트unite() 함수는 여전히 유효합니다.
데이터 조작, 정리 및 시각화를 위해 tidyverse 컬렉션의 일부인 tidyr 패키지를 사용합니다. Anaconda를 통해 R이 설치된 경우 해당 패키지는 이미 사용 가능합니다. https://anaconda.org/r/r-tidyr.
아직 설치하지 않았다면 다음 명령을 입력하여 tidyr을 설치하세요.
install.packages("tidyr")
모으다()
gather() 함수의 목적은 데이터를 넓은 형태에서 긴 형태로 변환하는 것입니다.
통사론
gather(data, key, value, na.rm = FALSE)
Arguments:
-data: The data frame used to reshape the dataset
-key: Name of the new column created
-value: Select the columns used to fill the key column
-na.rm: Remove missing values. FALSE by default
예시
아래에서 우리는 레샤의 개념을 시각화할 수 있습니다.ping 가로형에서 세로형으로 변환합니다. 분기별 변수 행들로 채워진 '성장률'이라는 단일 열을 만들고자 합니다. 아래 그림은 왼쪽이 가로형 표이고 오른쪽이 세로형으로 변환된 표입니다.

library(tidyr)
# Create a messy dataset
messy <- data.frame(
  country = c("A", "B", "C"),
  q1_2017 = c(0.03, 0.05, 0.01),
  q2_2017 = c(0.05, 0.07, 0.02),
  q3_2017 = c(0.04, 0.05, 0.01),
  q4_2017 = c(0.03, 0.02, 0.04))
messy
출력:
##   country q1_2017 q2_2017 q3_2017 q4_2017
## 1       A    0.03    0.05    0.04    0.03
## 2       B    0.05    0.07    0.05    0.02
## 3       C    0.01    0.02    0.01    0.04
# Reshape the data
tidier <-messy %>%
gather(quarter, growth, q1_2017:q4_2017)
tidier
출력:
##    country quarter growth
## 1        A q1_2017   0.03
## 2        B q1_2017   0.05
## 3        C q1_2017   0.01
## 4        A q2_2017   0.05
## 5        B q2_2017   0.07
## 6        C q2_2017   0.02
## 7        A q3_2017   0.04
## 8        B q3_2017   0.05
## 9        C q3_2017   0.01
## 10       A q4_2017   0.03
## 11       B q4_2017   0.02
## 12       C q4_2017   0.04
gather() 함수에서는 원래 데이터 세트에 country라는 그룹 변수 하나와 키-값 쌍만 있으므로 quarter와 growth라는 두 개의 새 변수를 생성합니다. tidyr 1.0.0 이상 버전에서는 동일한 재구성이 pivot_longer(messy, cols = q1_2017:q4_2017, names_to = “quarter”, values_to = “growth”)로 작성됩니다.
확산()
spread() 함수는 gather() 함수와 반대되는 기능을 합니다.
통사론
spread(data, key, value)
arguments:
data: The data frame used to reshape the dataset
key: Column to reshape long to wide
value: Rows used to fill the new column
예시
spread() 함수를 사용하면 정리된 데이터셋을 다시 지저분한 형태로 되돌릴 수 있습니다.
# Reshape the data
messy_1 <- tidier %>%
  spread(quarter, growth)
messy_1
출력:
##   country q1_2017 q2_2017 q3_2017 q4_2017
## 1       A    0.03    0.05    0.04    0.03
## 2       B    0.05    0.07    0.05    0.02
## 3       C    0.01    0.02    0.01    0.04
현대의 이에 상응하는 함수는 pivot_wider(tidier, names_from = quarter, values_from = growth)입니다.
분리된()
`separate()` 함수는 구분자를 기준으로 열을 두 개로 나눕니다. 이 함수는 변수가 날짜인 경우에 유용합니다. 예를 들어, 분석에서 월과 연도에 초점을 맞춰야 할 경우, 해당 열을 두 개의 새로운 변수로 분리할 수 있습니다.
통사론
separate(data, col, into, sep= "", remove = TRUE)
arguments:
-data: The data frame used to reshape the dataset
-col: The column to split
-into: The name of the new variables
-sep: Indicates the symbol used that separates the variable, i.e.:  "-", "_", "&"
-remove: Remove the old column. By default sets to TRUE.
예시
Separate() 함수를 적용하여 더 깔끔한 데이터세트의 연도에서 분기를 분할할 수 있습니다.
separate_tidier <-tidier %>%
separate(quarter, c("Qrt", "year"), sep ="_")
head(separate_tidier)
출력:
##   country Qrt year growth
## 1       A  q1 2017   0.03
## 2       B  q1 2017   0.05
## 3       C  q1 2017   0.01
## 4       A  q2 2017   0.05
## 5       B  q2 2017   0.07
## 6       C  q2 2017   0.02
맞잡다()
unite() 함수는 두 열을 하나로 연결합니다.
통사론
unite(data, col, conc ,sep= "", remove = TRUE)
arguments:
-data: The data frame used to reshape the dataset
-col: Name of the new column
-conc: Name of the columns to concatenate
-sep: Indicates the symbol used that unites the variable, i.e:  "-", "_", "&"
-remove: Remove the old columns. By default, sets to TRUE
예시
위 예시에서는 분기와 연도를 분리했습니다. 만약 분기와 연도를 합치고 싶다면 어떻게 해야 할까요? 다음 코드를 사용하면 됩니다.
unit_tidier <- separate_tidier %>%
  unite(Quarter, Qrt, year, sep ="_")
head(unit_tidier)
출력:
##   country Quarter growth
## 1       A q1_2017   0.03
## 2       B q1_2017   0.05
## 3       C q1_2017   0.01
## 4       A q2_2017   0.05
## 5       B q2_2017   0.07
## 6       C q2_2017   0.02
재구성된 데이터 프레임은 이제 나머지 부분에서 다루는 모델링 단계를 진행할 준비가 되었습니다. R 튜토리얼 시리즈.
