
MongoDB Order By 예제를 사용한 Sort() 및 Limit() 쿼리
 스티븐 트웨인
⚡ 스마트 요약
MongoDB sort() 및 limit() 쿼리 수정자는 쿼리가 반환하는 문서의 개수와 순서를 제어합니다. limit() 메서드는 결과 개수를 제한하고, sort() 메서드는 1 또는 -1 값을 사용하여 문서를 오름차순 또는 내림차순으로 정렬합니다.
쿼리 수정이란 무엇입니까?
몽고 DB 'limit' 및 'Orders' 절과 같은 쿼리 수정자를 제공하여 쿼리를 실행할 때 더 많은 유연성을 제공합니다. 다음 쿼리 수정자를 살펴보겠습니다.
MongoDB 쿼리 결과 제한
이 수정자는 쿼리에 대한 결과 집합에서 반환되는 문서 수를 제한하는 데 사용됩니다. 다음 예는 이것이 어떻게 수행될 수 있는지 보여줍니다.
db.Employee.find().limit(2).forEach(printjson);
Code 설명
- 위 코드는 컬렉션의 모든 문서를 반환하는 find 함수를 사용하지만, return 절을 사용하여 반환되는 문서 수를 2개로 제한합니다.
산출
명령이 성공적으로 실행되면 다음 출력이 표시됩니다.
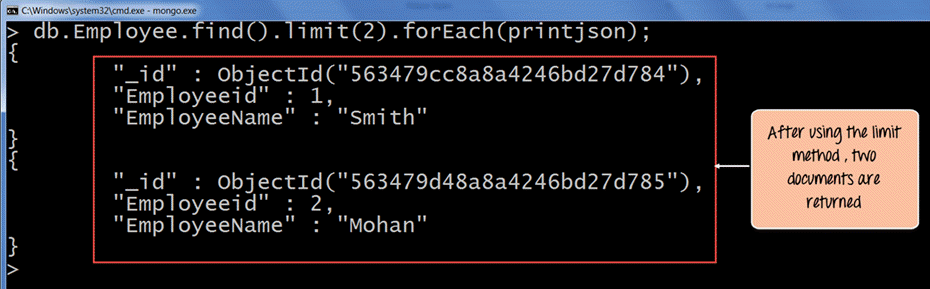
출력에는 제한 수정자가 있으므로 ObjectId를 기반으로 오름차순으로 결과 집합의 일부로 최대 2개의 레코드만 반환된다는 것을 명확하게 보여줍니다.
MongoDB 내림차순으로 정렬
컬렉션의 모든 키의 오름차순 또는 내림차순에 따라 반환할 문서의 순서를 지정할 수 있습니다. 다음 예는 이를 수행하는 방법을 보여줍니다.
db.Employee.find().sort({Employeeid:-1}).forEach(printjson)
Code 설명
- 위의 코드는 컬렉션의 모든 문서를 반환하는 정렬 함수를 사용하지만 수정자를 사용하여 레코드가 반환되는 순서를 변경합니다. 여기서 -1은 직원 ID의 내림차순으로 문서를 반환한다는 의미입니다.
명령이 성공적으로 실행되면 다음 출력이 표시됩니다.
산출

출력에는 Employeeid의 내림차순으로 반환되는 문서가 명확하게 표시됩니다.
오름차순은 값 1로 정의됩니다.
MongoDB 오름차순으로 정렬
sort() 함수는 내림차순으로 문서를 반환할 수 있는 것처럼 오름차순으로도 반환할 수 있습니다. sort 객체에서 값이 1이면 오름차순으로 정렬됩니다. 이렇게 하면 문서가 가장 작은 값부터 가장 큰 값 순으로 정렬되므로, 오래된 레코드부터 최신 레코드 순으로 또는 알파벳순(A부터 Z까지)으로 목록을 표시할 때 유용합니다.
다음 예시는 모든 직원 문서를 직원 ID를 기준으로 오름차순으로 정렬합니다.
db.Employee.find().sort({Employeeid:1}).forEach(printjson)
쿼리 작동 방식은 다음과 같습니다.
- find() 함수는 Employee 컬렉션에 있는 모든 문서를 검색합니다.
- sort({Employeeid:1})는 Employeeid 필드를 기준으로 결과를 가장 낮은 ID부터 가장 높은 ID 순으로 정렬합니다.
- forEach(printjson)는 각 문서를 읽기 쉬운 JSON 형식으로 출력합니다.
이 명령을 실행하면 문서가 직원 ID가 증가하는 순서대로 표시됩니다. 오름차순 정렬이 기본 정렬 방향이므로 값을 1로 유지하면 선택한 필드를 기준으로 낮은 값에서 높은 값 순으로 정렬됩니다. 정렬 순서를 반대로 하려면 값을 1에서 -1로 변경하면 됩니다. 또한 limit() 함수를 연결하여 처음 몇 개의 정렬된 레코드만 반환할 수도 있습니다.
MongoDB 페이지네이션을 건너뛰려면 Skip() 함수를 사용하세요.
skip() 메서드는 다음과 같이 알려줍니다. MongoDB 지정된 개수의 문서를 무시한 후 나머지 문서를 반환합니다. skip() 함수는 단독으로는 거의 유용하지 않지만, limit() 함수와 함께 사용하면 페이지네이션 기능을 구현하여 결과를 한 페이지씩 표시할 수 있습니다.
다음 예시는 처음 두 직원을 건너뛰고 다음 두 직원을 반환합니다.
db.Employee.find().skip(2).limit(2).forEach(printjson)
페이지별 탐색 기능을 구축하려면 다음 패턴을 따르세요.
- 페이지 크기를 정하세요. 예를 들어 페이지당 문서 2개를 표시할 수 있습니다.
- 페이지 크기에 페이지 수에서 1을 뺀 값을 곱하면 건너뛰기 값을 구할 수 있습니다.
- 해당 값을 skip() 함수에 전달하고 페이지 크기를 limit() 함수에 전달하세요.
예를 들어, 1페이지에서는 skip(0).limit(2)를 사용하고, 2페이지에서는 skip(2).limit(2)를 사용하며, 3페이지에서는 skip(4).limit(2)를 사용합니다. 문서 순서가 페이지 간에 안정적으로 유지되도록 항상 sort() 함수를 추가해야 합니다. 단, 매우 큰 skip 값은 대규모 컬렉션에서 속도가 느려질 수 있습니다. MongoDB 여전히 건너뛴 문서를 스캔하고 폐기하지만, 범위 기반 페이지 매김은 대규모 환경에서 더 빠릅니다.
여러 필드를 기준으로 정렬 MongoDB
MongoDB 한 번에 여러 필드를 기준으로 정렬할 수 있습니다. 정렬 객체에 필드를 우선순위 순으로 나열하면 됩니다. MongoDB 첫 번째 필드를 기준으로 정렬한 다음, 다음 필드를 사용하여 동점일 경우 해결하고, 이런 식으로 계속 진행합니다.
다음 예시는 직원을 이름으로 오름차순 정렬하고, 이름이 같은 직원의 경우 직원 ID로 내림차순 정렬합니다.
db.Employee.find().sort({EmployeeName:1, Employeeid:-1}).forEach(printjson)
정렬 객체의 키 순서는 중요합니다. EmployeeName이 가장 먼저 나타나므로 먼저 적용됩니다. 이러한 다중 키 정렬은 하나의 필드를 기준으로 그룹화한 다음 각 그룹 내에서 순위를 매기는 보고서에 유용합니다. 대규모 컬렉션에서 최상의 성능을 얻으려면 정렬에 사용되는 필드 및 방향과 일치하는 복합 인덱스를 생성하십시오.
