
로케이터 Selenium
 Krishna 룽타
⚡ 스마트 요약
로케이터 Selenium 이러한 명령어는 자동화 엔진에게 텍스트 상자, 버튼, 체크박스와 같은 GUI 요소를 식별하도록 지시합니다. 이 참조 문서에서는 ID, 이름, 링크 텍스트, DOM 및 XPath 로케이터 유형을 실제 예제, 구문 규칙 및 안정적인 웹 자동화 스크립트를 위한 선택 전략과 함께 설명합니다.
위치 추적기란 무엇인가요? Selenium?
로케이터는 지시하는 명령입니다. Selenium IDE 또는 Selenium WebDriver는 텍스트 상자, 버튼, 링크 또는 체크박스와 같이 작업을 수행해야 하는 올바른 GUI 요소에 접근해야 합니다. 올바른 GUI 요소를 식별하는 것은 신뢰할 수 있는 자동화 스크립트를 구축하는 데 필수적입니다. 그러나 정확한 식별은 생각보다 어렵습니다. 때로는 잘못된 요소 또는 아무 요소와도 상호 작용하게 될 수 있습니다. 이러한 문제를 해결하기 위해, Selenium GUI 요소를 정확하게 타겟팅할 수 있는 다양한 위치 지정 전략을 제공합니다.
"열기" 명령과 같은 일부 명령은 로케이터를 필요로 하지 않지만, 대부분의 명령은 로케이터를 필요로 합니다. Selenium 명령어는 요소 위치 지정자에 따라 달라집니다. 로케이터 선택은 테스트 대상 애플리케이션(AUT)에 따라 크게 달라집니다. 이 튜토리얼에서는 페이스북과 다른 앱을 번갈아 가며 사용하겠습니다. Mercury 투어 데모 사이트(newtours.demoaut)는 각 애플리케이션이 지원하는 위치 정보 검색 엔진을 기반으로 합니다. 마찬가지로, 여러분의 사이트에서도 동일한 방식으로 투어 데모를 진행할 수 있습니다. 테스트 프로젝트에서 요소 로케이터를 선택하게 됩니다. Selenium WebDriver는 애플리케이션 구조에 따라 달라집니다.
ID로 찾기
ID는 페이지의 각 요소에 고유한 값을 부여하도록 설계되었기 때문에 요소를 찾는 가장 일반적인 방법입니다. ID 속성이 있는 경우, 빠르고 안정적이며 가독성이 뛰어난 테스트 스크립트를 작성하려면 ID 속성을 우선적으로 사용하는 것이 좋습니다.
Target 체재: id=요소의 ID
이 예시에서는 페이스북 데모 페이지를 사용하겠습니다. Mercury Tours는 주요 폼 필드에 ID 속성을 사용하지 않습니다.
단계 1) 이 데모 페이지를 사용하세요 https://demo.guru99.com/test/facebook.html 테스트를 위해 브라우저의 내장 개발자 도구(Chrome, Edge 등에서 F12 키 누름)를 사용하여 "이메일 또는 전화번호" 텍스트 상자를 검사하십시오. Firefox) 그리고 해당 ID를 기록해 두세요. 이 경우 ID는 "이메일"입니다.

단계 2) 실행 Selenium IDE에서 "id=email"을 입력하세요. Target 상자를 클릭합니다. 찾기 버튼을 클릭하면 "이메일 또는 전화번호" 텍스트 상자가 녹색 테두리가 있는 노란색으로 강조 표시됩니다. 이는 해당 상자가 이메일 또는 전화번호임을 나타냅니다. Selenium IDE가 요소를 올바르게 찾았습니다.

이름으로 찾기
이름으로 요소를 찾는 것은 ID로 찾는 것과 유사하지만, 사용하는 방식이 다릅니다. “이름=” 접두사를 사용하는 대신 접두사를 사용합니다. 이 방법은 요소에 ID는 없지만 이름 속성이 정의되어 있는 경우에 유용합니다.
Target 체재: name=요소의 이름
다음 시연에서는 다음을 사용하겠습니다. Mercury 사이트의 모든 중요한 형태 요소에 이름 속성이 있기 때문에 투어라고 부릅니다.
단계 1) 로 이동 https://demo.guru99.com/test/newtours/ 브라우저 개발자 도구를 사용하여 "사용자 이름" 텍스트 상자를 검사하고 name 속성을 확인하십시오.

여기서 요소의 이름은 "userName"입니다.
단계 2) In Selenium IDE에서 "name=userName"을 입력합니다. Target 상자를 클릭하고 찾기 버튼을 클릭하세요. Selenium IDE는 사용자 이름 텍스트 상자를 강조 표시하여 찾아야 합니다.

필터를 사용하여 이름으로 요소를 찾는 방법
필터는 여러 요소가 동일한 이름 속성을 공유할 때 유용합니다. 필터는 동일한 이름을 공유하는 요소를 구분하는 데 사용되는 추가 속성입니다. 필터 없이 Selenium 첫 번째로 일치하는 요소만 기본값으로 사용합니다.
Target 체재: 이름=name_of_the_element 필터=value_of_filter
예를 들어 설명해 보겠습니다.
단계 1) 다음에 로그온하십시오. Mercury 투어.
유튜브에서 Mercury 사용자 이름과 비밀번호 모두에 "tutorial"을 사용하여 투어를 예약하세요. 아래와 같이 항공편 검색 페이지가 나타납니다.

단계 2) 개발자 도구를 사용하여 VALUE 속성을 검사하십시오.
왕복 및 편도 라디오 버튼의 이름이 "tripType"으로 동일하다는 점에 유의하세요. 하지만 두 버튼은 VALUE 속성이 다르므로 각 값을 필터로 사용할 수 있습니다.

단계 3) 편집기에서 첫 번째 행을 클릭하세요.
- 먼저 '일방통행' 라디오 버튼에 접근하겠습니다. 첫 번째 줄을 클릭하세요. Selenium IDE 편집기.
- 명령 상자에 "클릭" 명령을 입력합니다.
- . Target 해당 칸에 “name=tripType value=oneway”를 입력하세요. “value=oneway” 부분이 필터 역할을 합니다.

단계 4) 찾기 버튼을 클릭하세요.
그것을주의해라 Selenium IDE는 단방향 라디오 버튼을 녹색으로 강조 표시하여 해당 요소에 VALUE 속성을 통해 성공적으로 접근했음을 확인시켜 줍니다.

단계 5) '일방통행' 라디오 버튼을 선택하세요.
키보드의 "X" 키를 눌러 클릭 명령을 실행하세요. 이제 "단방향" 라디오 버튼이 선택되었습니다.

왕복 라디오 버튼에 대해서도 동일한 작업을 수행할 수 있으며, 이번에는 대상으로 "name=tripType value=roundtrip"을 사용하면 됩니다.
링크 텍스트로 찾기
이 로케이터 전략은 하이퍼링크 텍스트에만 적용됩니다. 대상 앞에 "link="를 붙이고 그 뒤에 보이는 하이퍼링크 텍스트를 추가하여 링크에 접근합니다. 이 방법은 가독성이 뛰어나며 내비게이션 테스트에 효과적입니다.
Target 체재: 링크=링크_텍스트
다음 예시에서는 웹사이트에서 찾을 수 있는 "등록" 링크에 접속하겠습니다. Mercury 투어 홈페이지.
단계 1)
- 먼저, 로그아웃되어 있는지 확인하십시오. Mercury 투어.
- 로 이동 Mercury 투어 홈페이지.
단계 2)
- 개발자 도구를 사용하여 "REGISTER" 링크를 검사하세요. 링크 텍스트는 여는 앵커 태그와 닫는 앵커 태그 사이에 나타납니다.
- 이 경우 링크 텍스트는 "등록"입니다. 링크 텍스트를 복사하세요.
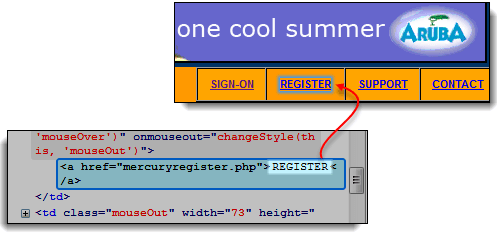
단계 3) 링크 텍스트를 복사하여 붙여넣으세요. Selenium IDE Target 상자. 접두사로 "link="를 붙입니다.

단계 4) 찾기 버튼을 클릭하세요. Selenium IDE는 '등록' 링크를 올바르게 강조 표시합니다.

단계 5) 더 자세히 확인하려면 명령 상자에 "clickAndWait"를 입력하고 실행하세요. Selenium IDE가 등록 링크를 성공적으로 클릭하면 아래와 같은 등록 페이지로 이동합니다.

DOM(문서 개체 모델)으로 찾기
The 문서 객체 모델 (DOM)간단히 말해, HTML 요소들이 노드 트리 구조로 이루어져 있음을 설명합니다. Selenium IDE는 이 트리 구조를 탐색하여 페이지 요소에 접근할 수 있습니다. 이 방법을 사용할 때, Target box는 항상 “dom=document…”로 시작합니다. “dom=” 접두사는 일반적으로 생략됩니다. Selenium IDE는 "document"로 시작하는 모든 값을 자동으로 DOM 경로로 해석합니다.
DOM에서 요소를 찾는 기본적인 방법은 네 가지가 있습니다. Selenium:
- getElementById
- getElementsByName
- dom:name(이름이 지정된 형식 내의 요소에만 적용됨)
- 돔:색인
DOM으로 찾기 – getElementById
먼저 DOM의 getElementById 메서드를 살펴보겠습니다. Selenium이 메서드는 ID 속성을 일치시켜 단일 요소를 반환합니다.
통사론
document.getElementById("id of the element")
- 요소의 ID는 접근하려는 요소의 ID 속성 값입니다. 이 값은 항상 따옴표로 묶어야 합니다.
단계 1) 이 데모 페이지를 사용하세요 https://demo.guru99.com/test/facebook.html해당 페이지로 이동하여 개발자 도구를 사용하여 "로그인 상태 유지" 확인란을 검사하고 해당 ID를 기록해 두세요.

우리가 사용해야 할 ID는 "persist_box"입니다.
단계 2) 엽니다 Selenium IDE와 Target 상자에 document.getElementById(“persist_box”)를 입력한 다음 찾기를 클릭합니다. Selenium IDE는 "로그인 상태 유지" 확인란을 찾습니다. 확인란 내부를 강조 표시할 수는 없지만 아래 그림과 같이 해당 요소를 밝은 녹색 테두리로 둘러쌉니다.

DOM으로 찾기 – getElementsByName
getElementById 메서드는 지정된 ID를 가진 요소 하나만 한 번에 접근합니다. getElementsByName 메서드는 이와는 다르게 동작합니다. 이 메서드는 지정된 이름을 공유하는 요소들의 배열을 반환합니다. 개별 요소는 0부터 시작하는 숫자 인덱스를 사용하여 접근합니다.
 |
getElementById 이 메서드는 하나의 요소만 반환합니다. 해당 요소는 getElementById()의 괄호 안에 지정된 ID를 가집니다. |
 |
getElementsByName 이 함수는 이름이 같은 요소들의 컬렉션을 반환합니다. 각 요소는 배열처럼 0부터 시작하는 숫자로 인덱싱됩니다. 아래 구문에서 대괄호 안에 인덱스를 넣어 특정 요소를 선택할 수 있습니다. |
통사론
document.getElementsByName("name")[index]
- name = 'name' 속성으로 정의된 요소의 이름
- index = getElementsByName의 배열 내에서 어떤 요소가 사용될 것인지를 나타내는 정수입니다.
단계 1) 로 이동 Mercury 투어 홈페이지에 접속하여 사용자 이름과 비밀번호에 "tutorial"을 입력하여 로그인하세요. 그러면 항공편 검색 화면이 나타납니다.
단계 2) 개발자 도구를 사용하여 페이지 하단에 있는 세 개의 라디오 버튼(Economy 클래스, Business 클래스, First 클래스)을 검사해 보세요. 세 버튼 모두 "servClass"라는 동일한 이름을 가지고 있는 것을 확인할 수 있습니다.

단계 3) 먼저 "이코노미 클래스" 라디오 버튼에 접근해 보겠습니다. 세 개의 라디오 버튼 중 이 버튼이 가장 먼저 나타나므로 인덱스는 0입니다. Selenium IDE에서 document.getElementsByName(“servClass”)[0]를 입력하고 찾기 버튼을 클릭합니다. Selenium IDE는 이코노미 클래스 라디오 버튼을 정확하게 식별합니다.

단계 4) 인덱스 번호를 1로 변경하세요. 그러면 Target document.getElementsByName(“servClass”)[1]가 됩니다. 찾기 버튼을 클릭하면 Selenium IDE는 아래 그림과 같이 "비즈니스 클래스" 라디오 버튼을 강조 표시합니다.

DOM으로 찾기 – dom:name
앞서 언급했듯이, 이 방법은 접근하려는 요소가 이름이 지정된 폼 내에 있는 경우에만 적용됩니다. 로케이터 경로는 폼에서 시작하여 이름으로 대상 요소까지 탐색합니다.
통사론
document.forms["name of the form"].elements["name of the element"]
- 폼의 이름은 접근하려는 요소를 포함하는 폼 태그의 name 속성 값입니다.
- 요소 이름 = 액세스하려는 요소의 이름 속성 값
단계 1) 로 이동 Mercury 투어 홈페이지 https://demo.guru99.com/test/newtours/ 개발자 도구를 사용하여 사용자 이름 텍스트 상자를 검사해 보세요. 해당 상자가 "home"이라는 이름의 폼 안에 포함되어 있음을 알 수 있습니다.

단계 2) In Selenium IDE에서 document.forms[“home”].elements[“userName”]을 입력하고 찾기 버튼을 클릭합니다. Selenium IDE가 해당 요소에 성공적으로 접근합니다.

DOM으로 찾기 – dom:index
이 방법은 요소가 명명된 폼 내부에 있지 않더라도 폼의 이름 대신 인덱스를 사용하기 때문에 적용됩니다. 이는 명명 규칙을 사용할 수 없는 기존 페이지나 자동 생성된 폼에 유용합니다.
통사론
document.forms[index of the form].elements[index of the element]
- 폼의 인덱스 = 페이지 전체에서 해당 폼의 인덱스 번호(0부터 시작)
- 요소의 인덱스 = 해당 요소를 포함하는 폼을 기준으로 한 요소의 인덱스 번호(0부터 시작)
우리는 "전화" 텍스트 상자에 접근할 것입니다. Mercury 투어 등록 페이지입니다. 이 페이지의 양식에는 이름이나 ID 속성이 없으므로 좋은 예시가 됩니다.
단계 1) 로 이동 Mercury 투어 등록 페이지를 살펴보고 전화번호 입력란을 확인해 보세요. 주변 양식에 ID나 이름 속성이 없는 것을 알 수 있습니다.

단계 2) document.forms[0].elements[3]을 입력하세요. Selenium IDE Target 상자를 클릭하고 찾기 버튼을 클릭하세요. Selenium IDE는 전화번호 텍스트 상자에 올바르게 접근할 수 있습니다.

단계 3) 또는 인덱스 대신 요소의 이름을 사용하여 동일한 결과를 얻을 수도 있습니다. document.forms[0].elements[“phone”]을 입력하세요. Target 상자. 전화번호 입력란은 여전히 선택된 상태로 유지됩니다.

XPath로 찾기
XPath는 XML(확장 가능한 마크업 언어) 노드를 탐색하는 데 사용되는 쿼리 언어입니다. HTML은 XML의 구현으로 간주될 수 있기 때문에, xpath HTML 요소도 찾을 수 있습니다. 이는 가장 강력한 요소 찾기 전략 중 하나입니다. Selenium.
- 이점: 클래스, 이름 또는 ID 속성이 없는 요소를 포함하여 거의 모든 요소에 접근할 수 있습니다.
- 불리: 이는 수많은 규칙과 구문 변형으로 인해 가장 복잡한 위치 지정 전략입니다.
최신 브라우저의 개발자 도구는 XPath 표현식을 자동으로 생성할 수 있습니다. Chrome, Edge 등에서 사용 가능합니다. Firefox요소 패널에서 요소를 마우스 오른쪽 버튼으로 클릭하고 복사 > XPath 복사를 선택합니다. 다음 예에서는 앞서 설명한 방법으로는 찾을 수 없는 이미지에 접근하는 방법을 보여줍니다.
단계 1) 로 이동 Mercury 투어 홈페이지로 이동하여 개발자 도구를 사용하여 아래 그림과 같이 노란색 "링크" 상자 오른쪽에 있는 주황색 사각형을 검사해 보세요.

단계 2) 요소의 HTML 코드를 마우스 오른쪽 버튼으로 클릭한 다음 "XPath 복사" 옵션을 선택합니다.

단계 3) In Selenium IDE입력란에 슬래시 “/” 하나를 입력하세요. Target 상자를 클릭한 다음 이전 단계에서 복사한 XPath를 붙여넣습니다. 항목은 다음과 같습니다. Target 이제 상자는 두 개의 슬래시 "//"로 시작해야 합니다.

단계 4) 찾기 버튼을 클릭하세요. Selenium IDE는 아래 그림과 같이 주황색 상자를 강조 표시합니다.

적합한 위치 선정 업체를 선택하는 것이 중요한 이유
올바른 위치 추적 전략을 선택하는 것은 가장 영향력 있는 결정 중 하나입니다. Selenium 자동화는 스크립트 안정성, 실행 속도 및 장기 유지 관리 비용에 직접적인 영향을 미치기 때문에 중요합니다. 로케이터를 잘못 선택하면 테스트가 불안정해지고, 잘못된 오류가 발생하며, 애플리케이션 UI가 변경될 때마다 잦은 재작업이 발생할 수 있습니다. 숙련된 자동화 엔지니어들이 권장하는 로케이터 순서는 ID가 가장 높고, 그다음 이름, CSS 선택자, 링크 텍스트, 마지막으로 XPath입니다.
ID 기반 로케이터는 브라우저의 조회 기능이 고유 식별자에 최적화되어 있기 때문에 가장 빠릅니다. 이름 기반 로케이터는 이름이 고유할 경우 거의 동일한 효율성을 제공합니다. CSS 선택자와 XPath는 유연성을 제공하지만 개발자가 DOM을 재구성할 때 속도가 느리고 안정성이 떨어지는 경향이 있습니다. 링크 텍스트는 탐색 링크에 적합하지만 재사용성이 제한적입니다.
안정적인 자동화는 개발자와의 협업에도 달려 있습니다. 테스터가 코드 리뷰 중에 일관되고 의미 있는 ID 또는 data-* 속성을 요청하면 로케이터의 내구성이 크게 향상됩니다. 빌드 간에 변경될 수 있는 자동 생성 ID(프레임워크에서 생성하는 ID 등)에 의존하지 마십시오. 가독성이 좋고 의도에 부합하는 로케이터를 우선시함으로써 팀은 테스트 스위트를 유지 관리하기 쉽게 만들고 애플리케이션이 발전함에 따라 기술 부채를 줄일 수 있습니다.
신뢰할 수 있는 위치 정보 작성을 위한 최고의 실천 방법
신뢰할 수 있는 위치 탐지기는 유지 관리가 가능한 시스템의 기반입니다. Selenium 테스트 스위트. 다음의 방법들을 따르면 스크립트 오류를 줄이고, 가독성을 높이며, UI 변경에 대한 테스트의 복원력을 강화할 수 있습니다.
- 고유 ID를 선호합니다. 항상 ID 속성을 먼저 확인하세요. ID는 페이지 내에서 고유해야 하며 성능을 가장 잘 보장하는 선택입니다.
- 의미론적 이름 및 데이터 속성을 사용하십시오. 개발자들이 `data-testid` 또는 `data-qa`와 같은 안정적인 테스트 속성을 추가하도록 권장하세요. 이러한 속성은 CSS 클래스가 변경되더라도 일관성을 유지합니다.
- 절대 XPath 사용을 피하십시오. /html/body/div[2]/div[3]/span과 같은 절대 경로는 쉽게 깨집니다. //input[@name='userName']과 같은 속성을 사용하는 상대 XPath 표현식을 사용하십시오.
- 정확도를 높이기 위해 속성을 결합하세요: 단일 속성이 고유하지 않은 경우, 여러 속성을 결합하여(예: //button[@type='submit' 및 @name='login']) 올바른 요소를 대상으로 지정할 수 있습니다.
- 텍스트를 현명하게 사용하세요: 표시되는 텍스트에 의존하는 위치 지정자는 언어 현지화 과정에서 오류가 발생할 수 있습니다. 텍스트 기반 위치 지정자는 콘텐츠가 안정적이고 단일 언어로 제공되는 경우에만 사용하십시오.
- 위치 정보 중앙 집중화: 페이지 객체 모델(POM) 클래스에 로케이터를 저장하여 여러 테스트 스크립트에 걸쳐 업데이트하는 대신 한 곳에서만 업데이트할 수 있도록 합니다.
- 개발자 도구에서 유효성을 검사하세요. 스크립트에 로케이터를 추가하기 전에 브라우저 콘솔에서 XPath의 경우 `$x(“//xpath”)`를, CSS의 경우 `document.querySelector`를 사용하여 정확히 하나의 요소만 반환하는지 테스트하십시오.
- 가능하면 인덱스 기반 로케이터를 사용하지 마십시오. [3]과 같은 인덱스 위치는 요소 순서에 따라 달라집니다. 사소한 레이아웃 변경이라도 인덱스가 바뀌어 스크립트가 깨질 수 있습니다.
자동화 엔지니어는 이러한 방식을 일관되게 적용함으로써 팀 전체에 걸쳐 확장 가능하고 최소한의 유지 관리로 잦은 UI 업데이트에도 견딜 수 있는 테스트 스위트를 구축할 수 있습니다.
