
TensorFlow를 사용한 선형 회귀 튜토리얼 [예제]
 편집 팀
⚡ 스마트 요약
TensorFlow의 선형 회귀 모델은 숫자형 특징과 연속형 목표값 사이의 관계를 모델링합니다. 이 가이드에서는 Pandas, NumPy, 그리고 LinearRegressor 추정기를 사용하는 TensorFlow의 기본 입력 파이프라인을 각각 다른 세 가지 방식으로 활용하여 보스턴 주택 가격을 예측하는 모델을 학습시킵니다.
선형 회귀는 무엇입니까?
선형 회귀 선형 회귀는 두 변수 간의 관계를 모델링하는 통계학적 접근 방식입니다. 이 모델링은 스칼라 응답 변수와 하나 이상의 설명 변수 간의 관계를 대상으로 합니다. 설명 변수가 하나인 경우를 단순 선형 회귀라고 하고, 설명 변수가 두 개 이상인 경우를 다중 선형 회귀라고 합니다.
TensorFlow는 계산을 완전히 제어할 수 있는 도구를 제공합니다. 이는 저수준 API를 통해 수행됩니다. 게다가 TensorFlow는 다양한 작업을 수행할 수 있는 광범위한 API를 갖추고 있습니다. 기계 학습 알고리즘입니다. 이것은 상위 수준 API이며, TensorFlow에서는 이를 추정기라고 부릅니다.
- 저수준 API모델의 아키텍처와 최적화를 처음부터 구축해야 합니다. 초보자에게는 복잡한 작업입니다.
- 높은 수준의 API알고리즘을 정의하세요. 사용하기 쉽습니다. TensorFlow는 툴박스라는 것을 제공합니다. 견적 자 구성, 훈련, 평가 및 예측을 수행합니다.
이 튜토리얼에서는 추정자만계산 속도가 더 빠르고 구현도 더 쉽습니다. 첫 번째 부분에서는 경사 하강법 최적화 도구를 사용하여 TensorFlow에서 선형 회귀 모델을 학습하는 방법을 설명합니다. 두 번째 부분에서는 보스턴 데이터셋을 사용하여 TensorFlow 추정기로 주택 가격을 예측합니다.
선형 회귀 모델을 훈련하는 방법
모델 학습을 시작하기 전에 선형 회귀가 실제로 무엇인지 살펴보겠습니다.
두 변수 x와 y가 있고, x의 값을 알고 있을 때 y의 값을 예측하는 것이 여러분의 목표라고 가정해 봅시다. 데이터를 그래프로 나타내면 아래 산점도에서 볼 수 있듯이 독립 변수 x와 종속 변수 y 사이에 양의 상관관계가 있음을 알 수 있습니다.

x=1일 때 y는 대략 6이 되고, x=2일 때 y는 약 8.5가 된다는 것을 알 수 있습니다.
이 방법은 정확도가 높지 않고, 특히 수십만 개의 데이터 포인트가 포함된 데이터 세트의 경우 오류가 발생하기 쉽습니다.
선형 회귀는 방정식으로 평가됩니다. 변수 y는 하나 이상의 공변량으로 설명됩니다. 귀하의 예에는 종속 변수가 하나만 있습니다. 이 방정식을 작성해야 한다면 다음과 같습니다.

와:
 편향입니다. 즉, x=0이면 y=
 x와 관련된 가중치는 무엇입니까?
 잔차, 즉 모델의 오차입니다. 여기에는 모델이 데이터로부터 학습하지 못한 부분이 포함됩니다.
모델을 적합시키고 다음과 같은 해법을 찾았다고 가정해 보겠습니다.
- = 3.8
- = 2.78
해당 숫자를 방정식에 대입하면 다음과 같습니다.
y= 3.8 + 2.78x
이제 y 값을 찾는 더 나은 방법을 알게 되었습니다. 즉, x를 원하는 값으로 대체하여 y를 예측할 수 있습니다. 아래 이미지에서는 방정식의 x를 데이터 세트의 모든 값으로 대체하고 결과를 그래프로 나타냈습니다.

빨간색 선은 적합값, 즉 각 x 값에 대한 y 값을 나타냅니다. y 값을 예측하기 위해 x 값을 확인할 필요는 없습니다. 각 x 값에 대해 빨간색 선에 해당하는 값이 존재합니다. x 값이 2보다 큰 경우에도 예측이 가능합니다.
선형 회귀 분석을 더 많은 공변량으로 확장하려면 모델에 변수를 추가하면 됩니다. 전통적인 분석과 선형 회귀 분석의 차이점은 선형 회귀 분석은 각 변수 x가 독립적으로 y에 어떻게 반응하는지를 살펴본다는 점입니다.
예를 들어 보겠습니다. 아이스크림 가게의 매출을 예측하고 싶다고 가정해 봅시다. 데이터 세트에는 날씨(비, 맑음, 흐림)와 고객 정보(소득, 성별, 결혼 여부)와 같은 다양한 정보가 포함되어 있습니다.
전통적인 분석 방식은 예를 들어 각 변수의 평균값을 계산하고 다양한 시나리오에 따른 판매량을 추정하는 방식으로 판매량을 예측하려고 합니다. 하지만 이러한 방식은 예측 정확도가 떨어지고 분석 범위를 특정 시나리오로 제한하게 됩니다.
선형 회귀를 사용하는 경우 다음 방정식을 작성할 수 있습니다.
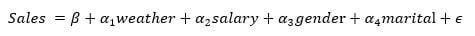
이 알고리즘은 가중치에 대한 최적의 해를 찾을 것입니다. 즉, 적합된 직선과 데이터 포인트 간의 차이인 비용을 최소화하려고 시도할 것입니다.
알고리즘 작동 방식
아래 다이어그램은 알고리즘이 반복하는 루프를 요약한 것입니다. 즉, 가중치를 선택하고, y 값을 예측하고, 오차를 측정하고, 가중치를 수정하는 과정입니다.

알고리즘은 각각에 대해 임의의 숫자를 선택합니다. 
 x의 값을 대체하여 예측된 y의 값을 얻습니다. 데이터 세트에 100개의 관측치가 있는 경우 알고리즘은 100개의 예측 값을 계산합니다.
우리는 오류를 계산할 수 있습니다.  모델의 오차는 예측값과 실제값의 차이입니다. 양의 오차는 모델이 y를 과소평가했음을 의미하고, 음의 오차는 모델이 y를 과대평가했음을 의미합니다.

여러분의 목표는 오차 제곱을 최소화하는 것입니다. 알고리즘은 오차 제곱의 평균을 계산합니다. 이 단계를 오차 최소화라고 합니다. 선형 회귀의 경우, 이는 다음과 같습니다. 평균 제곱 오차, MSE라고도 합니다. 수학적으로는 다음과 같습니다.

어디에:
 가중치입니다.
 예측된 값을 말합니다.
- y는 실제 값입니다.
- m은 관측치의 개수입니다.
 예측된 값을 말합니다.
참고  이는 행렬의 전치(transpose)를 사용한다는 것을 의미합니다. 그만큼
 평균의 수학적 표기법입니다.
목표는 최고의 것을 찾는 것입니다.  이는 MSE를 최소화합니다.
평균 오차가 크면 모델 성능이 좋지 않고 가중치가 제대로 선택되지 않았음을 의미합니다. 가중치를 수정하려면 옵티마이저를 사용해야 합니다. 전통적인 최적화 프로그램은 다음과 같습니다. 그라데이션 하강.
경사 하강법은 미분값을 구하고 가중치를 감소시키거나 증가시킵니다. 미분값이 양수이면 가중치를 감소시키고, 음수이면 가중치를 증가시킵니다. 모델은 가중치를 업데이트하고 오차를 다시 계산합니다. 이 과정은 오차가 더 이상 변하지 않을 때까지 반복됩니다. 각 단계를 반복이라고 합니다. 되풀이또한, 기울기는 학습률을 곱하는데, 이는 학습 속도를 나타냅니다.
학습률이 너무 작으면 알고리즘이 수렴하는 데 매우 오랜 시간이 걸립니다. 더 많은 반복 횟수가 필요하기 때문입니다. 반대로 학습률이 너무 크면 알고리즘이 수렴하지 못할 수도 있습니다. 아래 손실 곡선은 해당 데이터셋에 대한 반복 횟수에 따른 오류를 나타냅니다.

위 그림에서 볼 수 있듯이, 모델은 가중치의 안정적인 값을 찾기 전에 약 20번 정도 과정을 반복하며, 그 결과 가장 낮은 오차에 도달합니다.
오차가 0이 아니라 약 5 부근에서 안정화된다는 점에 유의하십시오. 이는 모델이 일반적으로 5 정도의 오차를 발생시킨다는 의미입니다. 오차를 줄이려면 변수를 더 추가하거나 다른 추정량을 사용하는 등 모델에 더 많은 정보를 추가해야 합니다.
첫 번째 방정식을 기억하시죠?

최종 가중치는 3.8과 2.78입니다. 아래 영상은 경사 하강법을 사용하여 손실 함수를 최적화하여 이러한 가중치를 찾는 과정을 보여줍니다.
TensorFlow를 사용하여 선형 회귀를 학습하는 방법
이제 내부적으로 무슨 일이 일어나고 있는지 더 잘 이해했으므로 TensorFlow에서 제공하는 추정기 API를 사용하여 TensorFlow를 사용한 첫 번째 선형 회귀를 학습할 준비가 되었습니다.
버전 참고: 아래에 표시된 추정기 워크플로는 TensorFlow 1.x 및 초기 2.x 릴리스를 기준으로 작성되었습니다. TensorFlow는 다음을 표시했습니다. tf.estimator tf.feature_column API는 버전 2.12에서 완전히 사용이 중단되었으며, Estimator는 버전 2.16에서 삭제되었습니다. 현재 설치된 환경에서는 이 코드를 TensorFlow 1.15 또는 2.x 환경에서 실행하세요.tf.compat.v1 환경을 변경하거나 Keras로 포팅하는 경우 tf.keras.layers.Dense(1) 또한 전처리 레이어가 LinearRegressor와 특징 열을 대체합니다. 특징, 레이블, 배치, 에포크, MSE 및 경사 하강법과 같은 개념은 변경되지 않고 그대로 유지됩니다.
여러분은 다음 변수들을 포함하는 보스턴 데이터셋을 사용하게 됩니다.
| 변하기 쉬운 | 기술설명 |
| 크림 | 도시별 XNUMX인당 범죄율 |
| zn | 25,000 평방피트를 초과하는 부지에 대해 구역화된 주거용 토지의 비율. |
| 인더스 문자 | 도시당 비소매 사업 면적의 비율. |
| 녹스 | 산화질소 농도 |
| rm | 가구당 평균 방 수 |
| 나이 | 1940년 이전에 건축된 자가 거주 주택의 비율 |
| 말요 | 보스턴 고용 센터 XNUMX곳까지의 가중치 거리 |
| 세 | 달러당 전체 재산세율 10,000 |
| 비율 | 도시별 학생-교사 비율 |
| 의료 | 소유자가 거주하는 주택의 중간 가치(천 달러) |
세 가지 다른 데이터 세트를 생성합니다.
| 데이터 세트 | 목표 | 형성 |
| 트레이닝 | 모델을 훈련하고 가중치를 얻습니다. | 400, 10 |
| 평가 | 보이지 않는 데이터에 대한 모델 성능 평가 | 100, 10 |
| 예측 | 모델을 사용하여 새 데이터에 대한 주택 가치 예측 | 6, 10 |
목표는 데이터셋의 특징을 이용하여 주택 가치를 예측하는 것입니다.
튜토리얼의 두 번째 부분에서는 세 가지 서로 다른 데이터 가져오기 방법을 사용하여 TensorFlow를 사용하는 방법을 배우게 됩니다.
- 팬더와 함께
- 와 눔 파이
- 텐서플로우만
세 가지 옵션 모두 동일한 결과를 제공한다는 점에 유의하십시오.
이 과정에서는 고수준 API를 사용하여 TensorFlow 선형 회귀 모델을 구축, 학습 및 평가하는 방법을 배우게 됩니다. 저수준 API를 사용하는 경우 다음 사항들을 직접 정의해야 합니다.
- 손실 기능
- 최적화 기법: 경사 하강법
- 행렬 곱셈
- 그래프와 텐서
이 과정은 지루하고 초보자에게는 더 복잡합니다.
판다스 솔루션
모델을 학습하려면 필요한 라이브러리를 가져와야 합니다.
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
단계 1) 다음을 사용하여 데이터를 가져옵니다. 판다.
컬럼 이름을 정의하고 COLUMNS에 저장합니다. pd.read_csv()를 사용하여 데이터를 가져올 수 있습니다.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
각 호출에서 이전에 다운로드한 CSV 파일을 지정하세요.
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
데이터의 모양을 인쇄할 수 있습니다.
print(training_set.shape, test_set.shape, prediction_set.shape)
산출
(400, 10) (100, 10) (6, 10)
레이블(즉, y)이 데이터셋에 포함되어 있다는 점에 유의하세요. 따라서 두 개의 추가 리스트를 정의해야 합니다. 하나는 특징(feature)만 포함하는 리스트이고, 다른 하나는 레이블 이름만 포함하는 리스트입니다. 이 두 리스트는 추정기에 데이터셋의 특징과 레이블이 어떤 열 이름인지 알려줍니다.
아래 코드로 완료됩니다.
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
단계 2) 데이터 변환
숫자형 변수를 적절한 형식으로 변환해야 합니다. TensorFlow는 연속형 변수를 변환하는 메서드인 `tf.feature_column.numeric_column()`을 제공합니다.
이전 단계에서 모델에 포함할 특징 목록을 정의했습니다. 이제 이 목록을 사용하여 해당 특징들을 숫자 데이터로 변환할 수 있습니다. 모델에서 제외할 특징이 있다면 feature_cols를 생성하기 전에 FEATURES 목록에서 하나 이상의 변수를 삭제하면 됩니다.
참고로, 여러분은 다음을 사용하게 될 것입니다. Python 리스트 컴프리헨션을 사용하여 `FEATURES` 리스트를 `feature_cols`라는 새 리스트로 변환합니다. 이렇게 하면 `tf.feature_column.numeric_column()`을 아홉 번 작성하는 것을 피할 수 있습니다. 리스트 컴프리헨션은 새 리스트를 생성하는 더 빠르고 깔끔한 방법입니다.
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
단계 3) 추정량 정의
이 단계에서는 추정기를 정의해야 합니다. TensorFlow는 분류 작업용 3개와 TensorFlow 회귀 작업용 3개를 포함하여 총 6개의 사전 구축된 추정기를 제공합니다.
- 회귀자
- DNNRegressor
- 선형회귀기
- DNNLinearCombinedRegressor
- 분류
- DNN 분류기
- 선형 분류기
- DNNLinearCombinedClassifier
이 자습서에서는 선형 회귀 분석기를 사용합니다. 이 기능에 접근하려면 tf.estimator를 사용해야 합니다.
이 함수에는 두 가지 인수가 필요합니다.
- feature_columns: 모델에 포함할 변수들을 담고 있습니다.
- model_dir: 그래프, 모델 매개변수 등을 저장할 경로
TensorFlow는 작업 디렉터리에 train이라는 폴더를 자동으로 생성합니다. 해당 폴더에 접근하려면 이 경로를 사용해야 합니다. 텐서 보드아래 TensorFlow 회귀 예제에서 볼 수 있듯이.
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
산출
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
TensorFlow에서 가장 까다로운 부분은 모델에 데이터를 입력하는 방식입니다. TensorFlow는 병렬 컴퓨팅과 매우 큰 데이터셋을 처리하도록 설계되었습니다. 하지만 시스템 자원의 한계 때문에 모든 데이터를 한 번에 모델에 입력하는 것은 불가능합니다. 따라서 매번 배치 단위로 데이터를 입력해야 합니다. 특히 수백만 개 이상의 레코드가 포함된 대규모 데이터셋의 경우, 배치 방식으로 입력하지 않으면 메모리 오류가 발생할 수 있습니다.
예를 들어, 데이터에 100개의 관측치가 포함되어 있고 배치 크기를 10으로 정의하면 모델은 각 반복(10*10)에 대해 10개의 관측치를 보게 됩니다.
모델이 모든 데이터를 학습하면 한 에포크가 완료됩니다. 에포크는 모델이 데이터를 학습하는 횟수를 정의합니다. 이 단계를 설정하지 않고 모델이 정해진 횟수만큼 반복 학습을 수행하도록 하는 것이 더 좋습니다.
두 번째로 추가해야 할 정보는 각 반복 전에 데이터를 섞을지 여부입니다. 학습 과정에서 데이터 섞기는 모델이 데이터셋의 특정 패턴을 학습하지 않도록 하는 데 중요합니다. 모델이 데이터의 기본 패턴에 대한 세부 정보를 학습하게 되면, 이전에 보지 못한 데이터에 대한 예측을 일반화하는 데 어려움을 겪게 됩니다. 이를 과적합이라고 합니다. 모델은 학습 데이터에서는 좋은 성능을 보이지만, 이전에 보지 못한 데이터에 대해서는 정확하게 예측하지 못합니다.
TensorFlow를 사용하면 이 두 단계를 쉽게 수행할 수 있습니다. 데이터가 파이프라인에 들어가면 필요한 관측치 수(배치)와 데이터를 섞어야 하는지 여부를 알 수 있습니다.
TensorFlow에 모델에 입력할 데이터를 지정하려면 pandas_input_fn을 사용할 수 있습니다. 이 객체에는 다섯 개의 매개변수가 필요합니다.
- x: 특징 데이터
- y: 라벨 데이터
- 배치_크기: 배치. 기본적으로 128
- num_epoch: 에포크 수, 기본값은 1
- shuffle: 데이터를 섞을지 여부. 기본값은 None입니다.
모델에 여러 번 입력값을 제공해야 하므로, 이 과정을 반복하는 함수를 정의합니다. 이 함수의 이름을 get_input_fn으로 지정하세요.
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
모델의 성능을 평가하는 일반적인 방법은 다음과 같습니다.
- 모델 훈련
- 다른 데이터셋으로 모델을 평가하세요
- 예측을 해보세요
TensorFlow 추정기는 이 세 단계를 쉽게 수행할 수 있는 세 가지 함수를 제공합니다.
단계 4) 모델 훈련
`estimator train` 메서드를 사용하여 모델을 학습시킬 수 있습니다. `train` 메서드는 입력 `input_fn`과 단계 수를 필요로 합니다. 위에서 생성한 함수를 모델에 입력으로 사용할 수 있습니다. 그런 다음 모델이 1000번 반복하도록 지시합니다. 에포크 수는 지정하지 않고, 모델이 1000번 반복하도록 합니다. 만약 에포크 수를 1로 설정하면, 학습 데이터셋에 400개의 레코드가 있고 배치 크기가 128이므로 모델은 4번 반복하게 됩니다.
- 행 128 개
- 행 128 개
- 행 128 개
- 행 16 개
따라서 아래의 TensorFlow 분류 예제에서처럼 에포크 수를 설정하지 않고 반복 횟수를 정의하는 것이 더 쉽습니다.
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
산출
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
다음 명령어를 사용하여 TensorBoard를 확인할 수 있습니다.
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
단계 5) 모델 평가
아래 코드를 사용하여 테스트 세트에서 모델의 적합성을 평가할 수 있습니다.
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
산출
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
아래 코드를 사용하여 손실을 인쇄할 수 있습니다.
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
산출
Loss: 3215.895996
모델의 손실 값은 3215입니다. 요약 통계를 확인하시면 오류의 크기를 가늠하실 수 있습니다.
training_set['medv'].describe()
산출
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
위의 요약 통계에서 알 수 있듯이 주택 평균 가격은 22달러이고, 최저가는 5달러, 최고가는 50달러입니다. 보고된 손실액은 평균 제곱 오차이므로, 원래 단위로 환산한 일반적인 오차는 대략 32.16의 제곱근, 즉 약 5.7달러입니다.
단계 6) 예측을 해보세요
마지막으로, TensorFlow의 predict 메서드를 사용하여 보스턴 주택 6채의 가치를 추정할 수 있습니다.
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
예상값을 출력하려면 다음 코드를 사용하세요.
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
산출
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
해당 모델은 다음과 같은 값을 예측합니다.
| 주택 | 예측 |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
참고로, 우리는 이 여섯 채의 집의 실제 가치를 알지 못합니다. 딥러닝 튜토리얼에서는 선형 모델을 능가하는 성능을 보여드리겠습니다.
넘파이 솔루션
이 섹션에서는 NumPy 추정기를 사용하여 데이터를 입력으로 모델을 학습시키는 방법을 설명합니다. 방법은 동일하지만, numpy_input_fn 추정기를 사용한다는 점만 다릅니다.
세 개의 CSV 파일을 읽되, .values 확장자를 가진 원시 NumPy 배열만 유지합니다.
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
단계 1) 데이터 가져 오기
우선, 특징 변수와 레이블을 구분해야 합니다. 이는 훈련 데이터와 평가 데이터 모두에 대해 수행해야 합니다. 데이터를 분할하는 함수를 정의하는 것이 더 빠릅니다.
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
이 함수를 사용하면 학습 및 평가 데이터 세트에서 레이블과 특징을 분리할 수 있습니다.
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
예측 데이터셋의 마지막 열에는 NaN 값만 포함되어 있으므로 해당 열을 제외해야 합니다.
x_predict = prediction_set_n[:, :-2]
배열의 형태를 확인하세요. 레이블에는 두 번째 차원이 없어야 합니다. 즉, (400,)입니다.
print(X_train.shape, y_train.shape, x_predict.shape)
산출
(400, 9) (400,) (6, 9)
피처 컬럼은 다음과 같이 구성할 수 있습니다.
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
추정기는 이전과 같이 정의됩니다. 특징 열과 그래프를 저장할 위치를 지정합니다.
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
산출
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
NumPy 추정기를 사용하여 모델에 데이터를 입력하고 모델을 학습시킬 수 있습니다. 가독성을 높이기 위해 input_fn 함수를 미리 정의해 두었습니다.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
산출
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
다른 입력 함수를 사용하여 동일한 단계를 반복하여 모델을 평가합니다.
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
산출
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
마지막으로 예측값을 계산할 수 있습니다. 결과는 Pandas를 사용한 결과와 유사할 것입니다.
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
산출
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
텐서플로우 솔루션
마지막 부분은 순수한 것에 바쳐집니다. TensorFlow 해결책입니다. 이 방법은 다른 두 가지 방법보다 약간 더 복잡합니다.
참고로, 만약 사용하신다면 Jupyter 수첩이 세션을 실행하려면 커널을 재시작하고 초기화해야 합니다.
TensorFlow는 파이프라인에 데이터를 전달하는 훌륭한 도구를 제공합니다. 이 섹션에서는 input_fn 함수를 직접 작성해 보겠습니다.
단계 1) 데이터의 경로와 형식을 정의합니다.
우선 CSV 파일의 경로를 저장하는 변수 두 개를 선언합니다. 파일은 학습 데이터셋용 하나와 테스트 데이터셋용 하나, 총 두 개라는 점에 유의하세요.
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
다음으로 CSV 파일에서 사용할 열을 정의해야 합니다. 우리는 모든 열을 사용할 것입니다. 그 후 각 변수의 데이터 유형을 선언해야 합니다.
부동소수점 변수는 [0.]으로 정의됩니다.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
단계 2) input_fn 함수 정의
이 기능은 세 부분으로 나눌 수 있습니다.
- 데이터 가져 오기
- 반복자 만들기
- 데이터 소비
아래는 함수를 정의하는 전체 코드입니다. 코드는 나중에 설명하겠습니다.
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
데이터 가져 오기
CSV 파일의 경우, dataset 메서드는 한 줄씩 읽습니다. 데이터셋을 구축하려면 객체를 사용해야 합니다. TextLine데이터셋. 데이터셋에 헤더가 있으므로 첫 번째 줄을 건너뛰려면 skip(1)을 사용해야 합니다. 이 단계에서는 파이프라인에서 헤더를 제외하고 데이터만 읽습니다. 모델에 입력하려면 레이블에서 특징을 분리해야 합니다. 데이터에 변환을 적용하는 데 사용되는 메서드는 map입니다.
이 메서드는 데이터를 변환하는 방법을 지시하기 위해 사용자가 직접 만들 함수를 호출합니다. 간단히 말하면, 데이터를 해당 함수에 전달해야 합니다. TextLine데이터셋 객체에서 헤더를 제외하고 함수가 지시하는 변환을 적용합니다.
Code 설명
- tf.data.TextLine데이터셋(데이터_파일): 이 줄은 CSV 파일을 읽습니다.
- .skip(1): 헤더를 건너뜁니다
- `.map(parse_csv)`는 레코드를 텐서로 파싱합니다.
맵 객체에 지시할 함수를 정의해야 합니다. 이 함수의 이름을 parse_csv로 지정할 수 있습니다.
이 함수는 `tf.decode_csv` 메서드를 사용하여 CSV 파일을 파싱하고 특징(feature)과 레이블(label)을 선언합니다. 특징은 딕셔너리 또는 튜플로 선언할 수 있습니다. 딕셔너리 방식이 더 편리하기 때문에 이 함수를 사용합니다.
Code 설명
- tf.decode_csv(value, Record_defaults= RECORDS_ALL): decode_csv 메소드는 다음의 출력을 사용합니다. TextLineCSV 파일을 읽을 데이터셋입니다. `record_defaults`는 TensorFlow에 열 유형을 알려줍니다. TensorFlow 2.x에서는 이 심볼이 `tf.io.decode_csv`에 있습니다.
- dict(zip(COLUMNS, columns)): 모든 열로 딕셔너리를 채웁니다. 예:trac이 데이터 처리 과정에서 테드가
- features.pop('medv'): 대상 변수를 특징 변수에서 제외하고 레이블 변수를 생성합니다.
데이터셋에 텐서를 반복적으로 입력하기 위한 추가 요소가 필요합니다. 실제로, 데이터셋이 모델에 무한히 입력될 수 있도록 repeat 메서드를 추가해야 합니다. 이 메서드를 추가하지 않으면 모델은 한 번만 반복 실행된 후 파이프라인에 더 이상 데이터가 입력되지 않아 오류를 발생시킵니다.
그 다음에는 `batch` 메서드를 사용하여 배치 크기를 제어할 수 있습니다. 즉, 각 반복마다 파이프라인에 전달할 데이터의 양을 데이터셋에 지정하는 것입니다. 배치 크기를 크게 설정하면 모델의 속도가 느려집니다.
단계 3) 반복자 만들기
이제 두 번째 단계인 데이터 세트의 요소를 반환하는 반복기를 생성할 준비가 되었습니다.
연산자를 생성하는 가장 간단한 방법은 make_one_shot_iterator 메서드를 사용하는 것입니다.
그런 다음 반복기에서 기능과 레이블을 생성할 수 있습니다.
단계 4) 데이터 소비
input_fn 함수가 어떻게 작동하는지 확인해 보세요. 데이터를 사용하려면 세션 내에서 해당 함수를 호출해야 합니다. 배치 크기를 1로 설정하여 시도해 보세요.
참고로, 특징은 딕셔너리 형태로, 레이블은 배열 형태로 출력됩니다.
CSV 파일의 첫 번째 줄이 표시됩니다. 배치 크기를 다르게 하여 이 코드를 여러 번 실행해 볼 수 있습니다.
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
산출
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
단계 5) 특성 열 정의
숫자 열을 다음과 같이 정의해야 합니다.
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
모든 변수를 하나의 버킷에 결합해야 한다는 점에 유의하세요.
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
단계 6) 모델 구축
추정기 LinearRegressor를 사용하여 모델을 훈련할 수 있습니다.
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
산출
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
당신은 사용해야 합니다 람다 함수 함수 `input_fn`에 대한 인수를 작성할 수 있도록 하기 위함입니다. 람다 함수를 사용하지 않으면 모델을 학습시킬 수 없습니다.
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
산출
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
아래 코드를 사용하여 테스트 세트에서 모델의 적합성을 평가할 수 있습니다.
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
산출
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
마지막 단계는 특징 행렬의 값을 기반으로 목표 변수의 값을 예측하는 것입니다. 예측하려는 값을 담은 딕셔너리를 작성할 수 있습니다. 모델에는 9개의 특징이 있으므로 각 특징에 대한 값을 제공해야 합니다. 모델은 각 특징에 대한 예측값을 제공합니다.
아래 코드에서는 df_predict CSV 파일에 포함된 각 특징의 값을 작성합니다.
데이터셋에 레이블이 없으므로 새로운 input_fn 함수를 작성해야 합니다. Dataset 객체의 from_tensors API를 사용할 수 있습니다.
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
마지막으로 예측 결과를 출력합니다.
for pred in enumerate(pred_results):
print(pred)
산출
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
세 가지 파이프라인 모두 동일한 6개의 예측 결과를 반환하므로, Pandas, NumPy 및 TensorFlow 네이티브 데이터셋 중 하나를 선택하는 것은 정확도의 문제가 아니라 편의성의 문제임을 확인할 수 있습니다.
