
Hadoop 설치 방법 Ubuntu다운로드 및 설치 단계
 프라풀라 라나디베
⚡ 스마트 요약
Apache Hadoop 설치하기 Ubuntu 이 과정은 두 단계로 진행됩니다. 먼저 암호가 필요 없는 SSH를 통해 전용 시스템 계정으로 릴리스 압축을 풀고, HDFS를 포맷하고 단일 노드 클러스터를 시작하기 전에 4개의 XML 파일을 편집합니다.
이 튜토리얼에서는 리눅스 시스템에 아파치 하둡을 설치하는 단계별 과정을 안내해 드리겠습니다.Ubuntu이 과정은 두 단계로 이루어집니다. 먼저 릴리스를 다운로드하고 설치한 다음 구성합니다.
필수 조건은 두 가지입니다.
이 설정에 대한 Hadoop 3.x 버전 참고 사항
이 가이드의 스크린샷은 Hadoop 2.2.0에서 캡처되었습니다. 현재 릴리스에서도 단계 순서는 동일하지만 일부 이름과 기본 설정이 변경되었습니다. 명령어를 그대로 복사하기 전에 아래 표를 확인하십시오.
| 설정 또는 단계 | 이 튜토리얼에서는 (Hadoop 2.x)를 다룹니다. | 현재 Hadoop 3.x 버전 |
|---|---|---|
| 릴리스 아카이브 | hadoop-2.2.0.tar.gz |
hadoop-3.5.0.tar.gz첫 번째 안정 버전인 3.5 릴리스는 2026년 4월 2일에 출시되었습니다. |
| 기본 파일 시스템 속성 | fs.default.name 산문에서, fs.defaultFS XML에서 |
fs.defaultFS 만; fs.default.name 더 이상 사용되지 않습니다 |
| MapReduce 속성 | mapreduce.jobtracker.address |
mapreduce.framework.name 로 설정 yarn; 직업TracYARN이 작업을 예약하면 ker는 더 이상 존재하지 않습니다. |
| mapred-site.xml | 복사 한 곳 mapred-site.xml.template |
배송 중 etc/hadoop 이미 복사했으므로 복사 단계는 불필요합니다. |
| NameNode 웹 UI 포트 | 50070 | 9870 |
| Java | Java 6 또는 Java 7 | Java 8 또는 Java 11 |
이 가이드의 나머지 모든 내용은 Hadoop 3에서도 동일하게 작동합니다. 전용 계정, SSH 키, 4개의 구성 파일, 시작 및 중지 스크립트 모두 마찬가지입니다.
1부) Hadoop 다운로드 및 설치
1단계) 하둡 시스템 사용자 추가
아래 명령어를 사용하여 Hadoop 시스템 사용자를 추가하세요.
sudo addgroup hadoop_

sudo adduser --ingroup hadoop_ hduser_
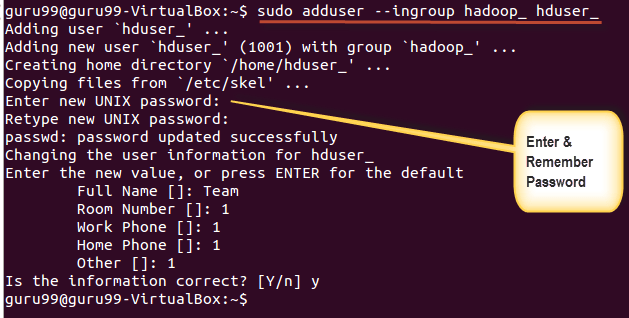
비밀번호, 이름 및 기타 세부 정보를 입력하세요.
알림: 설정 및 설치 과정에서 아래와 같은 오류가 발생할 가능성이 있습니다.
“hduser는 sudoers 파일에 없습니다. 이 사건은 보고될 것입니다.”

루트 사용자로 로그인하면 이 오류를 해결할 수 있습니다.
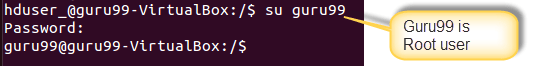
명령을 실행하십시오.
sudo adduser hduser_ sudo

Re-login as hduser_

2단계) SSH 구성
하둡 클러스터에서 노드를 관리하려면 SSH 액세스가 필요합니다.
먼저 사용자를 전환하려면 다음 명령을 입력하세요.
su - hduser_

이 명령은 새 키를 생성합니다.
ssh-keygen -t rsa -P ""

이 키를 사용하여 로컬 시스템에 대한 SSH 액세스를 활성화하십시오.
cat $HOME/.ssh/id_rsa.pub >> $HOME/.ssh/authorized_keys

이제 'hduser_' 사용자로 localhost에 접속하여 SSH 설정이 제대로 되었는지 테스트해 보세요.
ssh localhost

참고 : 'ssh localhost' 명령에 대한 응답으로 아래와 같은 오류가 발생하는 경우, 해당 시스템에서 SSH를 사용할 수 없을 가능성이 있습니다.

이 문제를 해결하려면 –
다음을 사용하여 SSH를 제거합니다.
sudo apt-get purge openssh-server
설치를 시작하기 전에 시스템을 완전히 초기화하는 것이 좋습니다.

다음 명령을 사용하여 SSH를 설치하십시오.
sudo apt-get install openssh-server

3단계) 하둡 다운로드
다음 단계는 Hadoop을 다운로드하는 것입니다. Apache Hadoop 릴리스 페이지.

안정적인 선택

tar.gz 파일을 선택하세요 (src로 끝나는 파일이 아닙니다).

다운로드가 완료되면 tar 파일이 있는 디렉토리로 이동하십시오.

입력
sudo tar xzf hadoop-2.2.0.tar.gz

이제 hadoop-2.2.0의 이름을 hadoop으로 변경하세요.
sudo mv hadoop-2.2.0 hadoop

마지막으로 해당 폴더를 새 계정으로 전달하세요.
sudo chown -R hduser_:hadoop_ hadoop

실제로 다운로드한 버전을 다음으로 바꾸세요. hadoop-2.2.0 위의 세 가지 명령에서.
2부) Hadoop 구성
1단계) ~/.bashrc 파일을 수정합니다.
~/.bashrc 파일의 끝에 다음 줄들을 추가하세요.
#Set HADOOP_HOME
export HADOOP_HOME=<Installation Directory of Hadoop>
#Set JAVA_HOME
export JAVA_HOME=<Installation Directory of Java>
# Add bin/ directory of Hadoop to PATH
export PATH=$PATH:$HADOOP_HOME/bin
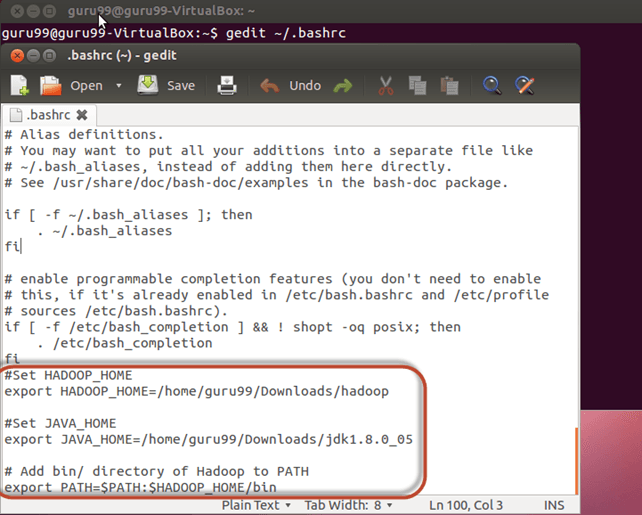
이제 아래 명령어를 사용하여 이 환경 구성을 불러오세요.
. ~/.bashrc

2단계) HDFS 관련 구성
아래와 같이 $HADOOP_HOME/etc/hadoop/hadoop-env.sh 파일에 JAVA_HOME을 설정하십시오.


와

$HADOOP_HOME/etc/hadoop/core-site.xml 파일에는 설정해야 하는 두 가지 매개변수가 있습니다.
1. 'hadoop.tmp.dir' – Hadoop이 데이터 파일을 저장하는 데 사용할 디렉터리를 지정하는 데 사용됩니다.
2. 'fs.defaultFS' – 기본 파일 시스템을 지정합니다. 동일한 속성에 대한 이전 이름인 'fs.default.name'은 더 이상 사용되지 않습니다.
이러한 매개변수를 설정하려면 core-site.xml을 엽니다.
sudo gedit $HADOOP_HOME/etc/hadoop/core-site.xml

아래 줄들을 가운데에 복사하세요 태그.
<property>
<name>hadoop.tmp.dir</name>
<value>/app/hadoop/tmp</value>
<description>Parent directory for other temporary directories.</description>
</property>
<property>
<name>fs.defaultFS </name>
<value>hdfs://localhost:54310</value>
<description>The name of the default file system. </description>
</property>

$HADOOP_HOME/etc/hadoop 디렉토리로 이동하세요.

이제 core-site.xml에 언급된 디렉토리를 생성하세요.
sudo mkdir -p <Path of Directory used in above setting>

디렉터리에 대한 권한을 부여하십시오.
sudo chown -R hduser_:Hadoop_ <Path of Directory created in above step>

sudo chmod 750 <Path of Directory created in above step>

3단계) MapReduce 구성
설정을 시작하기 전에 먼저 HADOOP_HOME 경로를 설정해 보겠습니다.
sudo gedit /etc/profile.d/hadoop.sh
그리고 입력
export HADOOP_HOME=/home/guru99/Downloads/Hadoop

다음 입력
sudo chmod +x /etc/profile.d/hadoop.sh

터미널을 종료하고 다시 시작하세요.
경로를 확인하려면 `echo $HADOOP_HOME`을 입력하세요.

이제 파일을 복사하세요
sudo cp $HADOOP_HOME/etc/hadoop/mapred-site.xml.template $HADOOP_HOME/etc/hadoop/mapred-site.xml

mapred-site.xml 파일을 엽니다.
sudo gedit $HADOOP_HOME/etc/hadoop/mapred-site.xml

아래 설정을 사이에 추가하세요 그리고 태그.
<property>
<name>mapreduce.jobtracker.address</name>
<value>localhost:54311</value>
<description>MapReduce job tracker runs at this host and port.
</description>
</property>

아래와 같이 $HADOOP_HOME/etc/hadoop/hdfs-site.xml 파일을 엽니다.
sudo gedit $HADOOP_HOME/etc/hadoop/hdfs-site.xml

아래 설정을 추가하세요 그리고 태그.
<property>
<name>dfs.replication</name>
<value>1</value>
<description>Default block replication.</description>
</property>
<property>
<name>dfs.datanode.data.dir</name>
<value>/home/hduser_/hdfs</value>
</property>

위 설정에 지정된 디렉터리를 생성합니다.
sudo mkdir -p <Path of Directory used in above setting>
sudo mkdir -p /home/hduser_/hdfs

그런 다음 해당 항목에 대한 소유권과 권한을 부여하십시오.
sudo chown -R hduser_:hadoop_ <Path of Directory created in above step>
sudo chown -R hduser_:hadoop_ /home/hduser_/hdfs

sudo chmod 750 <Path of Directory created in above step>
sudo chmod 750 /home/hduser_/hdfs

4단계) HDFS 포맷
하둡을 처음 시작하기 전에 아래 명령어를 사용하여 HDFS를 포맷하십시오.
$HADOOP_HOME/bin/hdfs namenode -format

5단계) 하둡 단일 노드 클러스터 시작
아래 명령어를 사용하여 하둡 단일 노드 클러스터를 시작하십시오.
$HADOOP_HOME/sbin/start-dfs.sh
위 명령어의 출력 결과는 아래와 같습니다.

그다음 YARN 데몬을 시작하세요.
$HADOOP_HOME/sbin/start-yarn.sh

'jps' 도구를 사용하여 Hadoop 관련 프로세스가 모두 실행 중인지 확인하십시오.
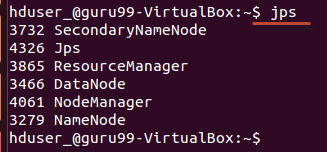
Hadoop이 성공적으로 시작되었다면 jps 출력에는 NameNode, NodeManager, ResourceManager, SecondaryNameNode 및 DataNode가 나열되어야 합니다.
6단계) 정지ping 하둡
클러스터를 역순으로 종료하십시오.
$HADOOP_HOME/sbin/stop-dfs.sh

$HADOOP_HOME/sbin/stop-yarn.sh

하둡이 실행 중인지 확인하고 일반적인 오류를 해결하는 방법
jps 출력은 프로세스가 시작되었음을 확인시켜주지만 클러스터를 사용할 수 있는지 여부는 확인시켜주지 않습니다. 네 가지 추가 검사를 통해 이 문제를 해결할 수 있습니다.
- NameNode 웹 인터페이스를 엽니다.
http://localhost:9870(Hadoop 2.x의 50070 포트)에서 실행 중인 노드가 하나라는 요약 보고서를 확인하십시오. - ResourceManager 인터페이스를 엽니다.
http://localhost:8088YARN이 NodeManager를 수락했는지 확인합니다. - 달리기
hdfs dfsadmin -report용량, 활성 데이터노드 및 복제 부족 블록을 확인합니다. - 글을 써보세요:
hdfs dfs -mkdir /test다음hdfs dfs -ls /네임스페이스가 변경을 허용한다는 것을 증명합니다.
처음 시도에서 실패하는 경우는 대부분 다음 다섯 가지 유형 중 하나에 속합니다.
| 징후 | 원인 | 수정 |
|---|---|---|
| JAVA_HOME이 설정되어 있지 않거나 찾을 수 없습니다. | 해당 변수는 .bashrc 파일에는 내보내지지만 hadoop-env.sh 파일에는 내보내지 않습니다. | hadoop-env.sh 파일 내에서 JDK의 절대 경로를 설정하십시오. |
| ssh localhost에서 권한이 거부되었습니다(공개 키, 암호). | authorized_keys가 없거나 권한이 너무 관대합니다. | id_rsa.pub 파일을 다시 추가한 다음, ~/.ssh/authorized_keys 파일에 대해 chmod 600 명령을 실행하세요. |
| 22번 포트에 대한 연결이 거부되었습니다. | openssh-server가 설치되어 있지 않거나 실행 중이 아닙니다. | openssh-server를 설치하고 ssh 서비스를 시작하세요. |
| 재포맷 후 jps에서 DataNode가 누락되었습니다. | Cluster 포맷된 NameNode와 이전 DataNode 디렉터리 간의 ID 불일치 | dfs.datanode.data.dir 폴더를 비운 다음 다시 포맷하십시오. |
| start-dfs.sh: 명령어를 찾을 수 없습니다 | 현재 셸에서는 HADOOP_HOME과 PATH가 전혀 소싱되지 않았습니다. | `. ~/.bashrc` 파일을 실행하거나 새 터미널을 여세요. |
